Modelos Lineares Generalizados
Quando a resposta é uma probabilidade ou uma contagem
Inferência
Modelos
Modelos para probabilidades, proporções e contagens.
0 A Mesma Pergunta, Uma Resposta Diferente
No capítulo de comparação de modelos começámos com uma ideia muito simples:
\[ \text{Dados}=\text{Modelo}+\text{Erro}. \]
Depois vimos que uma média, um teste-t, uma regressão e uma ANOVA podiam ser formas diferentes de construir e comparar modelos lineares.
Consideremos duas novas perguntas. A probabilidade de um organismo sobreviver é diferente entre duas condições? O número esperado de organismos num quadrado depende do habitat?
As perguntas continuam a pedir diferenças, declives, contrastes e interacções. O problema está na resposta.
Sobrevivência só pode ser 0 ou 1. Uma probabilidade só pode ficar entre 0 e 1. Uma contagem pode ser 0, 1, 2, 3, … mas não -2.7.
Se usarmos uma recta como se nada tivesse mudado, o modelo pode fazer previsões impossíveis. E há uma segunda dificuldade ainda mais importante: nestes dados, a quantidade de variabilidade que esperamos costuma depender da própria média.
Os modelos lineares generalizados, ou GLMs, deixam-nos conservar a parte do modelo que representa a pergunta científica e mudar a forma como representamos a resposta e o erro.
Conservamos, portanto, o preditor linear, mas usamos uma ligação e uma família adequadas à resposta que temos.
Primeiro Exemplo: Sobreviveu ou Não?
Suponhamos que codificamos:
- morreu = 0;
- sobreviveu = 1.
Se 20 de 100 organismos sobreviverem, a média de 0 e 1 é 0.20. Portanto, a média desta variável binária é também uma proporção.
Até aqui tudo parece familiar.
Agora suponhamos que ajustamos simplesmente uma recta. Nada impede essa recta de prever -0.10 num extremo ou 1.08 no outro. O problema não é estético: esses valores não são probabilidades.
Também sabemos que uma variável 0/1 não tem a mesma variabilidade em todo o lado. Quando a probabilidade está muito perto de 0 ou 1, há menos variabilidade possível do que quando está perto de 0.5.
Precisamos então de duas coisas. O modelo tem de respeitar os valores possíveis da resposta e representar a variabilidade própria desse tipo de dados. É isso que a família e a função de ligação acrescentam.
O Que Fica Igual?
Antes da terminologia nova, vale a pena olhar para a parte que não mudou.
O preditor linear continua a ser:
\[ \eta = \beta_0+\beta_1X_1+\beta_2X_2+\beta_3X_1X_2+\ldots \]
Continuamos a combinar interceptos, declives e contrastes de factores, e a representar interacções por produtos. Podemos ainda construir modelos compactos e aumentados para testar as restrições que nos interessam.
Se já percebemos como uma coluna -1/+1 entra num modelo linear, sabemos também como entra no preditor linear de uma regressão logística ou Poisson.
A diferença é que \(\eta\) deixa de ser necessariamente a média da resposta na escala em que a medimos.
1 As Três Peças de um GLM
Um GLM tem três peças que vale a pena distinguir.
O Preditor Linear
Esta é a parte que representa a nossa pergunta:
\[ \eta=X\beta. \]
Não é preciso pensar em matrizes para acompanhar o capítulo. A escrita \(X\beta\) é apenas uma abreviatura para a soma de intercepto, preditores, contrastes e interacções que já conhecemos.
A Família
A família diz que tipo de resposta estamos a representar e como a sua variabilidade se relaciona com a média.
Neste capítulo precisamos sobretudo de duas:
- binomial para respostas 0/1 ou números de sucessos em várias tentativas;
- Poisson para contagens quando a sua relação média–variância é uma aproximação razoável.
Escolher a família é assumir um processo probabilístico para os dados.
Ver o Que a Família Muda
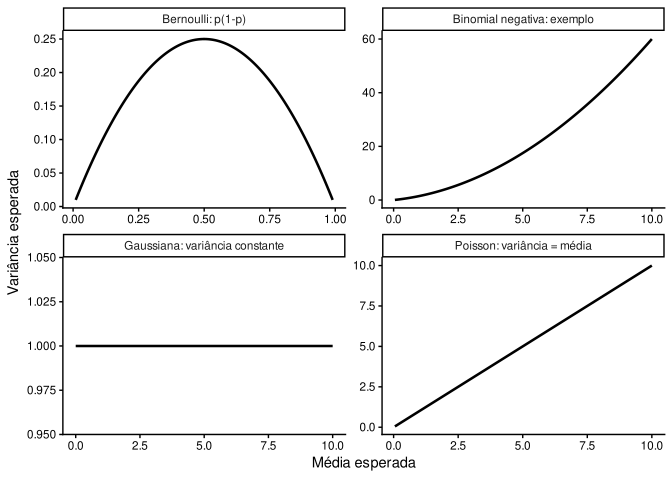
Uma maneira de tornar esta ideia menos abstracta é olhar para a relação entre média e variância. O gráfico seguinte destaca essa relação: famílias diferentes esperam padrões diferentes de variabilidade. É um aspecto fácil de perder quando dizemos apenas «binomial» ou «Poisson».
Na Gaussiana, podemos representar a variância como aproximadamente constante. Numa resposta Bernoulli, a variância é pequena quando a probabilidade está perto de 0 ou 1 e maior perto de 0.5. No Poisson, cresce com a média. Uma binomial negativa permite que cresça ainda mais depressa.
Ao escolher uma família, fazemos assim afirmações sobre os valores que podem aparecer e sobre quanto esperamos que eles variem.
A Ligação
A função de ligação liga a média esperada da resposta, \(\mu\), ao preditor linear:
\[ g(\mu)=\eta. \]
Podemos pensar nela como um tradutor de escalas.
Na escala de \(\eta\), continuamos a poder somar contrastes, declives e interacções. A ligação inversa traduz depois essa quantidade para uma probabilidade ou uma contagem esperada que faça sentido.
NotaA Definição Geral
Formalmente, um GLM combina uma distribuição da família exponencial, um preditor linear \(\eta=X\beta\) e uma função de ligação que relaciona a média condicional da resposta com esse preditor.
É esta estrutura que permite tratar binomial, Poisson e outras famílias com a mesma linguagem geral. O tratamento clássico é McCullagh & Nelder (1989).
2 Respostas Binárias
Binomial: Probabilidades Entre 0 e 1
Na regressão logística, a ligação habitual é o logit:
\[ \log\left(\frac{p}{1-p}\right)=\eta. \]
Se esta expressão parece hostil, podemos começar pela função inversa:
\[ p=\frac{1}{1+e^{-\eta}}. \]
\(\eta\) pode ir de menos infinito a mais infinito. Depois da transformação, a previsão \(p\) fica sempre entre 0 e 1.
É esse o trabalho essencial da ligação logística.
NotaDois Exemplos da Psicologia
Memória. Num ensaio de reconhecimento, a resposta pode ser codificada como correcta = 1 e incorrecta = 0. Um GLM binomial pode perguntar se a probabilidade de acertar muda com o atraso, a condição experimental ou a idade.
Controlo inibitório. Numa tarefa go/no-go, podemos codificar cada resposta como correcta = 1 e incorrecta = 0 e perguntar se a probabilidade de acertar muda com a fadiga ou com o tempo na tarefa. Para modelar directamente a probabilidade de erro, invertemos a codificação.
Há, porém, uma pergunta diferente. Num teste de reconhecimento, duas pessoas podem ter a mesma percentagem de acertos e tendências muito diferentes para responder «sim, já vi». Quando queremos separar sensibilidade de critério de resposta, entramos na Teoria da Detecção de Sinal.
Os Contrastes Continuam Iguais
Suponhamos duas condições codificadas como -1 e +1:
| Condição | \(X\) |
|---|---|
| A | -1 |
| B | +1 |
O preditor linear é:
\[ \eta=\beta_0+\beta_1X. \]
Substituímos os dois valores exactamente como fizemos no modelo linear.
Para A:
\[ \eta_A=\beta_0-\beta_1. \]
Para B:
\[ \eta_B=\beta_0+\beta_1. \]
Logo,
\[ \eta_B-\eta_A=2\beta_1. \]
A estrutura do contraste não mudou. O que mudou foi a escala em que essa diferença vive.
Num modelo Gaussiano com ligação identidade, esta diferença podia estar directamente em gramas, milissegundos ou outra unidade da resposta.
Na regressão logística, ela está em log-odds. Depois traduzimos as duas previsões para probabilidades para responder à pergunta substantiva.
NotaComparação e Escala
É por isso que vale a pena separar duas tarefas:
- o contraste diz que comparação estamos a fazer;
- a ligação diz em que escala o modelo a representa.
Odds Sem Misticismo
As odds são apenas outra maneira de escrever uma probabilidade:
\[ odds=\frac{p}{1-p}. \]
Se \(p=0.5\), as odds são 1: há uma possibilidade de sucesso por cada possibilidade de insucesso.
Se \(p=0.8\),
\[ odds=\frac{0.8}{0.2}=4. \]
Há quatro sucessos esperados por cada insucesso, na linguagem das odds.
Um coeficiente logístico é uma mudança em log-odds por uma unidade do preditor. Se o exponenciarmos, obtemos a razão de odds correspondente a essa mudança de uma unidade:
\[ OR=e^\beta. \]
A codificação importa. No contraste -1/+1 que acabámos de usar, passar do grupo A (-1) para o grupo B (+1) é uma mudança de duas unidades. Portanto, a razão de odds B/A é
\[ OR_{B/A}=e^{2\beta_1}. \]
Isto é exactamente paralelo ao facto de a diferença B - A ser \(2\beta_1\) na escala do preditor linear.
Uma razão de odds de 2 não quer dizer «mais 2 pontos percentuais» nem «o dobro da probabilidade». Por isso, mesmo quando reportamos odds ratios, costuma ser útil mostrar também probabilidades previstas.
NotaPorque o Logit?
O logit transforma o intervalo aberto \(0<p<1\) em toda a recta real. Além disso, uma diferença aditiva em log-odds corresponde a uma razão multiplicativa de odds.
Existem outras ligações binomiais, como probit e complementary log-log. A logística é muito usada porque a transformação é conveniente, simétrica e produz odds ratios com uma interpretação estabelecida. Não é a única ligação matematicamente possível.
Interacções Continuam a Ser Produtos
Com dois factores A e B codificados como -1/+1, o preditor linear escreve-se:
\[ \eta = \beta_0+\beta_AA+\beta_BB+\beta_{AB}AB. \]
A coluna da interacção continua a ser o produto das outras duas.
| A | B | \(AB\) |
|---|---|---|
| -1 | -1 | +1 |
| +1 | -1 | -1 |
| -1 | +1 | -1 |
| +1 | +1 | +1 |
E \(\beta_{AB}\) continua a representar uma diferença de diferenças na escala do preditor linear.
Com esta codificação,
\[ 4\beta_{AB} \]
corresponde à diferença de diferenças em \(\eta\).
A novidade é importante: numa regressão logística, essa diferença de diferenças é em log-odds, não necessariamente em probabilidades.
Duas linhas que parecem ter uma interacção forte na escala da probabilidade podem ter outro aspecto na escala logit, e vice-versa. Portanto, depois de testar a interacção, precisamos de olhar também para as previsões na escala da resposta.
E Se Mudarmos a Ligação?
A ligação faz uma afirmação sobre a forma da relação entre o preditor linear e a média da resposta.
No binomial, logit, probit e complementary log-log produzem curvas diferentes. Isso pode mudar previsões, sobretudo em zonas extremas, e muda a interpretação dos coeficientes.
Podemos vê-lo mantendo a mesma família binomial e mudando apenas a ligação. Cada curva abaixo traduz o mesmo valor de \(\eta\) para uma probabilidade de forma ligeiramente diferente.
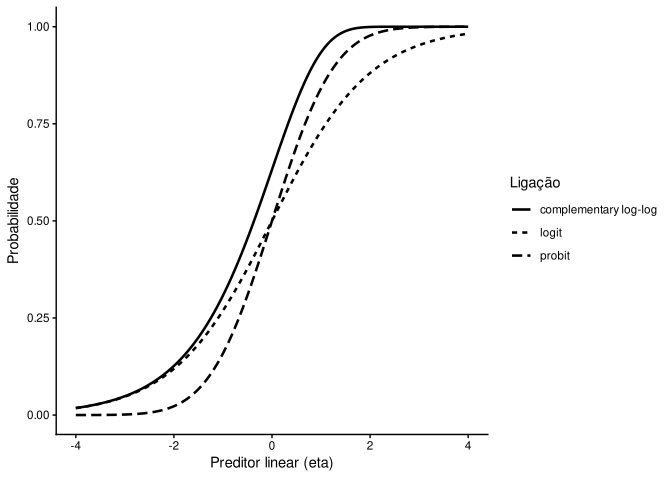
A família ficou igual: continuamos a modelar uma resposta binária. O que mudou foi o tradutor entre o preditor linear e a probabilidade. É por isso que família e ligação são decisões diferentes.
A escolha da ligação também não é uma caça ao valor-p que queríamos. A pergunta útil é qual ligação representa de forma plausível a relação que esperamos e que sinais nos dados indicam que essa representação está a falhar.
Para a maioria dos primeiros problemas binários, o logit é um ponto de partida natural. O importante é perceber o que ele está a fazer.
3 Probabilidades Condicionais e Marginais
Que probabilidade queremos comunicar quando organismos partilham tanques? Num GLM binomial ordinário, \(h(\eta)\), com \(h=\operatorname{logit}^{-1}\), já é a probabilidade média condicional aos preditores. Não modelámos o logit de cada resposta como uma variável com erro Gaussiano aditivo. Por isso, a não linearidade não justifica aplicar uma correcção de retransformação a esse GLM. Esta distinção entre transformar a resposta e usar uma ligação é explícita na documentação de emmeans.
Num GLMM com intercepto aleatório de tanque, a história é outra:
\[ Y_{ij}\mid b_j\sim\operatorname{Binomial}(n_{ij},p_{ij}),\qquad p_{ij}=h(\eta_{ij}+b_j),\qquad b_j\sim N(0,\sigma_b^2). \]
Aqui \(j\) identifica o tanque, \(i\) a observação nesse tanque, \(n_{ij}\) o número de tentativas e \(\eta_{ij}=x_{ij}^{\mathsf T}\beta\) a contribuição dos efeitos fixos. A previsão \(h(\eta_{ij})\) fixa \(b_j=0\). É a previsão para o centro da distribuição dos tanques na escala logit, não a probabilidade média entre tanques. Não é também uma previsão condicionada ao efeito estimado de um tanque já observado. Para uma unidade sorteada da população de tanques representada pelo modelo, a probabilidade marginal é
\[ \bar p_{ij}=E_b[h(\eta_{ij}+b)] =\int_{-\infty}^{\infty}h(\eta_{ij}+\sigma_b z)\phi(z)\,dz, \]
onde \(\phi\) é a densidade normal padrão. Em geral, \(E_b[h(\eta+b)]\ne h(\eta+E[b])=h(\eta)\). Os valores de emmeans sem ajuste usam a segunda quantidade. O tutorial com afex::mixed() compara as duas, por condição, sem mudar o modelo ajustado.
O Que Aproxima bias.adjust?
Ao pedir type = "response", bias.adjust = TRUE, sigma = ..., emmeans acrescenta um termo de Taylor de segunda ordem. Com \(p_0=h(\eta)\) e \(\sigma\) igual ao desvio-padrão da contribuição aleatória que queremos integrar, temos
\[ \bar p\approx h(\eta)+\frac{\sigma^2}{2}h''(\eta) =p_0+\frac{\sigma^2}{2}p_0(1-p_0)(1-2p_0). \]
É uma aproximação à marginalização, não uma correcção geral do viés dos coeficientes estimados, nem um ajuste por comparações múltiplas (adjust). O exemplo CBPP mostra a construção de sigma a partir de efeitos aleatórios. Num binomial com apenas intercepto aleatório, usamos \(\sigma=\sigma_b\), não a dispersão binomial, o erro-padrão da previsão ou uma variância residual logística latente.
Onde Muda Mais e Onde Falha?
A mudança depende simultaneamente da posição na curva e da variância. Para variância pequena, Taylor acompanha bem a integração. A sua mudança absoluta é máxima perto de \(p_0=(3\pm\sqrt{3})/6\), aproximadamente .211 e .789, e não em .5. A localização do máximo exacto muda com a variância. Em .5, a mudança é exactamente zero para efeitos normais centrados, por simetria. Para qualquer variância finita fixa, também tende a zero em termos absolutos quando \(\eta\) vai para os extremos; diferenças relativas podem continuar a importar em eventos raros.
O gráfico varia o desvio-padrão na escala logit, mantendo o mesmo modelo probabilístico. No painel com desvio-padrão 5, Taylor chega a dar valores fora de [0, 1]. Não escondemos esse erro limitando o eixo às probabilidades válidas.
Código
bias_shape <- expand.grid(
  eta = seq(-10, 10, length.out = 401), sd_re = c(0, 0.2, 0.7, 5)
)
bias_shape$p_zero <- plogis(bias_shape$eta)
bias_shape$p_marginal <- mapply(function(eta, sd_re) {
  integrate(function(z) plogis(eta + sd_re * z) * dnorm(z),
            -Inf, Inf, rel.tol = 1e-10)$value
}, bias_shape$eta, bias_shape$sd_re)
bias_shape$p_taylor <- with(bias_shape,
  p_zero + sd_re^2 / 2 * p_zero * (1 - p_zero) * (1 - 2 * p_zero)
)
bias_shape$panel <- factor(paste("Random-effect SD =", bias_shape$sd_re),
                          levels = paste("Random-effect SD =", c(0, 0.2, 0.7, 5)))
bias_lines <- rbind(
  data.frame(bias_shape, method = "Numerical integration",
             shift = bias_shape$p_marginal - bias_shape$p_zero),
  data.frame(bias_shape, method = "Taylor",
             shift = bias_shape$p_taylor - bias_shape$p_zero)
)
ggplot2::ggplot(bias_lines,
               ggplot2::aes(p_zero, shift, colour = method, linetype = method)) +
  ggplot2::geom_hline(yintercept = 0, colour = "grey70") +
  ggplot2::geom_vline(xintercept = c((3 - sqrt(3)) / 6, (3 + sqrt(3)) / 6),
                      colour = "grey70", linetype = "dotted") +
  ggplot2::geom_line(linewidth = 0.8) +
  ggplot2::facet_wrap(~ panel, scales = "free_y") +
  ggplot2::theme_classic() +
  ggplot2::labs(x = "Probability at zero random effect",
                y = "Change in probability", colour = "Method", linetype = "Method")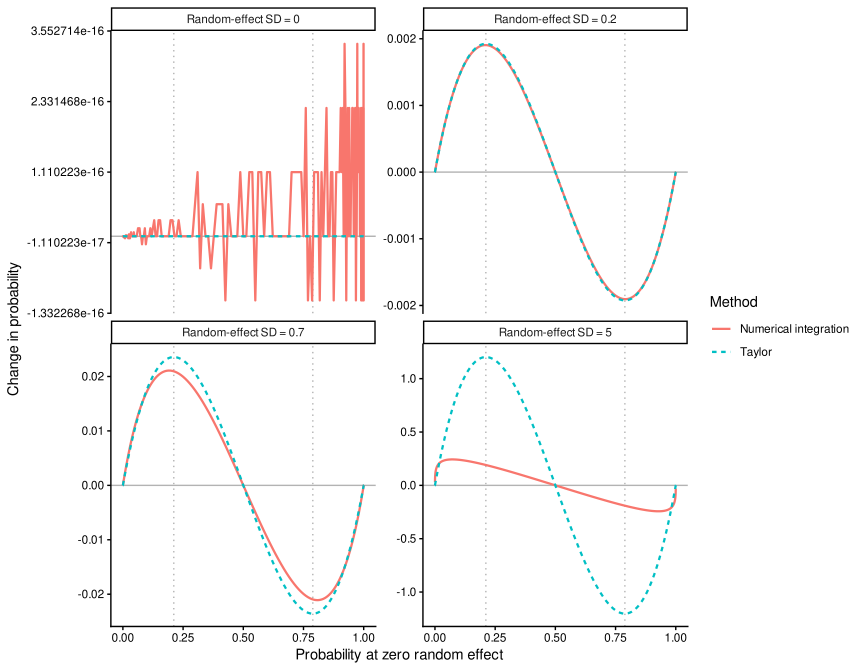
As linhas verticais marcam os máximos absolutos do termo de Taylor. Repare nas escalas verticais diferentes: os painéis permitem ver tanto o pequeno erro com desvio-padrão .2 como a falha com desvio-padrão 5. A integração normal aproxima sempre a probabilidade de .5; Taylor pode atravessar .5 indevidamente e até sair do intervalo possível. Não há um limiar universal de variância que garanta precisão: compare a aproximação com integração no intervalo relevante para a análise. A ajuda de summary.emmGrid adverte que a correcção é apenas um termo, multiplicado pela variância.
Duas Operações de Média
Integrar efeitos aleatórios não é fazer uma média sobre níveis de factores fixos. Se \(k\) identifica células da grelha e \(w_k\) os pesos escolhidos, com \(\sum_k w_k=1\), distinguimos três alvos:
\[ h\!\left(\sum_k w_k\eta_k\right),\qquad \sum_k w_k h(\eta_k),\qquad \sum_k w_k E_b[h(\eta_k+z_k^{\mathsf T}b)]. \]
O primeiro corresponde ao procedimento habitual de emmeans(..., type = "response"): faz a média na escala da ligação e só depois transforma. O segundo corresponde a emmeans(..., regrid = "response"): transforma a grelha antes da média. O terceiro integra a distribuição aleatória em cada célula antes de aplicar os pesos. O nome «média marginal estimada» não garante que o software calculou este terceiro alvo. O exemplo prático e a documentação sobre regridding ajudam a reconhecer a diferença.
NotaDeclives Aleatórios e Incerteza
Com intercepto e declive aleatórios, \(b=(b_0,b_1)^{\mathsf T}\sim N(0,G)\), a contribuição aleatória em \(x\) é \(b_0+xb_1\). A variância a integrar é
\[ \sigma^2(x)=z(x)^{\mathsf T}Gz(x) =\operatorname{Var}(b_0)+2x\operatorname{Cov}(b_0,b_1) +x^2\operatorname{Var}(b_1),\quad z(x)=(1,x)^{\mathsf T}. \]
A covariância não pode ser omitida. Para um modelo fit com (1 + x | tank) e uma grelha emm por célula, o padrão de cálculo é:
O vector segue a ordem efectiva de emm@grid, não uma ordem presumida dos níveis. Isto ilustra apenas este intercepto e declive numérico; estruturas mais complexas exigem construir a matriz correspondente ao modelo. Somamos variâncias de componentes independentes que pretendemos integrar, não os seus desvios-padrão. O exemplo oficial com declives aleatórios é um modelo Gaussiano de resposta transformada: não devemos copiar o seu termo de variância residual para um GLMM binomial.
Tanto a quadratura com \(\hat G\) como Taylor com sigma_grid fornecido usam estimativas plug-in. A quadratura resolve a integração, não a incerteza em \(\hat\beta\) e \(\hat G\). Os intervalos ajustados de emmeans não incluem automaticamente a incerteza de \(\hat G\); com variância grande, a transformação de Taylor pode ainda deixar de ser monótona. Para intervalos marginais, um bootstrap paramétrico deve reajustar o modelo e voltar a integrar em cada réplica, verificando também problemas de convergência.
4 Contagens e Taxas
Poisson: Respostas de Contagem
Agora mudemos a pergunta. Quantos organismos esperamos encontrar num quadrado, e esse número depende do habitat?
Uma contagem não pode ser negativa. Por isso, um modelo Poisson usa habitualmente a ligação log:
\[ \log(\mu)=\eta. \]
Voltando à escala da resposta:
\[ \mu=e^\eta. \]
Como \(e^\eta\) é sempre positivo, a contagem média prevista também é.
A Interpretação Torna-se Multiplicativa
Consideremos um preditor quantitativo:
\[ \eta=\beta_0+\beta_1X. \]
Aumentar \(X\) uma unidade acrescenta \(\beta_1\) ao log da média.
Na escala original, isso significa multiplicar a média esperada por:
\[ e^{\beta_1}. \]
Se
\[ e^{\beta_1}=2, \]
a contagem esperada duplica.
Se
\[ e^{\beta_1}=0.8, \]
a contagem esperada passa para 80% do valor anterior.
Uma palavra importante aqui é factor multiplicativo. Em inglês, esta interpretação é frequentemente descrita como multiplicative change. Quando comparamos duas médias previstas, podemos também falar numa mean ratio, uma razão entre médias esperadas:
\[ \frac{\mu(X+1)}{\mu(X)}=e^{\beta_1}. \]
Não é, em geral, uma rate of change: essa expressão sugere uma velocidade de mudança ou uma derivada. \(e^{\beta_1}\) diz por que factor a média esperada é multiplicada quando \(X\) aumenta uma unidade. Só quando a resposta representa uma taxa por unidade de exposição, como veremos no offset, faz sentido falar numa rate ratio, ou razão de taxas.
O efeito também se vê melhor do que se lê. Se \(e^{\beta_1}=1.5\), cada passo de uma unidade em \(X\) multiplica a média anterior por 1.5:
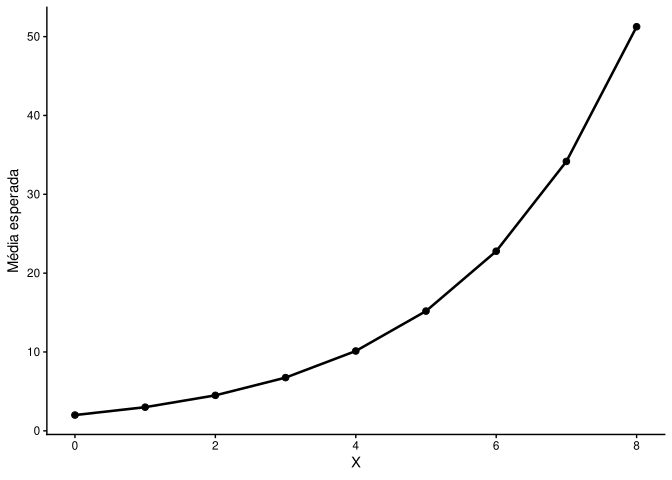
Na escala do logaritmo, os passos são aditivos. Na escala da resposta, tornam-se multiplicativos. É esta tradução que produz a curva.
Não é uma nova lógica de regressão. É o mesmo declive, traduzido através de uma ligação diferente.
Família Também Quer Dizer Variância
Esta é a parte que convém não perder atrás das palavras «binomial» e «Poisson».
Num modelo Poisson simples:
\[ Var(Y\mid X)=E(Y\mid X)=\mu. \]
Isto significa que, quando a média aumenta, a variabilidade esperada também aumenta.
Uma zona onde esperamos 100 organismos pode variar muito mais, em números absolutos, do que uma zona onde esperamos 2.
No binomial, a variância depende da probabilidade e do número de tentativas.
Por isso, escolher uma família não decide apenas que valores o modelo pode prever. Decide também quanto erro o modelo espera encontrar em diferentes partes da escala.
E isso afecta erros-padrão, intervalos de confiança e testes.
Sobredispersão: Primeiro Perguntar Porquê
Num Poisson simples, a variância esperada está presa à média. Dizemos que há sobredispersão quando os dados apresentam mais variabilidade do que essa estrutura prevê.
Mas «há sobredispersão» ainda não é um diagnóstico substantivo.
Pode acontecer porque:
- falta um preditor importante;
- a relação média–preditor está mal especificada;
- há observações repetidas da mesma unidade;
- locais ou organismos diferem entre si de uma forma não representada;
- a exposição varia;
- há uma estrutura de contagens mais variável do que o Poisson;
- os zeros podem nascer de um processo adicional.
Essas histórias pedem soluções diferentes.
Se a causa é dependência dentro de tanques, trocar Poisson por uma distribuição mais flexível não cria tanques independentes.
Se a causa é heterogeneidade de contagens que cresce mais depressa do que a média, uma binomial negativa pode ser uma representação mais adequada.
Se a causa é uma variável explicativa em falta, talvez o primeiro passo seja melhorar o modelo da média.
AvisoInvestigar a Sobredispersão
A sequência «Poisson → detectei sobredispersão → binomial negativa» pode ser uma boa decisão em alguns problemas. Não é uma regra universal.
O diagnóstico útil pergunta que processo poderia produzir a variabilidade extra. A mudança de modelo deve responder a essa história.
Alternativas Comuns
NotaAlgumas Respostas Possíveis
Binomial negativa: acrescenta um parâmetro de dispersão e permite uma relação média–variância mais flexível.
Quasi-Poisson: mantém a estrutura da média do Poisson e introduz um parâmetro de escala para a variância. Como não define a mesma verosimilhança completa, não entra da mesma forma em comparações por AIC.
Efeito aleatório: representa heterogeneidade ou dependência partilhada por uma unidade de agrupamento.
Modelos com processo extra de zeros: representam explicitamente uma estrutura adicional para produzir zeros. Devem ser usados quando essa história faz sentido para o processo, não apenas porque o histograma tem muitos zeros.
Contagem ou Taxa?
Imaginemos dois transectos: num deles observámos durante 1 hora, no outro durante 10 horas.
Se ambos tiverem 12 avistamentos, têm a mesma contagem, mas claramente não a mesma taxa de avistamentos.
Num modelo Poisson com ligação log podemos incluir uma exposição \(E_i\):
\[ \log(\mu_i) = \eta_i+\log(E_i). \]
O termo \(\log(E_i)\) entra como offset, com coeficiente fixado em 1.
Em R, a estrutura seria:
Sem o offset, perguntamos por contagens totais. Com ele, perguntamos por uma taxa por unidade de exposição. A exposição faz parte da pergunta científica: comparar 12 avistamentos em 1 hora com 12 em 10 horas exige tê-la em conta.
5 Inferência e Diagnóstico
Comparar Modelos Outra Vez
No modelo linear, comparámos modelos perguntando quanto diminuía o erro quadrático.
Num GLM continuamos a poder construir:
- um modelo compacto, que impõe a restrição de \(H_0\);
- um modelo aumentado, que liberta o parâmetro ou conjunto de parâmetros que representa a alternativa.
A medida de ajuste já não é simplesmente o SSE. A família dá-nos uma verosimilhança: uma medida de quão compatíveis são os dados observados com um conjunto de parâmetros dentro daquele modelo probabilístico.
A deviance traduz essa informação para uma escala conveniente. Para modelos aninhados, uma redução de deviance significa que o modelo aumentado se ajusta melhor.
Podemos resumir a comparação como:
\[ \Delta D=D_{compacto}-D_{aumentado}. \]
Quanto maior a redução, mais o modelo aumentado ganhou ao libertar a restrição.
Em muitos GLMs, sob condições regulares, comparamos \(\Delta D\) com uma distribuição qui-quadrado.
O valor-p mantém a interpretação que introduzimos em Do t ao Valor-p. Aqui mudou a estatística de teste. Usamos a melhoria de verosimilhança em vez de um t ou um F Gaussiano. A lógica da inferência é a mesma.
NotaVerosimilhança e Deviance
Se \(L(\theta)\) é a verosimilhança e \(\ell(\theta)=\log L(\theta)\), o teste de razão de verosimilhanças para dois modelos aninhados usa
\[ 2\left[ \ell(\hat\theta_A)-\ell(\hat\theta_C) \right]. \]
Sob condições regulares, esta quantidade tem aproximadamente uma distribuição \(\chi^2\), com graus de liberdade iguais à diferença no número de parâmetros.
A deviance é definida por comparação com um modelo saturado e, para esta comparação aninhada, a diferença de deviances corresponde à mesma estatística de razão de verosimilhanças.
A aproximação qui-quadrado tem condições; não é uma licença para comparar quaisquer dois modelos de qualquer forma.
Como o Computador Ajusta um GLM?
Esta parte é importante para quem quer perceber a computação, mas não para interpretar o primeiro modelo.
NotaMáxima Verosimilhança e IRLS
No modelo linear Gaussiano, os mínimos quadrados levam a uma solução fechada para os coeficientes quando a matriz do modelo tem posto completo.
Num GLM, em geral, não existe uma fórmula única que resolva directamente \(\hat\beta\). O computador escolhe os coeficientes que maximizam a verosimilhança.
Uma estratégia clássica é iteratively reweighted least squares (IRLS), intimamente relacionada com Newton–Raphson/Fisher scoring. Em cada iteração, o problema é aproximado por um problema de mínimos quadrados ponderados; os pesos e a resposta de trabalho são actualizados até o algoritmo convergir.
Esta maquinaria explica como glm() encontra as estimativas. Não muda o que um contraste -1/+1, um declive ou uma interacção significam.
Contrastes e Tipo III Continuam Cá
A parte \(X\beta\) continua a ser um modelo linear. Portanto, a discussão sobre contrastes e Tipo III continua relevante.
Se A e B estão codificados com contrastes centrados e o modelo contém A × B, podemos continuar a perguntar:
- diferença média associada a A, mantendo os restantes termos no modelo;
- diferença média associada a B;
- diferença de diferenças A × B.
A diferença é que estes efeitos são definidos primeiro na escala da ligação.
Por isso, uma boa análise não termina na tabela omnibus. Depois do teste, voltamos à escala que interessa:
- probabilidades;
- diferenças de probabilidades;
- contagens esperadas;
- razões entre médias esperadas;
- razões de taxas, quando existe uma exposição que define uma taxa;
- gráficos de previsões.
É aí que vemos o tamanho e a direcção substantiva do efeito.
Diagnóstico
Num GLM, dizer «o modelo não se ajusta bem aos dados» é demasiado vago para sabermos o que mudar. As perguntas seguintes ajudam-nos a localizar o problema.
Média: falta curvatura, um preditor ou uma interacção?
Variância/família: os dados variam como a família prevê?
Ligação: a forma que liga os preditores à média parece plausível?
Dependência: várias linhas vêm do mesmo animal, local, tanque ou participante?
Exposição: algumas unidades tiveram mais oportunidade de produzir eventos?
Influência: algumas observações estão a determinar quase sozinhas o resultado?
Binomial: há separação ou previsões extremas sustentadas por poucos casos?
Contagens: a sobredispersão ou os zeros sugerem um processo que o modelo não representa?
Cada pergunta aponta para uma modificação diferente. O diagnóstico ajuda-nos a descobrir que afirmação do modelo deixou de ser plausível e a decidir como responder ao problema. Um aviso do software deve levar a essa investigação.
6 Escolher e Ler o Modelo
Um Mapa Para Escolher
| Se a resposta é… | Um primeiro modelo possível | O que estamos a modelar |
|---|---|---|
| contínua aproximadamente Gaussiana | modelo linear | média na escala original |
| 0/1 | binomial + logit | probabilidade, via log-odds |
| sucessos em \(n\) tentativas | binomial + logit | proporção/probabilidade |
| contagem | Poisson + log | contagem média |
| contagem por exposição | Poisson + log + offset | taxa |
| contagem com variância extra plausível | talvez binomial negativa | média com dispersão adicional |
A tabela é um ponto de partida, não uma árvore de decisão automática.
Um Fluxo de Leitura
Ao ler um GLM num artigo ou ao escolher um modelo, podemos seguir estas perguntas:
- Qual é a pergunta de investigação?
- O que representa uma linha?
- Que valores pode assumir a resposta?
- Como esperamos que a variabilidade mude com a média?
- Que contraste, declive ou interacção representa a hipótese?
- Que ligação transforma a escala da resposta numa escala onde esses efeitos se possam combinar?
- Há exposição diferente entre observações?
- Há dependência ou agrupamento?
- O que dizem as previsões quando voltamos à escala da resposta?
- Se o diagnóstico falhar, que parte da história precisa realmente de mudar?
As respostas permitem interpretar o modelo e justificar a escolha, para além de saber chamar glm().
7 Síntese
Os GLMs parecem trazer muita terminologia nova, mas a espinha dorsal é a mesma.
A pergunta científica continua a ser representada por:
\[ \eta=X\beta. \]
É aí que continuam os contrastes -1/+1, os declives, os produtos que criam interacções e os modelos compactos e aumentados.
A família diz que tipo de resposta e de variabilidade estamos preparados para observar.
A ligação cria uma escala onde o preditor linear pode trabalhar sem produzir probabilidades ou médias impossíveis.
A comparação de modelos continua a perguntar o que ganhámos ao libertar uma restrição. A interpretação do valor-p é a mesma que já aprendemos no capítulo anterior.
Não precisamos de reaprender «uma nova estatística para cada caso». Precisamos de aprender a perguntar que parte da história dos dados mudou e que peça do modelo deve mudar com ela.
8 Exercícios
Tentem resolver cada exercício antes de abrir a caixa. A estrutura da comparação de modelos é familiar. O que muda é a distribuição que esperamos para a resposta.
- Uma resposta 0/1 tem média 0.30. Explique por que essa média também pode ser lida como uma proporção.
Solução 1 — Zeros, Uns e Proporções
Somar uma variável codificada 0/1 é contar quantas observações têm valor 1. Dividir pelo número de observações dá simultaneamente a média e a proporção de respostas 1. Assim, uma média observada de 0.30 corresponde a 30% de respostas 1. Para a interpretar como uma probabilidade aplicável a outras observações, precisamos de justificar o modelo e a inferência.
- Dois grupos estão codificados -1/+1 num modelo logístico. Derive \(\eta_A\), \(\eta_B\) e mostre por que a diferença é \(2\beta_1\).
Solução 2 — Contrastes no Modelo Logístico
Se \(\eta=\beta_0+\beta_1 x\), com A = -1 e B = +1, temos
$ _A=_0-_1, _B=_0+_1. $
Subtrair dá \(\eta_B-\eta_A=2\beta_1\). Esta diferença está na escala das log-odds. A razão de odds de B para A é \(e^{2\beta_1}\). Para obter probabilidades, ainda temos de aplicar a função logística a cada previsão. Não podemos interpretar \(\beta_1\) directamente como uma diferença de pontos percentuais.
- Num 2 × 2 com contrastes -1/+1, construa a coluna produto A × B e explique por que a interacção continua a ser uma diferença de diferenças.
Solução 3 — A Interacção É um Produto
Com os dois factores codificados -1/+1, a coluna A × B é:
| A | B | A × B |
|---|---|---|
| -1 | -1 | +1 |
| -1 | +1 | -1 |
| +1 | -1 | -1 |
| +1 | +1 | +1 |
No modelo \(\eta=\beta_0+\beta_A A+\beta_B B+\beta_{AB}AB\), a diferença entre A = +1 e A = -1 para B = \(b\) é \(2(\beta_A+\beta_{AB}b)\). Comparar esta diferença nos dois valores de B dá \(4\beta_{AB}\). Continuamos a estudar diferenças de diferenças, agora na escala de log-odds.
- Explique por que uma diferença constante em log-odds não implica uma diferença constante em pontos percentuais.
Solução 4 — Log-Odds e Probabilidades
O mesmo acréscimo nas log-odds multiplica as odds pelo mesmo factor, mas não produz o mesmo aumento na probabilidade. Duplicar as odds a partir de uma probabilidade de .10 leva-nos a cerca de .182, um aumento de 8.2 pontos percentuais. Partindo de .50, a mesma duplicação leva-nos a aproximadamente .667, um aumento de 16.7 pontos. É a transformação logística que explica a diferença.
- Num Poisson, \(e^\beta=1.5\). Escreva a interpretação na escala da contagem esperada.
Solução 5 — O Efeito Poisson
Com ligação logarítmica, \(e^\beta=1.5\) significa que um aumento de uma unidade no preditor multiplica por 1.5 a contagem média esperada, mantendo constantes os restantes preditores. Corresponde a um aumento de 50% na média prevista, não a um aumento garantido de 50% em cada contagem observada.
- Dois locais tiveram 12 avistamentos; um foi observado 2 horas e outro 12. Explique a diferença entre modelar contagem e modelar taxa.
Solução 6 — Contagem ou Taxa?
Doze avistamentos em duas horas são 6 por hora. Doze em doze horas são 1 por hora. A contagem é igual, mas a taxa é diferente porque a exposição não foi a mesma.
Num modelo Poisson de taxas, podemos incluir o logaritmo das horas de observação como offset, cujo coeficiente é fixado em 1. Estamos então a modelar a taxa, respeitando o tempo diferente dedicado a cada local. Isto exige que o tempo seja uma medida adequada de exposição.
- Um Poisson apresenta forte sobredispersão. Dê três processos diferentes que a poderiam produzir e diga que mudança de modelo investigaria em cada caso.
Solução 7 — Três Fontes de Sobredispersão
Podemos investigar mecanismos distintos:
- Heterogeneidade não explicada: alguns locais têm médias diferentes, mesmo depois dos preditores incluídos. Podemos acrescentar variáveis relevantes e considerar uma binomial negativa para a dispersão residual.
- Observações dependentes: várias contagens vêm do mesmo tanque ou local. Devemos representar a estrutura de agrupamento, por exemplo através de efeitos aleatórios.
- Zeros de outro processo: alguns locais podem não permitir qualquer avistamento. Se houver razões substantivas para isso, investigamos uma componente própria para zeros.
Antes de trocar a família, vale a pena regressar ao delineamento. Os três mecanismos podem gerar padrões semelhantes nos resíduos, mas não contam a mesma história.
- Explique por que uma comparação por diferença de deviance continua a ser uma comparação entre um modelo compacto e um aumentado, apesar de já não usarmos a soma de quadrados como medida de ajuste.
Solução 8 — A Melhoria na Deviance
O modelo compacto impõe uma restrição e o aumentado liberta-a. A diferença \(\Delta D=D_{\text{compacto}}-D_{\text{aumentado}}\) mede a melhoria no ajuste segundo a verosimilhança, em vez de usar a soma de quadrados do erro.
Sob condições apropriadas, podemos comparar esta diferença com uma distribuição qui-quadrado, com graus de liberdade determinados pelos parâmetros adicionais. A pergunta mantém-se: a melhoria justifica libertar a restrição?
- Diga por que um efeito aleatório e uma binomial negativa não são duas maneiras intercambiáveis de «corrigir sobredispersão».
Solução 9 — Agrupamento e Dispersão
Um efeito aleatório representa diferenças entre unidades ou agrupamentos, como tanques que têm níveis próprios e observações correlacionadas. Uma binomial negativa permite variância nas contagens superior à imposta pelo Poisson, através de um parâmetro de dispersão.
A binomial negativa não diz, por si, que peixes ou observações partilham o mesmo tanque. E acrescentar um efeito aleatório não substitui necessariamente uma família que represente a variabilidade condicional adequada. Os dois mecanismos podem coexistir.
9 Recursos
- R
stats::family(): famílias, ligações e funções de variância - R: An Introduction to R, secção sobre GLMs
- Tutorial prático: proporções e contagens
- Comparação de modelos
- Teoria da Detecção de Sinal
- Medidas repetidas e modelos mistos
- McCullagh, P., & Nelder, J. A. (1989). Generalized Linear Models (2nd ed.). Chapman & Hall/CRC. https://www.routledge.com/Generalized-Linear-Models/McCullagh-Nelder/p/book/9780412317606