Medidas Repetidas e Modelos Mistos
Delineamento
Modelos
Quando há várias observações por unidade: ANOVA e modelos mistos.
0 Duas Medições
Suponhamos que medimos o stress das mesmas pessoas antes e depois de uma intervenção. Para cada pessoa temos duas observações.
Em formato largo, a estrutura é quase impossível de esconder:
| Pessoa | Antes | Depois | Diferença |
|---|---|---|---|
| 1 | 7 | 5 | -2 |
| 2 | 4 | 3 | -1 |
| 3 | 8 | 6 | -2 |
| 4 | 5 | 5 | 0 |
Se queremos saber se as pessoas mudaram, começamos pela operação mais simples possível, linha a linha:
\[ D_i=Y_{i,\text{depois}}-Y_{i,\text{antes}}. \]
Cada pessoa passa de duas observações para uma mudança. Em vez de comparar pessoas que podem ter níveis basais muito diferentes, comparamos cada pessoa consigo própria.
A pergunta «há uma mudança média entre antes e depois?» torna-se «a média das diferenças é diferente de zero?». O teste-t emparelhado é, portanto, um teste-t de uma amostra aplicado aos \(D_i\):
\[ t=\frac{\bar D}{SE_{\bar D}}. \]
Este é um delineamento intra-participantes, também chamado intra-sujeitos (within-subjects): as mesmas pessoas contribuem nos dois momentos. Com pessoas diferentes em cada nível, o factor seria inter-participantes ou inter-sujeitos (between-subjects).
Esta é a ideia central das medidas repetidas na sua forma mais simples. Sabemos quais observações pertencem à mesma pessoa e usamos essa ligação para separar diferenças estáveis entre pessoas da mudança dentro da pessoa.
Em formato longo, as duas observações aparecem em linhas diferentes e precisamos de um identificador para saber quais devem ser emparelhadas. A organização dos dados muda; a ideia estatística não.
DicaA Unidade Continua a Ser a Pessoa
Duas medições de 35 pessoas produzem 70 valores, mas continuam a existir 35 unidades acompanhadas ao longo do tempo. O emparelhamento usa precisamente essa estrutura.
1 E Com Três ou Mais Medições?
Agora medimos as mesmas pessoas de manhã, à tarde e à noite. Já não existe uma única subtracção que resuma toda a pergunta. Há várias diferenças possíveis.
Podíamos calcular tarde − manhã, noite − manhã e noite − tarde. Mas a pergunta geral «o nível médio de stress muda ao longo do dia?» envolve várias diferenças. É uma hipótese omnibus, que queremos testar de uma só vez.
Se tivermos 35 pessoas e três medições por pessoa, a base em formato longo tem 105 linhas. Continuamos a ter 35 unidades, cada uma observada três vezes.
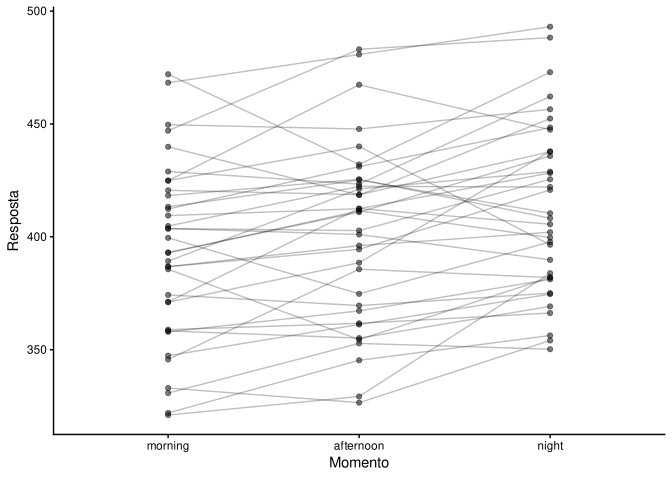
O gráfico liga as observações da mesma pessoa:
Algumas pessoas têm valores sistematicamente mais altos; outras, sistematicamente mais baixos. Isso é variação entre pessoas. A pergunta sobre o momento é uma pergunta sobre mudança dentro da pessoa.
Com duas medições, a subtracção separava imediatamente estas duas coisas. Com três ou mais, queremos preservar a mesma ideia sem reduzir o problema a uma lista crescente de subtracções.
2 ANOVA de Medidas Repetidas
Pôr a Unidade no Modelo
No capítulo de comparação de modelos, vimos como uma ANOVA de um factor passa de uma média comum para uma média por grupo. O modelo representa essas diferenças com \(k-1\) coeficientes de contraste. Aqui fazemos o mesmo para as pessoas: unidade é uma variável categórica com um nível por pessoa.
Com 35 pessoas, o modelo inclui um intercepto e 34 coeficientes de contraste para representar as diferenças entre as suas médias. São coeficientes multiplicados pelos valores das colunas de contraste, tal como acontecia com os factores do capítulo anterior. Não são declives em função do tempo: os valores de cada contraste são constantes para as observações da mesma pessoa, pelo que, graficamente, alteram o nível previsto para essa pessoa, como interceptos próprios.
Podemos tornar isto visível com três pessoas e contrastes de soma zero (contr.sum). Para três níveis, precisamos de dois contrastes: cada coluna soma zero e usa valores -1, 0 e 1. O intercepto passa a representar a média das três previsões (7), e os coeficientes dos contrastes são -3 e +1.
| Pessoa | Intercepto | Contraste 1 | Contraste 2 | Previsão |
|---|---|---|---|---|
| A | 1 | 1 | 0 | 4 |
| B | 1 | 0 | 1 | 8 |
| C | 1 | -1 | -1 | 9 |
A equação é \(\widehat y=7-3C_1+1C_2\). Assim, para A obtemos \(7-3=4\); para B, \(7+1=8\); para C, \(7+3-1=9\). Os coeficientes multiplicam os contrastes, como em qualquer modelo linear. Contudo, estes preditores só assumem os valores discretos definidos pela codificação: obtemos um nível previsto por pessoa, não um declive contínuo entre pessoas.
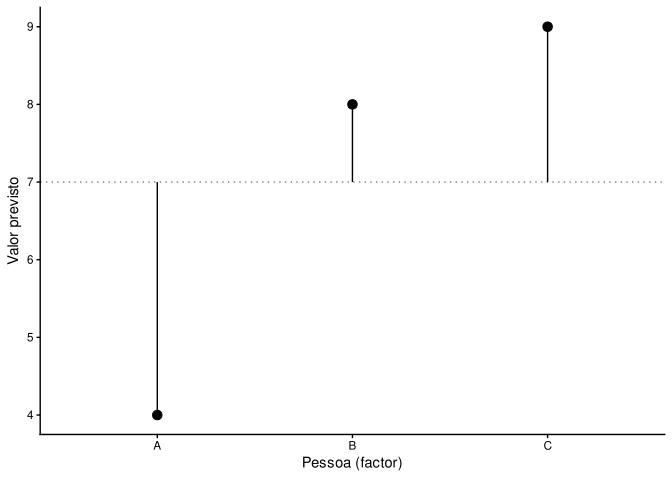
O segmento de A representa -3, o de B representa +1 e o de C representa +2 (a soma das duas contribuições, pois ambos os contrastes valem -1 para C). Com 35 pessoas, o princípio é o mesmo: 34 contrastes e 35 níveis previstos. A codificação muda a interpretação dos coeficientes, mas não as previsões ajustadas.
Começamos por permitir essas diferenças entre pessoas, sem ainda introduzir um efeito comum de momento:
m_unidade <- lm(resposta ~ unidade, data = ds)Depois libertamos as diferenças entre momentos:
m_unidade_momento <- lm(resposta ~ unidade + momento, data = ds)O primeiro é o modelo compacto: as pessoas podem ter médias diferentes, mas não há uma mudança média entre momentos. O segundo é o modelo aumentado: mantém as diferenças entre pessoas e permite também diferenças entre momentos.
anova(m_unidade, m_unidade_momento)| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 70 | 20286.35 | NA | NA | NA | NA |
| 68 | 13711.37 | 2 | 6574.98 | 16.30393 | 1.6e-06 |
A comparação pergunta: depois de termos em conta que as pessoas têm níveis médios diferentes, ganhamos explicação ao permitir diferenças entre manhã, tarde e noite?
Este não é necessariamente o modo como vamos pedir a análise ao R no trabalho prático. Aqui serve para mostrar os dois modelos que estão a ser comparados. A implementação fica no tutorial prático.
Com apenas dois momentos, esta comparação testa a mesma hipótese que o teste-t emparelhado e \(F=t^2\). A ANOVA de medidas repetidas prolonga, portanto, a lógica que acabámos de ver com uma única diferença por pessoa.
O F de Medidas Repetidas
Num delineamento unifactorial, completo e equilibrado, com uma observação por pessoa e momento, podemos escrever:
\[ SS_{total} = SS_{unidade} + SS_{momento} + SS_{unidade\times momento}. \]
A parte unidade × momento diz-nos quanto os perfis individuais se afastam do perfil médio. Com uma única observação por célula, ela também contém variação residual que não conseguimos separar.
Para testar momento, usamos:
\[ F= \frac{MS_{momento}} {MS_{unidade\times momento}}. \]
Não é uma fórmula nova. É o mesmo raciocínio do F do capítulo anterior: melhoria atribuível à parte do modelo que libertámos, dividida pelo erro que ainda ficou e que é apropriado para essa pergunta.
Nos nossos dados,
\[ MS_{momento} = \frac{SS_{momento}}{df_{momento}} = \frac{6574.98}{2} = 3287.49, \]
e
\[ MS_{erro} = \frac{SS_{unidade\times momento}}{df_{erro}} = \frac{1.371137\times 10^{4}}{68} = 201.64. \]
Logo,
\[ F = \frac{3287.49} {201.64} = 16.3. \]
O software transforma depois este F num valor-p. Não precisamos de redefinir aqui o valor-p: usamos exactamente a interpretação introduzida em Do t ao Valor-p.
O que mudou neste capítulo foi qual é o erro adequado ao delineamento e, portanto, como construímos a estatística F; a lógica da inferência é a mesma.
ImportanteO Que a Unidade Fez
Ao pôr unidade no modelo, separámos duas perguntas sobre a variação:
- quanto variam as pessoas entre si?
- quanto varia a resposta dentro da mesma pessoa entre momentos?
Para testar momento, a segunda é a fonte de variação relevante.
Da Ideia à Implementação
Para fazer esta análise no R, vamos usar funções que tratam a estrutura repetida e os seus testes. A sintaxe e o fluxo de trabalho ficam no tutorial prático.
Limites do lm()
O modelo
y ~ unidade + momentoé uma excelente ponte pedagógica para um único factor intra-unidades. Mas não é uma solução geral para todos os delineamentos repetidos.
Com dois factores repetidos, por exemplo, A e B, os testes clássicos usam fontes de erro diferentes para A, B e A × B. Aparecem componentes como
\[ SS_{unidade\times A},\qquad SS_{unidade\times B},\qquad SS_{unidade\times A\times B}. \]
Um único resíduo do modelo y ~ unidade + A * B não reproduz automaticamente todos esses denominadores.
Também há outro problema. Suponhamos que um grupo de pessoas recebe treino e outro funciona como controlo. Todas são avaliadas várias vezes, mas grupo não varia dentro de cada pessoa. Se dermos um coeficiente fixo separado a cada pessoa, podemos absorver precisamente as diferenças entre pessoas de que precisaríamos para estimar o efeito de grupo.
Portanto, a construção com lm() serve para ver a lógica, não para substituir todas as ANOVAs repetidas ou todos os modelos mistos.
Esfericidade
Com dois momentos há apenas uma diferença possível. Com três momentos já temos, por exemplo:
- manhã − tarde;
- manhã − noite;
- tarde − noite.
A ANOVA univariada clássica com três ou mais níveis precisa de uma condição sobre a forma como estas diferenças variam. Essa condição chama-se esfericidade.
Uma forma intuitiva de a ler é esta: o teste clássico não quer que uma diferença entre dois níveis seja tremendamente mais variável do que outra de uma forma que o seu denominador não representa.
Quando a esfericidade não é plausível, correcções como Greenhouse–Geisser e Huynh–Feldt ajustam os graus de liberdade do teste (Greenhouse & Geisser, 1959; Huynh & Feldt, 1976). Não alteram os dados e não tornam as observações independentes.
NotaO Que É Esfericidade?
Para um factor intra-unidades com vários níveis, a esfericidade pode ser expressa em termos da matriz de covariância das medidas repetidas. Uma formulação equivalente exige que todos os contrastes normalizados do efeito tenham a mesma variância.
No caso simples de um único factor repetido, isto corresponde à conhecida condição de igualdade das variâncias das diferenças entre pares de níveis.
As correcções Greenhouse–Geisser e Huynh–Feldt estimam quanto a estrutura se afasta da condição ideal e reduzem os graus de liberdade usados no teste F.
Quando a ANOVA Fica Apertada
A ANOVA de medidas repetidas é especialmente cómoda quando temos poucas condições bem definidas, um delineamento quase completo e uma observação ou um resumo por unidade × condição.
Começa a ficar menos natural quando aparecem:
- observações em falta;
- números diferentes de medições por unidade;
- tempos irregulares;
- várias unidades de agrupamento;
- ensaios individuais dentro de condições;
- efeitos que podem variar de unidade para unidade.
É aqui que os modelos mistos deixam de parecer uma técnica nova e passam a parecer a continuação natural da mesma pergunta: como representamos a estrutura que sabemos que existe nos dados?
3 Modelos Mistos
Um modelo misto mantém os efeitos que representam a nossa pergunta científica, mas acrescenta componentes que representam variação entre unidades.
Interceptos Aleatórios
Numa experiência de reconhecimento, várias pessoas respondem a fotografias de gatos e de cães. Medimos os tempos de resposta. Algumas pessoas são sistematicamente mais rápidas do que outras, mesmo quando têm de responder às mesmas categorias de imagens.
Um intercepto aleatório permite representar estas diferenças de nível:
lme4::lmer(
  tempo_resposta ~ tipo_animal + (1 | participante),
  data = ensaios
)
A parte (1 | participante) permite que cada pessoa tenha o seu nível basal e estima quão diferentes são esses níveis. Respostas da mesma pessoa partilham essa componente, que representa parte da dependência entre os ensaios. Mais adiante acrescentaremos também as fotografias: algumas imagens podem ser mais difíceis de reconhecer para toda a gente.
NotaIntercepto Aleatório
Um modelo simples pode ser escrito como
\[ Y_{ij} = \beta_0+\beta_1X_{ij}+u_{0j}+\epsilon_{ij}, \]
com
\[ u_{0j}\sim N(0,\tau_0^2). \]
O índice \(j\) identifica a unidade. Duas observações da mesma unidade partilham \(u_{0j}\), e é essa componente partilhada que produz covariância entre elas no modelo marginal.
Agrupamento Parcial
Já vimos duas maneiras de lidar com diferenças entre unidades. No modelo lm(resposta ~ unidade + momento), cada pessoa tem os seus coeficientes de contraste, estimados como efeitos fixos. Se ignorarmos unidade, todas as observações partilham o mesmo intercepto.
O intercepto aleatório oferece outra possibilidade. Estimamos um intercepto geral e a diferença média entre gatos e cães, mas também quanto variam os tempos basais entre pessoas. Essa variância ajuda a estimar o desvio particular de cada participante, sem criar um parâmetro fixo independente para cada pessoa.
Chamamos a isto agrupamento parcial (partial pooling): a estimativa do desvio de uma pessoa usa tanto as suas respostas como a variação estimada entre participantes. Com poucas observações ou muito ruído, o desvio estimado aproxima-se mais do intercepto geral. Com informação mais abundante e precisa, pode afastar-se. É o chamado shrinkage.
Assim, o intercepto aleatório diz-nos o que pode variar; o agrupamento parcial descreve como estimamos os desvios das unidades. Não são alternativas. A variação entre participantes ajuda-nos a representar dependência e heterogeneidade. Pode ser relevante para a inferência mesmo quando não é a pergunta científica principal.
NotaA Forma Matricial
Um modelo linear misto pode ser escrito como
\[ \mathbf y = \mathbf X\boldsymbol\beta + \mathbf Z\mathbf u + \boldsymbol\epsilon. \]
\(\mathbf X\boldsymbol\beta\) contém os efeitos fixos; \(\mathbf Z\mathbf u\) distribui os efeitos aleatórios pelas observações. A inferência exige estimar também as variâncias e covariâncias associadas a \(\mathbf u\), normalmente por máxima verosimilhança ou REML.
Os algoritmos usados para o fazer são importantes para quem estuda computação estatística, mas não são necessários para interpretar (1 | participante).
Declives Aleatórios
As pessoas podem diferir não só no tempo de resposta habitual, mas também na diferença entre gatos e cães. Algumas podem reconhecer gatos mais depressa, outras cães. E essa diferença pode ser grande para umas pessoas e pequena para outras.
Se cada pessoa vir várias imagens das duas categorias, podemos permitir que o efeito de tipo_animal varie entre participantes:
lme4::lmer(
  tempo_resposta ~ tipo_animal + (tipo_animal | participante),
  data = ensaios
)
O efeito fixo resume a diferença média entre categorias. O declive aleatório representa a variação dessa diferença entre pessoas. A notação (tipo_animal | participante) inclui também um intercepto aleatório para cada pessoa.
Há uma condição essencial: o preditor precisa de variar dentro da unidade. Se cada pessoa vir apenas gatos ou apenas cães, não observamos uma diferença entre categorias dentro de cada participante. Não podemos estimar esse declive por participante.
Uma imagem de gato, por sua vez, nunca se transforma numa imagem de cão. Por isso, tipo_animal pode variar entre imagens sem variar dentro da mesma imagem. Esta diferença será importante ao cruzarmos participantes e estímulos.
NotaIntercepto e Declive Aleatórios
Podemos escrever
\[ Y_{ij} = (\beta_0+u_{0j}) + (\beta_1+u_{1j})X_{ij} + \epsilon_{ij}. \]
O modelo pode ainda estimar a covariância entre \(u_{0j}\) e \(u_{1j}\): pessoas com tempos basais mais altos podem apresentar diferenças maiores ou menores entre categorias. Essa estrutura adicional precisa de dados suficientes para ser estimada.
Efeitos Fixos e Aleatórios
A regra «poucos níveis = fixo; muitos níveis = aleatório» não basta. O número de níveis afecta aquilo que conseguimos estimar, mas não determina sozinho a pergunta.
Na tarefa de reconhecimento, queremos comparar gatos e cães: tipo_animal entra habitualmente como efeito fixo. Não queremos, porém, um coeficiente fixo separado para cada pessoa nem para cada fotografia. Podemos representar a variação entre participantes e entre imagens com efeitos aleatórios, quando isso corresponde à nossa pergunta e ao modo como amostrámos os estímulos.
Se quisermos falar de outras fotografias, não basta ter recolhido muitas respostas às mesmas duas imagens. A identidade dos estímulos é outra possível fonte de incerteza. O mesmo princípio aparece em ecologia: podemos querer comparar duas espécies concretas (efeito fixo) e representar a variação entre recifes amostrados (efeito aleatório).
4 Estrutura e Replicação
Intra- e Inter-Unidades
Um factor é intra-unidades (within) ou inter-unidades (between) relativamente a uma unidade específica. Em psicologia dizemos habitualmente intra- e inter-participantes, mas os estímulos também podem constituir unidades importantes.
Voltemos à experiência: todas as pessoas vêem fotografias de gatos e cães, mas cada imagem representa um animal de uma só categoria. O factor tipo_animal é intra-participantes e inter-imagens.
O que aconteceria se acrescentássemos outros factores?
| Factor | Dentro do participante? | Dentro da imagem? |
|---|---|---|
| Tipo de animal (gato/cão) | Sim, se vê ambas as categorias | Não, cada imagem tem uma categoria |
| Nitidez (nítida/desfocada) | Sim, se experimenta ambas | Sim, se a mesma fotografia é apresentada nas duas versões ao longo das pessoas |
| Grupo de treino (treino/controlo) | Não, cada pessoa pertence a um grupo | Sim, se as mesmas imagens são vistas por pessoas dos dois grupos |
| Momento (antes/depois) | Sim, se a pessoa é avaliada nos dois momentos | Só se as mesmas imagens aparecerem nos dois momentos |
Para a nitidez variar dentro da imagem, não precisamos de apresentar a mesma fotografia duas vezes à mesma pessoa. Podemos contrabalançar as versões entre participantes: umas pessoas vêem a fotografia nítida, outras vêem-na desfocada. O essencial é que a identidade da imagem apareça nas duas condições no conjunto do estudo.
Esta tabela ajuda a escolher os declives aleatórios: só podemos pedir que um efeito varie dentro de uma unidade se o delineamento fornecer observações dessa unidade em mais do que um nível do factor.
Um exemplo biológico funciona da mesma maneira: o tempo pode variar dentro de cada peixe; um tratamento atribuído a tanques varia entre tanques; e vários peixes podem partilhar o mesmo tanque. Indicar apenas «inter-unidades» é insuficiente. Que unidades?
NotaMesmo Factor, Unidades Diferentes
Suponhamos que cada linha inicial corresponde a um espécime diferente e queremos testar species. Vários espécimes podem ter a mesma espécie sem que isso crie medidas repetidas. Species é, nesse caso, um factor inter-unidades. O que se repete é o nível do factor, não a unidade de observação.
No exemplo dos briozoários do tutorial prático, as duas situações coexistem: Species é inter-unidades, mas Stage é medido repetidamente dentro da mesma Unit. É essa repetição de Unit que precisa de ser representada pelo termo de medidas repetidas.
Se os espécimes estiverem ainda agrupados em tanques, recifes, colónias ou outros conjuntos relevantes, esse nível também precisa de ser considerado. Incluir Species nos efeitos fixos responde à pergunta sobre espécies. Não faz desaparecer dependência criada por outro agrupamento.
DicaAgrupar Não É Repetir
Há outro problema de níveis que não é medidas repetidas: juntar grupos pode até inverter a direcção de uma associação. Vejam o paradoxo de Simpson com os Palmer Penguins.
Nesse exemplo, cada linha continua a ser um espécime diferente e species é um factor inter-unidades. O problema é que a associação agregada mistura diferenças entre espécies com a associação dentro das espécies.
Tanques, Peixes e Pseudorreplicação
Imaginemos um tratamento térmico atribuído a tanques. Cada tanque contém vários peixes.
A estrutura é:
peixe → tanque → tratamento
Uma linha pode representar um peixe, mas o tratamento varia ao nível do tanque.
Se tivermos vários tanques por tratamento, um modelo possível é:
lme4::lmer(crescimento ~ tratamento + (1 | tanque), data = dados)Os peixes do mesmo tanque partilham ambiente e tratamento, e o efeito aleatório representa essa semelhança.
Mas suponham agora que existe apenas um tanque de controlo e um tanque aquecido. Medir 30 peixes em cada tanque não cria 30 réplicas independentes do tratamento. Tratamento e tanque estão perfeitamente confundidos.
Este é o problema clássico da pseudorreplicação (Hurlbert, 1984).
ImportanteO Modelo Não Cria Réplicas
Um modelo misto pode representar dependência entre unidades que existem.
Não pode criar tanques que nunca foram replicados.
Antes de escolher a fórmula, identifiquem sempre a que nível o preditor foi atribuído ou varia independentemente.
Estruturas Aninhadas e Cruzadas
Imaginemos duas pessoas e quatro fotografias. Ambas as pessoas vêem as mesmas quatro imagens, uma vez cada. Estes tempos de resposta, em milissegundos, são inventados para ilustrar a estrutura:
| Imagem | Animal | Pessoa 1 | Pessoa 2 |
|---|---|---|---|
| 1C | Gato | 510 | 480 |
| 2C | Gato | 540 | 525 |
| 1D | Cão | 590 | 545 |
| 2D | Cão | 570 | 560 |
Os números repetem-se: 1C e 1D são duas fotografias diferentes. No ficheiro em formato longo haveria oito linhas, uma por resposta. Mais importante: cada pessoa responde a várias imagens e cada imagem é vista por várias pessoas. Por isso, participantes e imagens são fontes de variação cruzadas. Uma pessoa pode ser habitualmente rápida; uma fotografia pode ser habitualmente difícil.
Para um estudo com muito mais participantes e estímulos, uma estrutura candidata seria:
lme4::lmer(
  tempo_resposta ~ tipo_animal +
    (tipo_animal | participante) + (1 | imagem),
  data = ensaios
)
A pequena tabela serve para compreender o delineamento, não para ajustar este modelo. O efeito de tipo_animal pode variar entre participantes, porque todos vêem as duas categorias. Mas cada imagem é sempre um gato ou sempre um cão. Não temos, portanto, uma diferença gato–cão dentro da mesma imagem, e (tipo_animal | imagem) não seria um declive estimável.
Identificadores Únicos Não Alteram o Delineamento
As imagens estão, ao mesmo tempo, aninhadas nas categorias: 1C e 2C são gatos, 1D e 2D são cães. Dar IDs únicos não elimina essa relação. Permite, isso sim, que o modelo reconheça cada fotografia como um estímulo distinto. Como tipo_animal já entra como efeito fixo, podemos usar (1 | imagem) para a variação entre fotografias sem precisar de escrever (1 | tipo_animal/imagem).
O cuidado é maior se chamarmos 1 tanto à primeira fotografia de gato como à primeira fotografia de cão: uma coluna com esse identificador sozinho confundiria dois estímulos diferentes.
E se cada participante receber imagens exclusivas que ninguém mais vê? Então as imagens ficam aninhadas nos participantes. Inventar novos códigos para as fotografias não as torna cruzadas. A relação vem de quem viu efectivamente cada estímulo. O cruzamento pode também ser incompleto: nem toda a gente precisa de ver todas as imagens, desde que algumas identidades sejam partilhadas de acordo com o delineamento.
Quando o Mesmo Estímulo Passa Por Duas Condições
Agora imaginemos que apresentamos fotografias nítidas e desfocadas, distribuindo as duas versões de cada fotografia por diferentes pessoas. Se cada participante vê ambas as condições de nitidez, esse factor varia dentro de cada pessoa e dentro de cada fotografia. Podemos considerar declives de nitidez para os dois agrupamentos. Uma possível estrutura, com replicação suficiente, seria:
lme4::lmer(
  tempo_resposta ~ tipo_animal * nitidez +
    (1 + tipo_animal * nitidez | participante) +
    (1 + nitidez | imagem),
  data = ensaios
)
É apenas uma estrutura candidata: precisamos de participantes, imagens e observações suficientes para estimar os seus componentes. Há declives de nitidez por imagem, mas não de tipo_animal por imagem. O animal representado não muda quando desfocamos a fotografia.
O Contraste Ecológico
Em ecologia, vários quadrados dentro de cada recife podem estar aninhados. A notação seguinte representa diferenças entre recifes e entre quadrados dos respectivos recifes:
lme4::lmer(cobertura ~ impacto + (1 | recife/quadrado), data = dados)Se as mesmas fotografias submarinas forem classificadas por vários observadores, e cada observador classificar várias fotografias, voltamos a ter agrupamentos cruzados:
lme4::lmer(
  cobertura ~ tratamento + (1 | fotografia) + (1 | observador),
  data = dados
)
Em todos estes exemplos, perguntamos que observações partilham cada fonte de variação? As fórmulas vêm depois dessa resposta.
Construir o Modelo Misto
Testar as hipóteses de um delineamento e seleccionar um modelo para previsão são tarefas diferentes. Ambas são legítimas, mas podem exigir procedimentos diferentes. Aqui seguimos sobretudo Singmann e Kellen (2019), tendo também em conta Barr et al. (2013), Keep it maximal e os capítulos da PsyTeachR.
Efeitos Fixos
Num delineamento factorial A × B, representamos normalmente A, B e A × B, mesmo quando esperamos que algum efeito seja nulo. Retirar termos porque não foram significativos muda a análise à luz dos resultados e pode alterar o significado dos outros testes. É uma estratégia diferente da ANOVA confirmatória habitual.
Como vimos na comparação de modelos, cada linha de uma tabela ANOVA testa uma comparação entre modelos, ou uma restrição sobre parâmetros. Um factor com vários níveis é representado por vários contrastes, que o teste omnibus avalia em conjunto. Não precisamos de ajustar manualmente um modelo novo para cada linha.
Uma tabela Tipo II ou III, com hipóteses e codificação apropriadas, reúne estes testes. Nos modelos mistos precisamos ainda de especificar como obtemos os graus de liberdade e os valores-p. As comparações explícitas continuam úteis para perguntas específicas.
Estrutura Aleatória
Começamos pelas unidades que criam dependência: pessoas, imagens, tanques ou outras. Incluímos interceptos aleatórios e consideramos declives aleatórios para os factores que variam dentro de cada unidade, incluindo interacções pertinentes quando há informação suficiente.
Na tarefa com imagens, tipo_animal varia dentro das pessoas, mas não dentro das imagens; nitidez pode variar dentro de ambas. Se o grupo de treino for atribuído a cada pessoa, esse factor é inter-participantes e não justifica (grupo | participante); pode, contudo, variar dentro da imagem quando a mesma fotografia é apresentada a pessoas dos dois grupos. Analisamos cada factor relativamente a cada agrupamento, em vez de chamar à experiência inteira «intra» ou «inter».
Se A e B variam dentro de cada pessoa, uma estrutura candidata, quando há replicação suficiente, é:
lme4::lmer(y ~ A * B + (1 + A * B | pessoa), data = dados)Esta estrutura permite variação entre pessoas nos efeitos de A, B e A × B e nas suas correlações. Contudo, máximo justificado não significa máximo que conseguimos escrever: com poucos dados ou sem replicação por célula, alguns componentes podem não ser identificáveis.
Singmann e Kellen (2019) propõem começar pela estrutura máxima justificada pelo delineamento: tentar ajustá-la, diagnosticar os problemas e, se não for possível estimá-la adequadamente, simplificar apenas o necessário. Uma estrutura aleatória complexa pode ser importante mesmo que não tenhamos formulado uma hipótese substantiva sobre a variação dos declives. Ao representar essa heterogeneidade, pode permitir testar correctamente os efeitos fixos.
Há uma tentação diferente: começar apenas com interceptos aleatórios e manter essa estrutura porque «não prevemos que os declives variem». Mas não prever heterogeneidade não demonstra que ela não existe. Se os declives realmente variam e o modelo os ignora, os testes dos efeitos fixos podem tornar-se demasiado liberais. E se a variação for muito pequena, o modelo mais rico pode estimar uma variância próxima de zero ou apresentar singularidade; isso é informação sobre o que os dados conseguem sustentar, não uma razão para omitir os declives à partida.
Outra estratégia começa com interceptos aleatórios e só acrescenta declives quando testes sucessivos os consideram significativos. Esta selecção ascendente, sobretudo com critérios convencionais rígidos, não equivale à proposta de Singmann e Kellen (2019) e pode eliminar componentes necessários para representar a dependência. Também não devemos confundi-la com a selecção descendente liberal estudada por Matuschek et al. (2017).
Erro de Tipo I e Poder
Entre a proposta maximalista de Barr et al. (2013) e a selecção agressiva de estruturas mínimas, Matuschek et al. (2017) estudaram, por simulação, um compromisso entre erro de Tipo I e poder. Ignorar declives aleatórios que realmente variam entre unidades pode tornar os testes dos efeitos fixos demasiado liberais. Por outro lado, estimar uma estrutura excessivamente complexa, pouco sustentada pelos dados, pode reduzir o poder (aumentando o erro de Tipo II).
Uma das estratégias avaliadas parte de uma estrutura rica e faz selecção descendente dos componentes aleatórios com testes por razão de verosimilhanças, usando um critério liberal para conservar complexidade (por exemplo, \(\alpha_{\mathrm{LRT}}=.20\), em vez de .05). A intenção é evitar remover componentes com base em evidência fraca. Nas situações simuladas, esta estratégia melhorou o poder relativamente a alguns modelos máximos sem um aumento substancial do erro de Tipo I.
Isto não é uma receita universal, nem significa seleccionar os efeitos fixos da hipótese científica pelos respectivos valores-p. A validade da estratégia depende do delineamento e das estruturas que os dados permitem estimar. A nossa preferência pedagógica continua a ser começar pelo delineamento e simplificar com justificação, mas este estudo mostra por que «manter tudo sempre» e «usar apenas interceptos aleatórios» também não são regras suficientes.
Diagnosticar e Simplificar
Se o modelo máximo não converge, verificamos primeiro os dados, a codificação, as escalas, os optimizadores e se os componentes pedidos podem ser identificados. Um aviso de convergência e um ajuste singular não são sinónimos. No segundo caso, a matriz estimada de covariâncias aleatórias tem posto reduzido, como pode acontecer com variâncias próximas de zero ou correlações extremas.
Quando é preciso simplificar, seguimos uma sequência tão conservadora quanto possível: primeiro podemos tentar retirar correlações entre efeitos aleatórios (por exemplo, com estruturas descorrelacionadas); depois, se necessário, reduzir declives de interacções de ordem superior e só mais tarde componentes de ordem inferior.
A sintaxe || permite especificar termos aleatórios sem certas correlações, mas em lme4 não funciona de forma inteiramente automática com factores. A função afex::mixed() disponibiliza expand_re = TRUE, que expande os termos de factores em colunas numéricas e permite usar || para esses contrastes. Podemos ver como se faz no exemplo prático de simplificação da estrutura aleatória.
Documentamos as decisões e, quando possível, verificamos se as conclusões sobre efeitos fixos se mantêm noutras estruturas que os dados permitam estimar. Nem um aviso prova que o modelo está errado, nem a ausência de avisos prova que a estrutura é adequada. Um modelo problemático pode fornecer informação para uma análise de sensibilidade, mas não é automaticamente uma referência fiável.
Do Omnibus aos Contrastes
O modelo misto não nos obriga a abandonar a lógica da ANOVA. Depois de definirmos os efeitos fixos e a estrutura de dependência, podemos obter testes omnibus para os termos do modelo e estudar médias marginais estimadas (estimated marginal means, EMMs).
O pacote emmeans calcula essas médias a partir do mesmo modelo ajustado e permite pedir contrastes planeados, comparações entre pares, efeitos simples e correcções para multiplicidade. Não precisamos de dividir os dados em subconjuntos nem reajustar modelos para cada par de níveis. Tal como no capítulo anterior, fazemos perguntas diferentes sobre as previsões e os contrastes do modelo. As suas interpretações dependem da parametrização, das interacções e da estrutura de inferência escolhida.
De Onde Vêm os Valores-p?
O pacote lme4 não apresenta por defeito valores-p dos coeficientes fixos no resumo de um modelo linear misto. Em delineamentos finitos, especialmente desequilibrados, os graus de liberdade do denominador não são tão simples como na ANOVA clássica.
Satterthwaite aproxima esses graus de liberdade. Kenward–Roger também ajusta a incerteza estimada dos efeitos fixos; pode ser mais dispendioso computacionalmente e não é universalmente superior. Pacotes como lmerTest e afex permitem usar estas aproximações para testes de efeitos fixos.
Também podemos comparar modelos aninhados por razão de verosimilhanças (likelihood-ratio test, LRT), usando a distribuição qui-quadrado como referência assintótica. Para comparar estruturas de efeitos fixos por LRT, os modelos devem ser ajustados por ML, não REML.
Um bootstrap paramétrico pode calibrar o teste, mas exige mais cálculo. Testar variâncias aleatórias iguais a zero requer cuidados adicionais: a hipótese está na fronteira do espaço paramétrico.
A nossa opção: manter a estrutura fixa justificada pela pergunta científica, começar pela estrutura aleatória justificada pelo delineamento, simplificar esta última de forma fundamentada quando necessário e declarar claramente o método de inferência usado. Não escolhemos a estrutura que produz o valor-p mais conveniente.
5 Um Roteiro Para Ler Estes Modelos
Ao ler uma análise de medidas repetidas ou um modelo misto, vale a pena começar por estas perguntas, antes de olhar para a fórmula:
- O que representa uma linha?
- Qual é a unidade que aparece repetidamente?
- Qual é a pergunta científica?
- O preditor varia dentro ou entre que unidades?
- Que diferenças estáveis entre unidades precisam de ser separadas do erro?
- O efeito do preditor pode plausivelmente variar entre unidades?
- Há outros agrupamentos, aninhados ou cruzados?
- O delineamento contém réplicas independentes no nível em que queremos fazer inferência?
Depois disso, a fórmula deixa de parecer uma língua secreta. Passa a ser uma descrição abreviada das respostas.
6 Síntese
A passagem de modelos lineares para medidas repetidas não exige abandonar a ideia central do capítulo anterior.
Continuamos a partir de Dados = Modelo + Erro e a perguntar que parte do modelo representa a pergunta científica e que variabilidade permite avaliá-la.
Quando uma unidade aparece várias vezes, o erro deixa de poder ser tratado como se todas as linhas fossem independentes.
A ANOVA de medidas repetidas separa diferenças entre unidades da variabilidade dentro das unidades. Num caso simples, conseguimos ver isso directamente pondo a unidade no modelo e comparando um modelo compacto com um aumentado.
Os modelos mistos levam a mesma ideia mais longe. Permitem representar interceptos, declives e várias fontes de agrupamento sem transformar cada unidade num coeficiente fixo separado.
E há um limite que nenhum método ultrapassa: um modelo pode reconhecer a estrutura do delineamento; não pode criar replicação que o delineamento não teve.
No tutorial prático usamos estas ideias para ajustar ANOVAs com aov_4() e primeiros modelos mistos.
7 Exercícios
A pergunta principal é sempre a mesma: qual é a unidade que se repete e a que nível varia cada condição?
- Trinta pessoas são medidas antes e depois de uma intervenção. Explique por que há 60 linhas mas apenas 30 pares independentes. Mostre como o problema pode ser reduzido a uma média de diferenças.
Solução 1 — Trinta Pares, Sessenta Linhas
Cada pessoa contribui com duas medições. Por isso temos 60 linhas, mas 30 pares de observações, assumindo independência entre pessoas.
Calculamos para cada pessoa a diferença
$ d_i=y_{i,}-y_{i,}. $
A pergunta sobre a mudança passa a ser uma pergunta acerca da média das 30 diferenças, \(\overline d\), e do seu erro-padrão. As diferenças estáveis entre pessoas deixam de dominar a comparação.
- No exemplo manhã/tarde/noite, explique por palavras o que fica no modelo compacto
resposta ~ unidadee o que é libertado quando acrescentamosmomento.
Solução 2 — Compacto e Aumentado
Em resposta ~ unidade, cada pessoa pode ter o seu nível médio, mas esse nível é previsto como igual nos três momentos. Acrescentar momento liberta essa restrição: o modelo prevê diferenças comuns entre manhã, tarde e noite, depois de representar o nível de cada pessoa.
Com três momentos, o factor liberta dois graus de liberdade. A comparação examina se essas diferenças melhoram o ajuste.
- Explique por que o denominador do F para
momentodeve reflectir variabilidade dentro das unidades e não diferenças estáveis entre unidades.
Solução 3 — O Denominador do F
Pessoas diferentes podem ter níveis médios muito distintos, sem que nenhuma mude entre momentos. Para testar o efeito de momento precisamos da variabilidade dentro das pessoas que permanece depois de representar unidade e momento.
Na ANOVA simples de medidas repetidas, é essa variação residual intra-unidades, com os pressupostos apropriados, que entra no denominador do F. Usar diferenças estáveis entre pessoas como erro de referência responderia a outra pergunta.
- Um tratamento é atribuído a quatro tanques e há vinte peixes em cada tanque. Qual é a unidade de replicação do tratamento? O que representam os peixes?
Solução 4 — Quatro Tanques
Se o tratamento foi atribuído aos tanques, temos quatro unidades experimentais, não oitenta réplicas independentes do tratamento. Os vinte peixes de cada tanque constituem observações ou subamostras dentro dessa unidade.
Mais peixes ajudam a conhecer cada tanque. Não criam novas unidades independentes que receberam o tratamento. Um modelo misto também não consegue criar essa replicação.
- Explique a diferença substantiva entre
(1 | colonia)e(temperatura | colonia).
Solução 5 — Interceptos e Declives
(1 | colonia) permite interceptos diferentes entre colónias, mantendo o efeito da temperatura comum. (temperatura | colonia) permite também que o declive da temperatura varie entre colónias e, quando identificável, estima a correlação entre interceptos e declives.
Esta segunda estrutura precisa de variação relevante da temperatura dentro das colónias e de informação suficiente para estimar a heterogeneidade dos declives.
- Na experiência com imagens 1C, 2C (gatos) e 1D, 2D (cães), explique por que
tipo_animalé intra-participantes e inter-imagens. Por que participantes e fotografias são, ainda assim, agrupamentos cruzados?
Solução 6 — Factores e Agrupamentos Cruzados
Cada participante vê gatos e cães, logo tipo_animal é intra-participantes. Cada fotografia pertence apenas a uma categoria, logo é inter-imagens.
Participantes e imagens são, ainda assim, agrupamentos cruzados: cada pessoa vê várias fotografias e cada fotografia é vista por várias pessoas. O factor e a estrutura de agrupamento são perguntas diferentes.
- Se cada fotografia aparecer numa versão nítida para umas pessoas e desfocada para outras, e todas as pessoas experimentarem as duas condições, que declives aleatórios poderá considerar para
nitidez? E paratipo_animal?
Solução 7 — Declives Aleatórios Possíveis
Como cada pessoa vê imagens nítidas e desfocadas, podemos considerar um declive de nitidez por participante. Se a mesma fotografia aparece nas duas versões ao longo de participantes diferentes, também podemos considerar um declive por imagem.
tipo_animal varia dentro dos participantes e admite um declive por participante. Uma fotografia continua a ser de gato ou de cão: não há variação de tipo_animal dentro da mesma imagem que permita estimar esse declive por imagem. Tudo isto depende da replicação e da possibilidade de estimar os componentes.
- Agora cada participante vê fotografias exclusivas. O que mudou na estrutura de agrupamento? Dar novos identificadores às imagens tornaria os factores cruzados?
Solução 8 — Imagens Exclusivas
Quando cada fotografia é vista por uma única pessoa, as imagens ficam aninhadas nos participantes. Deixamos de observar a mesma imagem em várias pessoas, pelo que já não temos a estrutura cruzada do exemplo anterior.
Mudar os identificadores das fotografias não altera a estrutura real do delineamento. Precisamos de saber quem viu o quê.
- Um modelo misto é singular. Diga três perguntas que faria antes de remover termos automaticamente.
Solução 9 — Um Ajuste Singular
Antes de retirar termos, perguntaria:
- O delineamento contém variação e replicação suficientes para estimar cada declive e cada variância?
- A codificação, a escala dos preditores e os avisos de convergência apontam para um problema de ajuste?
- Que componente está mal identificado? Há uma variância quase nula ou correlações estimadas no limite?
Só depois decidiria como simplificar, preservando as dependências que o delineamento exige. Retirar automaticamente todos os declives pode mudar a inferência dos efeitos fixos.
8 Leituras
Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001
Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001
Singmann, H., & Kellen, D. (2019). An introduction to mixed models for experimental psychology. In New Methods in Cognitive Psychology (pp. 4–31). Routledge. https://doi.org/10.4324/9780429318405-2
Barr, D. J. (2021). Learning statistical models through simulation in R: An interactive textbook (Version 1.0.0). https://psyteachr.github.io/stat-models-v1/
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Harrison, X. A., Donaldson, L., Correa-Cano, M. E., Evans, J., Fisher, D. N., Goodwin, C. E. D., Robinson, B. S., Hodgson, D. J., & Inger, R. (2018). A brief introduction to mixed effects modelling and multi-model inference in ecology. PeerJ, 6, e4794. https://doi.org/10.7717/peerj.4794
Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008
Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069