| N | M | SD | SE | t |
|---|---|---|---|---|
| 50 | 0.5652 | 1.095241 | 0.1548904 | 3.649031 |
Abordagem de Comparação de Modelos
Inferência
Modelos
O que testes-t, ANOVA e regressão têm em comum.
0 Introdução
Em Fundamentos da Inferência começámos com uma média, o seu erro-padrão, uma estatística t e um valor-p. Agora voltamos aos mesmos dados para dar o passo que organiza o resto da estatística neste site: escrever a pergunta como uma comparação entre modelos.
Esta forma de organizar regressão, ANOVA e extensões num mesmo quadro segue de perto a abordagem desenvolvida por Correll et al. (2025) em Data Analysis: A Model Comparison Approach to Regression, ANOVA, and Beyond. Em vez de começar por uma lista de testes com nomes diferentes, começamos por dois modelos e perguntamos se acrescentar parâmetros reduz o erro o suficiente para justificar essa complexidade.
Há uma ideia antiga por trás desta abordagem: a navalha de Occam. Entre explicações que fazem igualmente bem o seu trabalho, preferimos normalmente a mais simples. Isto é uma heurística, não uma lei da natureza. Nada garante que a explicação verdadeira seja sempre a mais simples. Ainda assim, a preferência por não acrescentar complexidade sem necessidade tem sido uma regra de trabalho muito útil em ciência.
A comparação de modelos tenta tornar esse compromisso explícito. Queremos um modelo que reduza o erro e reproduza melhor os dados. Só que um modelo mais complexo também tem mais liberdade para conseguir isso. A pergunta passa então a ser muito simples: a redução do erro compensa a complexidade que acrescentámos?
Daqui a pouco tornaremos estas duas ideias concretas. O erro será resumido a partir dos resíduos ao quadrado. A diferença de complexidade entre dois modelos aninhados será medida pelos parâmetros que libertámos: no teste F, essa diferença aparece como
\[ df_1=p_1-p_0. \]
Assim, o problema que vamos resolver é sempre o mesmo: quanto erro conseguimos retirar ao passar de um modelo mais simples para um mais complexo, por cada grau de liberdade que acrescentámos?
A pergunta continua a ser se, em média, a população é indiferente à música da Taylor Swift. Na escala Love4Taylor, zero representa indiferença, por isso a hipótese de referência é
\[ H_0:\mu=0. \]
Mais tarde mudaremos os preditores e o número de parâmetros, mas a estrutura mantém-se: que restrição representa a ausência do efeito que queremos estudar e quanto erro desaparece quando a libertamos?
1 O Modelo Linear
Dados, Modelo e Erro
O mesmo problema pode ser escrito sem começar pelo nome de um teste:
\[ \text{Dados}=\text{Modelo}+\text{Erro}. \]
Para cada observação,
\[ Y_i=\hat Y_i+e_i. \]
O modelo dá-nos uma previsão; o resíduo é o que ficou por explicar. Para comparar modelos lineares, resumimos esses resíduos através da soma dos quadrados:
\[ SSE=\sum_i(Y_i-\hat Y_i)^2. \]
Quanto menor o \(SSE\), melhor o modelo reproduz os dados. Mas um modelo com mais parâmetros tem mais liberdade para reduzir o erro. Portanto, a pergunta não pode ser apenas «qual tem menos SSE?». Precisamos de comparar a melhoria com a complexidade que acrescentámos e com o erro que ainda ficou por explicar.
NotaComo o Computador Encontra os Coeficientes?
No modelo linear podemos escrever todas as observações de uma vez como
\[ \mathbf y=\mathbf X\boldsymbol\beta+\boldsymbol\varepsilon. \]
Os mínimos quadrados escolhem \(\hat{\boldsymbol\beta}\) para minimizar
\[ (\mathbf y-\mathbf X\boldsymbol\beta)^T (\mathbf y-\mathbf X\boldsymbol\beta). \]
Quando a matriz do modelo tem posto completo, este problema é quadrático e convexo: existe uma solução única. A expressão clássica é
\[ \hat{\boldsymbol\beta} =(\mathbf X^T\mathbf X)^{-1}\mathbf X^T\mathbf y. \]
Esta fórmula é óptima para perceber a álgebra, mas software estatístico sério não precisa de formar explicitamente essa inversa. Métodos como decomposição QR são numericamente mais estáveis e encontram a mesma solução de mínimos quadrados.
Esta maquinaria é útil para quem quiser perceber como lm() resolve o problema. Não é necessária para interpretar uma média, um contraste, um declive ou uma interacção.
Dois Modelos Para a Mesma Hipótese
Em Fundamentos da Inferência, calculámos o teste-t para a média da escala Love4Taylor. Refaçamos a conta: precisamos do tamanho da amostra (\(N\)), da média (\(M\)), do desvio-padrão (\(SD\)) e do erro-padrão da média (\(SE\)). Como a referência é zero, dividimos a média pelo seu erro-padrão para obter t:
Na expressão seguinte arredondamos apenas os valores apresentados:
\[ t=\frac{M}{SE} =\frac{M}{\frac{SD}{\sqrt{N}}} \approx\frac{0.5652}{0.1549} \approx 3.65. \]
Agora vamos fazer a mesma pergunta comparando dois modelos. No teste-t, escrevemos \(H_0:\mu=0\). No modelo linear, a hipótese equivalente é \(H_0:\beta_0=0\), porque o intercepto de um modelo sem preditores é a média. Esta hipótese define o modelo compacto.
Modelo Compacto
Se as pessoas forem, em média, indiferentes à Taylor Swift, a previsão é sempre zero:
\[ m_0:\quad \hat Y=0. \]
Este modelo não estima a média a partir dos dados. Impõe a restrição que queremos testar.
Modelo Aumentado
O modelo aumentado liberta essa restrição e estima um intercepto:
\[ m_1:\quad \hat Y=\beta_0. \]
Num modelo apenas com intercepto, a estimativa de \(\beta_0\) é a média amostral. Portanto,
\[ \hat Y=0.57. \]
A pergunta estatística passou a ter uma forma muito concreta: vale a pena abandonar a previsão fixa de zero e estimar a média a partir dos dados? Dito de outra forma, este modelo é melhor do que ficar pela referência, ou estamos a complicar para ficar praticamente na mesma?
Em R, podemos ajustar directamente os dois modelos:
Comecemos pelo modelo compacto. Como prevê zero para toda a gente, o resíduo de cada pessoa é a sua resposta menos zero. Criamos duas colunas para tornar essa conta visível em várias observações:
love <- mutate(love,
  prediction_m0 = predict(m0),
  error_m0 = Love4Taylor - prediction_m0
)
Código
love |>
  select(ID, Love4Taylor, prediction_m0, error_m0) |>
  rename(Pessoa = ID, Observado = Love4Taylor,
         `Previsão m0` = prediction_m0, `Resíduo m0` = error_m0) |>
  datatable(
    rownames = FALSE,
    options = list(pageLength = 8, lengthChange = FALSE, scrollX = TRUE)
  ) |>
  formatRound(columns = 2:4, digits = 2)
Cada linha corresponde a uma pessoa. Podemos percorrer as 50 observações, não apenas a primeira. No modelo aumentado, a previsão deixa de ser zero: passa a ser a média observada. Calculamos os novos resíduos e, para cada modelo, elevamos os resíduos ao quadrado, \(e_i^2\):
love <- mutate(love,
  prediction_m1 = predict(m1),
  error_m1 = Love4Taylor - prediction_m1,
  squared_error_m0 = error_m0^2,
  squared_error_m1 = error_m1^2
)
Código
love |>
  select(ID, Love4Taylor, matches("_m0$"), matches("_m1$")) |>
  rename(
    Pessoa = ID, Observado = Love4Taylor,
    `Prev. m0` = prediction_m0, `Res. m0` = error_m0,
    `e² m0` = squared_error_m0,
    `Prev. m1` = prediction_m1, `Res. m1` = error_m1,
    `e² m1` = squared_error_m1
  ) |>
  datatable(
    rownames = FALSE,
    options = list(pageLength = 8, lengthChange = FALSE, scrollX = TRUE)
  ) |>
  formatRound(columns = 2:8, digits = 2)
Para a mesma pessoa, mudar de modelo muda a previsão e o resíduo. Algumas distâncias à previsão diminuem; outras podem aumentar. Os quadrados impedem que resíduos positivos e negativos se anulem. A soma dos quadrados de todas as observações, e não apenas das linhas visíveis na tabela, é o \(SSE\) de cada modelo:
Da Redução do Erro à Estatística F
O t que recuperámos do capítulo anterior mede a distância entre a média amostral e zero em erros-padrão. Podemos avaliar a mesma hipótese a partir dos dois modelos que acabámos de ajustar: quanto erro poupamos quando deixamos de obrigar a previsão a ser zero e estimamos o intercepto?
Para responder, precisamos de comparar a redução do erro com o erro que ainda ficou e com o número de parâmetros acrescentados.
Para dois modelos lineares aninhados,
\[ F= \frac{\frac{SSE_0-SSE_1}{p_1-p_0}} {\frac{SSE_1}{N-p_1}}. \]
Aqui, \(p_1-p_0\) é precisamente a diferença de complexidade entre os modelos. É o \(df_1\) da comparação: quantos parâmetros adicionais libertámos ao passar do modelo compacto para o aumentado. Quando acrescentamos um factor, é também o número de graus de liberdade desse factor. O denominador usa os graus de liberdade residuais do modelo aumentado, \(df_2=N-p_1\).
Vamos resolver a equação com os nossos dados.
O modelo compacto tem
\[ SSE_0=74.75, \]
e o modelo aumentado tem
\[ SSE_1=58.78. \]
Libertámos um parâmetro, por isso
\[ MSR = \frac{SSE_0-SSE_1}{1} = \frac{74.75-58.78}{1} = 15.97. \]
O erro que ainda ficou no modelo aumentado é
\[ MSE = \frac{SSE_1}{N-p_1} = \frac{58.78}{49} = 1.2. \]
Logo,
\[ F = \frac{MSR}{MSE} = \frac{15.97}{1.2} = 13.32. \]
Neste exemplo, libertámos um único parâmetro: o intercepto. A redução do erro produz exactamente o quadrado da estatística t calculada no capítulo anterior:
\[ \boxed{F=t^2}. \]
Esta igualdade é exacta, embora os números apresentados estejam arredondados. O valor-p também coincide com o do teste t bilateral, aproximadamente 6.38^{-4}: os dois procedimentos avaliam a mesma hipótese. O F torna-se especialmente útil quando precisamos de testar vários parâmetros em conjunto.
NotaPorque É Que F = t²?
Se uma hipótese pode ser escrita como «este coeficiente é zero», então podemos testá-la olhando para o coeficiente e o seu erro-padrão ou comparando o modelo com e sem esse parâmetro. Vamos mostrar por que razão estas duas contas são, no fundo, a mesma. Primeiro, seguimos a álgebra dos modelos. Depois, chegamos à mesma relação pelas distribuições de probabilidade, o que também explica a igualdade dos valores-p.
Pela Álgebra da Comparação de Modelos
Comecemos pelo exemplo de uma amostra que acabámos de resolver. O teste-t habitual pergunta se \(\mu=0\). Como o intercepto do modelo aumentado é a média, esta hipótese escreve-se também \(H_0:\beta_0=0\). O modelo compacto prevê zero para todas as observações e o aumentado prevê a média amostral \(\bar Y\). Uma identidade útil para qualquer conjunto de \(N\) observações é
\[ \sum_{i=1}^{N}Y_i^2 = \sum_{i=1}^{N}(Y_i-\bar Y)^2+N\bar Y^2. \]
Assim, a melhoria obtida ao estimar a média é
\[ SSE_0-SSE_1=N\bar Y^2. \]
O modelo aumentado estima um parâmetro. Logo, os seus graus de liberdade residuais são \(N-1\), e o quadrado médio residual é a variância amostral,
\[ MSE=\frac{SSE_1}{N-1}=s^2. \]
Substituindo na fórmula de comparação de modelos,
\[ F =\frac{\frac{SSE_0-SSE_1}{1}}{\frac{SSE_1}{N-1}} =\frac{N\bar Y^2}{s^2}. \]
Mas o teste t de uma amostra contra a média nula zero usa
\[ t=\frac{\bar Y}{\frac{s}{\sqrt{N}}}. \]
Elevando-o ao quadrado,
\[ t^2 =\frac{\bar Y^2}{\frac{s^2}{N}} =\frac{N\bar Y^2}{s^2} =F. \]
Nesta comparação, portanto, \(df_1=1\) e \(df_2=N-1\), precisamente os graus de liberdade do teste t.
Passemos agora aos dois grupos, com a codificação -1/+1 usada nesta página. Chamemos A ao grupo codificado como \(-1\) e B ao grupo codificado como \(+1\). O modelo compacto prevê uma única média, enquanto o aumentado admite duas:
\[ m_0:\quad \widehat Y_i=\beta_0, \qquad m_1:\quad \widehat Y_i=\beta_0+\beta_1X_i, \quad X_i\in\{-1,+1\}. \]
No modelo aumentado, as previsões para cada grupo são
\[ \widehat Y_A=\hat\beta_0-\hat\beta_1=\bar Y_A, \qquad \widehat Y_B=\hat\beta_0+\hat\beta_1=\bar Y_B. \]
Subtraindo as duas equações, obtemos
\[ \boxed{\hat\beta_1=\frac{\bar Y_B-\bar Y_A}{2}}. \]
Ou seja, o coeficiente do contraste é metade da diferença entre médias. Assim, a hipótese habitual de igualdade das médias,
\[ H_0:\mu_A=\mu_B, \]
é exactamente a restrição \(H_0:\beta_1=0\) no modelo com um preditor -1/+1. Iremos agora ver que as estatísticas também coincidem. Isto vale quando os grupos têm tamanhos diferentes, embora o intercepto do modelo aumentado seja o ponto médio das duas médias (e não necessariamente a média de todas as observações).
Se \(n_A\) e \(n_B\) forem os tamanhos dos grupos, \(N=n_A+n_B\) e \(s_p^2\) a estimativa comum da variância residual, o erro-padrão da diferença entre médias é
\[ SE_{\mathrm{dif}} =s_p\sqrt{\frac{1}{n_A}+\frac{1}{n_B}}. \]
Como o contraste estima metade dessa diferença, o seu erro-padrão também é metade:
\[ SE_{\hat\beta_1} =\frac{SE_{\mathrm{dif}}}{2} =\frac{s_p}{2}\sqrt{\frac{1}{n_A}+\frac{1}{n_B}}. \]
O teste t do coeficiente representa, portanto, o mesmo teste da diferença entre médias:
\[ t =\frac{\hat\beta_1}{SE_{\hat\beta_1}} =\frac{\frac{\bar Y_B-\bar Y_A}{2}}{\frac{SE_{\mathrm{dif}}}{2}} =\frac{\bar Y_B-\bar Y_A}{SE_{\mathrm{dif}}}. \]
Voltemos agora ao F e às somas de quadrados. O modelo compacto tem \(p_0=1\) parâmetro, enquanto o aumentado tem \(p_1=2\). A melhoria no ajuste é a soma de quadrados entre grupos:
\[ \begin{aligned} SSE_0-SSE_1 &=n_A(\bar Y_A-\bar Y)^2+n_B(\bar Y_B-\bar Y)^2\\ &=\frac{n_A n_B}{N}(\bar Y_B-\bar Y_A)^2\\ &=\frac{4n_A n_B}{N}\hat\beta_1^2. \end{aligned} \]
Aqui, \(\bar Y=(n_A\bar Y_A+n_B\bar Y_B)/N\) é a média global que o modelo compacto prevê. O modelo aumentado tem \(N-2\) graus de liberdade residuais, pelo que
\[ \frac{SSE_1}{N-p_1} =\frac{SSE_1}{N-2} =s_p^2. \]
Estamos finalmente em condições de ligar a fórmula geral de comparação de modelos ao teste do coeficiente, sem saltar nenhum passo:
\[ \begin{aligned} F &=\frac{\frac{SSE_0-SSE_1}{p_1-p_0}}{\frac{SSE_1}{N-p_1}}\\[4pt] &=\frac{\frac{4n_A n_B}{N}\hat\beta_1^2}{s_p^2}\\[4pt] &=\frac{\hat\beta_1^2} {\frac{s_p^2}{4}\left(\frac{1}{n_A}+\frac{1}{n_B}\right)}\\[4pt] &=\frac{\hat\beta_1^2}{SE_{\hat\beta_1}^2}\\[4pt] &=\left(\frac{\hat\beta_1}{SE_{\hat\beta_1}}\right)^2 =t^2. \end{aligned} \]
Na terceira linha usámos \(1/n_A+1/n_B=N/(n_A n_B)\). Temos \(df_1=p_1-p_0=1\) e \(df_2=N-p_1=N-2\), que coincide com os graus de liberdade do teste t de Student para dois grupos.
Podemos escrever a mesma conclusão em termos da diferença entre médias:
\[ \boxed{ \frac{\frac{SSE_0-SSE_1}{1}}{\frac{SSE_1}{N-2}} = \left(\frac{\hat\beta_1}{SE_{\hat\beta_1}}\right)^2 = \left(\frac{\bar Y_B-\bar Y_A}{SE_{\mathrm{dif}}}\right)^2. } \]
O factor foi representado com -1/+1, pelo que o coeficiente e o respectivo erro-padrão são ambos metade dos valores da diferença entre médias. Os factores de escala cancelam-se na divisão. A maneira de escrever os parâmetros não alterou o teste.
E numa regressão com vários preditores? A identidade continua a valer para cada coeficiente que acrescentamos isoladamente. Suponhamos que temos um modelo compacto com intercepto e outros preditores, e que o modelo aumentado acrescenta \(X\) com coeficiente \(\beta_X\). A hipótese \(H_0:\beta_X=0\) pergunta se \(X\) ainda acrescenta alguma coisa depois dos restantes preditores.
Para mostrar as contas, podemos retirar de \(X\) e de \(Y\) a parte prevista pelos preditores que já estavam no modelo compacto. Chamemos \(\tilde X_i\) e \(\tilde Y_i\) a esses resíduos. A estimativa do novo declive é
\[ \hat\beta_X =\frac{\sum_i\tilde X_i\tilde Y_i} {\sum_i\tilde X_i^2}. \]
Definindo \(S_{XX}=\sum_i\tilde X_i^2\), a redução da soma de quadrados dos resíduos ao acrescentar \(X\) é
\[ SSE_0-SSE_1=\hat\beta_X^2 S_{XX}. \]
A variância residual estimada no modelo aumentado é \(MSE=SSE_1/(N-p_1)\). O erro-padrão do coeficiente é, então,
\[ SE_{\hat\beta_X}=\sqrt{\frac{MSE}{S_{XX}}}. \]
Como \(p_1-p_0=1\), obtemos imediatamente
\[ \begin{aligned} F &=\frac{\frac{SSE_0-SSE_1}{1}}{MSE}\\ &=\frac{\hat\beta_X^2 S_{XX}}{MSE}\\ &=\frac{\hat\beta_X^2}{SE_{\hat\beta_X}^2}\\ &=\left(\frac{\hat\beta_X}{SE_{\hat\beta_X}}\right)^2=t^2. \end{aligned} \]
É por isto que a linha de um preditor que acrescenta um único coeficiente numa tabela ANOVA ajustada tem exactamente o F correspondente ao quadrado do t desse coeficiente. Ambos avaliam a restrição \(\beta_X=0\), mantendo o resto do modelo.
Pelas Distribuições de Probabilidade
Podemos demonstrar uma relação mais geral sem começar por uma amostra específica. Uma variável aleatória \(T\) com distribuição t de Student e \(\nu\) graus de liberdade pode ser construída como
\[ T=\frac{Z}{\sqrt{\frac{U}{\nu}}}, \]
onde \(Z\sim N(0,1)\), \(U\sim\chi^2_\nu\) e as duas variáveis são independentes. Ao elevar ao quadrado,
\[ T^2=\frac{Z^2}{\frac{U}{\nu}}. \]
O quadrado de uma normal padrão segue uma distribuição qui-quadrado com um grau de liberdade:
\[ Z^2\sim\chi^2_1. \]
Recordemos agora a definição de uma variável com distribuição F. Se \(V_1\) e \(V_2\) são qui-quadrados independentes, com graus de liberdade \(d_1\) e \(d_2\), então
\[ \frac{\frac{V_1}{d_1}}{\frac{V_2}{d_2}}\sim F_{d_1,d_2}. \]
No nosso caso, o numerador é \(Z^2/1\) e o denominador é \(U/\nu\). Logo,
\[ \boxed{T_\nu^2\sim F_{1,\nu}}. \]
Isto explica a correspondência dos graus de liberdade. O numerador da distribuição F tem um grau de liberdade porque corresponde ao quadrado de uma única normal padrão. O denominador conserva os \(\nu\) graus de liberdade do denominador da distribuição t.
O Que Acontece ao Valor-p?
Como a distribuição t é simétrica e o quadrado elimina o sinal,
\[ P\bigl(|T_\nu|\geq |t_{\mathrm{obs}}|\bigr) = P\bigl(F_{1,\nu}\geq t_{\mathrm{obs}}^2\bigr). \]
Por isso, o teste t bilateral e o teste F equivalente produzem o mesmo valor-p. Um t de \(-2.5\) ou de \(+2.5\) dá sempre \(F=6.25\). O F conserva a magnitude da evidência contra a restrição, mas perde a direcção da diferença. Um teste t unilateral responde a outra pergunta.
O mesmo valor-p resulta de termos a mesma hipótese, os mesmos dados e a mesma estimativa do erro, vistos através de duas estatísticas equivalentes. A identidade algébrica mantém-se mesmo sem normalidade dos dados. Para usar as distribuições nulas t e F exactas, precisamos dos pressupostos probabilísticos habituais.
Se quiser explorar as demonstrações com mais detalhe, a Penn State, STAT 501 mostra a equivalência entre o teste t do declive e o teste F de uma regressão simples. O Book of Statistical Proofs, definição da distribuição t e a definição da distribuição F permitem reconstruir o segundo argumento directamente a partir das distribuições.
A conclusão é simples: duas expressões matematicamente equivalentes continuam a ser a mesma conta, independentemente do nome do teste. Quando a hipótese exige libertar vários parâmetros, como acontece com um factor de quatro níveis, o F permite testá-los em conjunto. Continuamos a perguntar quanto erro desapareceu ao libertar a restrição, relativamente ao erro que ficou.
Interpretar a Comparação
Depois de calcularmos o F, não precisamos de aprender uma nova definição de valor-p. O software pergunta quão incompatível é um F pelo menos tão grande como o observado com o modelo compacto, usando a distribuição F adequada aos graus de liberdade.
A interpretação é a que já construímos em Do t ao Valor-p. O que mudou foi a estatística cuja distribuição nula usamos, não o significado do valor-p.
Assim, quando testamos um único coeficiente, o F e o t bilateral dão o mesmo valor-p. Mudar de fórmula não mudou a evidência contra a hipótese nula.
ImportanteO Que Deve Ficar
Começámos por testar se uma média difere de zero. Com o t, dividimos essa média pelo seu erro-padrão. Com o F, perguntámos quanto erro perdemos ao obrigar o intercepto a ser zero. Era a mesma hipótese, e obtivemos o mesmo valor-p.
Vamos agora usar preditores quantitativos e factores, juntar vários preditores e testar interacções. As fórmulas vão crescer, mas a ideia mantém-se: escrever a hipótese como uma restrição num modelo e avaliar o que acontece quando a libertamos.
2 Do Caso Mais Familiar às Variáveis Categóricas
Um Preditor Quantitativo: Regressão Linear
Pergunta de investigação: o número de mortes de peixes-boi aumenta à medida que aumenta o número de barcos a motor registados?
No exemplo anterior, estimar uma média era o passo a mais. Agora, a média é o ponto de partida: o modelo compacto prevê a mesma coisa para todos os anos. Acrescentemos um preditor quantitativo, para permitir que a previsão varie com o número de barcos. O modelo passa a escrever-se:
\[\hat Y=\beta_0+\beta_1X.\]
Neste modelo, \(\beta_1\) representa a mudança prevista em \(Y\) por cada unidade adicional de \(X\). É o declive da recta.
Um Modelo Faz Previsões
A equação é também uma máquina de fazer previsões. Escolhemos um valor de \(X\), substituímo-lo na equação e obtemos o valor previsto:
\[ \hat Y(X)=\beta_0+\beta_1X. \]
Podemos fazê-lo para um valor que observámos. Se um ano tiver \(X=700\) milhares de barcos registados, por exemplo, a previsão do modelo é simplesmente
\[ \hat Y(700)=\beta_0+700\beta_1. \]
Também podemos resolver a equação para um valor substantivamente interessante que não corresponda exactamente a nenhuma linha da base de dados. Se \(\mu_X\) for a média populacional do número de barcos, então
\[ \hat Y(\mu_X)=\beta_0+\beta_1\mu_X \]
é a previsão para esse ponto. Mais tarde faremos exactamente isto com factores: colocaremos os contrastes nos valores que representam a pergunta e resolveremos o mesmo tipo de equação.
A Previsão Não É a Observação
A recta fornece a parte prevista pelo modelo. Uma observação individual inclui ainda aquilo que o modelo não explicou:
\[ Y_i=\hat Y_i+e_i. \]
Duas observações com o mesmo \(X\) recebem a mesma previsão do modelo, mas não têm de apresentar o mesmo \(Y\). A distância vertical entre a observação e a previsão é o resíduo nos dados; no modelo populacional, \(\varepsilon\) representa a componente de erro.
AvisoO Modelo Consegue Extrapolar Mais Longe do Que Nós Devemos
A equação não sabe quais valores de \(X\) fazem sentido no mundo. Se escrevermos \(X=10000\), ela produz alegremente
\[ \hat Y(10000)=\beta_0+10000\beta_1. \]
Matematicamente, uma recta pode continuar indefinidamente. Metodologicamente, uma previsão muito para além da região observada exige que a relação continue aproximadamente linear nesse novo domínio. Substantivamente, alguns valores podem nem sequer ser possíveis — por exemplo, uma idade humana de 10 000 anos.
Portanto, conseguir calcular uma previsão não basta para a tornar uma boa previsão. O domínio da variável e o processo que gerou os dados fazem parte da interpretação do modelo.
Esta questão voltará a ser central quando a variável resposta tiver limites naturais. Uma probabilidade, por exemplo, tem de ficar entre 0 e 1; uma recta não conhece esse limite. Mais adiante veremos modelos cuja própria forma respeita esse tipo de restrição.
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 34 | 29273.886 | NA | NA | NA | NA |
| 33 | 3886.267 | 1 | 25387.62 | 215.5774 | 0 |
summary(m1)
Call:
lm(formula = ManateeDeaths ~ Powerboats, data = manatees)

Residuals:
    Min      1Q  Median      3Q     Max
-21.023  -5.645  -0.885   6.522  28.252

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) -57.12918    8.05671  -7.091 4.05e-08 ***
Powerboats    0.15237    0.01038  14.683 5.00e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 10.85 on 33 degrees of freedom
Multiple R-squared:  0.8672,    Adjusted R-squared:  0.8632
F-statistic: 215.6 on 1 and 33 DF,  p-value: 4.998e-16
A comparação pergunta se permitir um declive reduz o erro face ao modelo que prevê apenas a média. Outra vez, acrescentámos um parâmetro, portanto o F da comparação é o quadrado do t do declive.
Correlação
Numa regressão simples com intercepto, se centrarmos e padronizarmos \(X\) e \(Y\), o declive é a correlação de Pearson \(r\). Além disso, nesse caso simples, \(R^2=r^2\).
Podemos verificar com os mesmos dados dos peixes-boi. A função scale() subtrai a média e divide pelo desvio-padrão de cada variável. Assim, o declive deixa de representar mortes por milhar de barcos e passa a representar a associação em unidades de desvio-padrão:
scale(Powerboats)
0.9312597 pearson$estimate cor
0.9312597 O declive padronizado e a correlação têm o mesmo valor. Também podemos comparar os valores-p: o teste de Pearson em cor.test(), o teste t do declive apresentado por summary() e o teste F entre os modelos compacto e aumentado de anova(m0, m1) respondem à mesma hipótese de associação linear nula.
| method | p_value |
|---|---|
| Pearson: cor.test() | 0 |
| Slope t: summary() | 0 |
| Models F: anova() | 0 |
Os três valores-p coincidem porque, numa regressão linear simples com intercepto, os testes correspondem à mesma restrição, com os mesmos dados e a estimativa usual da variância residual. Esta equivalência algébrica não garante, por si só, que os pressupostos de inferência sejam adequados a uma série de observações anuais.
Podemos por isso olhar para a correlação como mais um caso particular desta mesma regressão. A padronização muda a escala dos coeficientes, mas não a relação representada pelos dados.
NotaUma Ideia a Que Voltaremos: Centrar Preditores
Centrar significa subtrair um valor de referência — muitas vezes a média — a um preditor. Numa regressão simples isso desloca o ponto onde lemos o intercepto; não muda o declive nem as previsões. Mais tarde, quando aparecerem interacções, centrar vai tornar-se especialmente útil porque muda onde são avaliados os efeitos de ordem inferior. Voltaremos ao que se ganha e ao que se perde com essa escolha.
Vários Preditores: Uma Tabela de Comparações
Pergunta de investigação: que características da água ainda ajudam a prever o oxigénio quando as restantes já estão no modelo?
Nada nos obriga a parar num único \(X\):
\[ \hat Y=\beta_0+\beta_1X_1+\beta_2X_2+\beta_3X_3+\ldots \]
Agora aparece uma distinção essencial. Testar Temp sozinha não é a mesma coisa que testar Temp num modelo que já contém pH, NTU e Conductivity. No modelo múltiplo perguntamos se Temp ainda reduz o erro depois de permitirmos que os outros preditores façam o seu trabalho.
O Conjunto de Preditores: Teste Omnibus
Comecemos pela pergunta global: o conjunto inteiro de preditores melhora a previsão relativamente a uma única média? Ajustamos um modelo aditivo, sem interacções, com quatro preditores quantitativos:
water <- read.csv("../data/WaterQualityTesting.csv")
colnames(water) <- c("Sample", "pH", "Temp", "NTU", "Oxygen", "Conductivity")
water <- drop_na(water, Oxygen, pH, Temp, NTU, Conductivity)

m_intercept <- lm(Oxygen ~ 1, data = water)
m_full <- lm(Oxygen ~ pH + Temp + NTU + Conductivity, data = water)

anova(m_intercept, m_full)| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 499 | 337.4916 | NA | NA | NA | NA |
| 495 | 104.8176 | 4 | 232.6739 | 274.6999 | 0 |
summary(m_full)
Call:
lm(formula = Oxygen ~ pH + Temp + NTU + Conductivity, data = water)

Residuals:
     Min       1Q   Median       3Q      Max
-2.55259 -0.17601  0.03673  0.26211  1.62329

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)  -19.635139   1.591156 -12.340  < 2e-16 ***
pH             2.626421   0.257724  10.191  < 2e-16 ***
Temp          -0.016087   0.024754  -0.650    0.516
NTU           -0.417950   0.053411  -7.825 3.09e-14 ***
Conductivity   0.032833   0.002212  14.846  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.4602 on 495 degrees of freedom
Multiple R-squared:  0.6894,    Adjusted R-squared:  0.6869
F-statistic: 274.7 on 4 and 495 DF,  p-value: < 2.2e-16
O F no fim de summary(m_full) é o mesmo de anova(m_intercept, m_full). O modelo compacto estima um parâmetro; o aumentado estima cinco. Testamos simultaneamente
\[ H_0:\beta_{\mathrm{pH}}=\beta_{\mathrm{Temp}} =\beta_{\mathrm{NTU}}=\beta_{\mathrm{Conductivity}}=0. \]
Esta é a primeira comparação do percurso em que \(df_1=4\), em vez de 1. O teste é omnibus: pergunta se precisamos do conjunto de quatro declives. Não existe um único t de coeficiente cujo quadrado seja este F. Isso não significa que os testes individuais deixem de existir; respondem a outras restrições.
A utilidade do omnibus não se reduz a evitar muitos testes. «Algum destes preditores acrescenta capacidade explicativa ao modelo?» é uma pergunta científica diferente de uma lista de perguntas sobre cada coeficiente.
Cada Preditor: Testes Parciais
Para reunir as perguntas ajustadas numa tabela, usamos Anova() do pacote car, com Tipo III. Neste modelo aditivo, os testes dos preditores coincidem com os de Tipo II: cada termo é avaliado depois de todos os outros. Vamos manter Tipo III como convenção e voltar à diferença com interacções.
Anova(m_full, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 32.2456898 | 1 | 152.2798585 | 0.000000 |
| pH | 21.9911133 | 1 | 103.8527517 | 0.000000 |
| Temp | 0.0894279 | 1 | 0.4223222 | 0.516082 |
| NTU | 12.9663764 | 1 | 61.2335471 | 0.000000 |
| Conductivity | 46.6706267 | 1 | 220.4014393 | 0.000000 |
| Residuals | 104.8176469 | 495 | NA | NA |
A tabela ANOVA pode ser lida como uma pequena colecção de comparações de modelos. Para a linha de Temp, por exemplo:
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 496 | 104.9071 | NA | NA | NA | NA |
| 495 | 104.8176 | 1 | 0.0894279 | 0.4223222 | 0.516082 |
A linha pergunta se libertar o parâmetro de Temp reduz suficientemente o erro mantendo os outros preditores no modelo. É a mesma hipótese \(H_0:\beta_{\mathrm{Temp}}=0\) que o teste t do coeficiente de Temp avalia em summary(m_full). Um testa a melhoria do modelo, o outro estandardiza o declive. Os dois chegam à mesma conclusão e ao mesmo valor-p. Podemos construir uma comparação análoga para cada termo. car::Anova() organiza essas perguntas numa tabela.
NotaSomas de Quadrados: Sequenciais ou Ajustadas?
As designações Tipo I, II e III identificam formas de construir os testes dos termos de um modelo. A distinção torna-se útil agora que temos vários preditores.
Com um único objecto lm, anova(m_full) produz uma tabela Tipo I, sequencial: cada termo entra depois dos que o precedem na fórmula. Em y ~ x1 + x2, a linha de x1 mede a melhoria depois do intercepto; a de x2 mede a melhoria depois de x1. Se os preditores partilharem informação, trocar a ordem pode mudar as somas de quadrados e os testes. Os testes F da tabela usam a variância residual do modelo completo.
A pergunta que formulámos para a água é ajustada: queremos saber o contributo de cada preditor com todos os restantes já no modelo. É essa a comparação que os Tipos II e III fazem para os termos explicativos num modelo aditivo de posto completo, com intercepto. Por isso, coincidem aqui, incluindo modelos aditivos com vários factores ou com factores e covariáveis. A interpretação de Tipo III com interacções ficará para a nota do modelo factorial.
Nos modelos com intercepto e um único termo explicativo, essa escolha não alterava o teste do declive ou do factor. Um factor com vários níveis continua a ser um único termo, testado conjuntamente pelos seus \(k-1\) contrastes. No teste de uma amostra, comparámos directamente o modelo de previsão zero com o modelo que estima um intercepto. A coincidência dos testes dos preditores não implica que todas as funções apresentem a mesma tabela ou testem o intercepto.
Quando escrevemos anova(m_sem_temp, m_com_temp), escolhemos nós os dois modelos a comparar. Essa chamada testa a comparação explícita, como já vínhamos a fazer. A tabela sequencial é o comportamento de anova() com um só modelo, descrito na documentação de anova.lm().
Uma sequência Tipo I é útil quando a ordem representa a pergunta científica, por exemplo testar se um segundo bloco de preditores melhora um modelo que já contém um primeiro bloco. Para as perguntas termo a termo deste capítulo, usamos a tabela ajustada.
Cada preditor quantitativo acrescenta aqui um único coeficiente. É por isso que, para a linha correspondente da tabela ANOVA ajustada,
\[ \boxed{ F_{\mathrm{termo}} = \left(\frac{\hat\beta_{\mathrm{termo}}} {SE_{\hat\beta_{\mathrm{termo}}}}\right)^2 =t_{\mathrm{termo}}^2. } \]
Testar se a inclusão do preditor reduz o erro é a mesma hipótese que testar se o seu declive, depois de considerados os restantes preditores, difere de zero. A tabela ANOVA e a tabela de coeficientes de regressão apresentam duas formas de ler a mesma comparação.
Assim, a mesma saída de summary(m_full) contém ts parciais por coeficiente e um F omnibus no fim. Nas linhas dos quatro preditores de Anova(m_full, type = "III"), \(df_1=1\) e \(F=t^2\); no omnibus, \(df_1=4\) e essa identidade com um único t não se aplica. O sinal do declive vem da estimativa ou do t, não de \(\sqrt F\), que dá apenas \(|t|\).
Mais adiante veremos a mesma lógica omnibus quando um único factor precisar de vários parâmetros. Perguntemos sempre que modelo compacto está por trás de cada teste. A linha (Intercept) de Tipo III testa o intercepto a zero com os restantes termos no modelo; não é o teste omnibus dos preditores.
Até aqui todos os termos são aditivos: o declive de Temp não depende de NTU, e vice-versa. Mais tarde vamos libertar precisamente essa restrição.
Dois Grupos
Pergunta de investigação: há uma diferença média de massa corporal entre dois grupos de pinguins?
Acabámos de ajustar uma regressão em que \(X\) era um número. Mas agora o preditor é um factor: por exemplo, sex contém níveis como female e male.
Podemos até pedir directamente ao R:
Código
ds <- drop_na(penguins, body_mass_g, sex)

lm(body_mass_g ~ sex, data = ds,
   contrasts = list(sex = contr.treatment(2)))
Call:
lm(formula = body_mass_g ~ sex, data = ds, contrasts = list(sex = contr.treatment(2)))

Coefficients:
(Intercept)         sex2
     3862.3        683.4
O R ajusta um modelo linear sem dificuldade. Mas a equação continua a ser
\[ \hat Y=\beta_0+\beta_1X. \]
Como multiplicamos \(\beta_1\) pela palavra «female»? Não multiplicamos. Precisamos de transformar os níveis do factor numa ou mais colunas numéricas. Essa transformação chama-se codificação por contrastes.
Codificar com 0 e 1
Uma possibilidade é escolher um grupo como referência:
| Grupo | \(X\) |
|---|---|
| A | 0 |
| B | 1 |
Para A,
\[ \hat Y_A=\beta_0+\beta_1(0)=\beta_0. \]
Para B,
\[ \hat Y_B=\beta_0+\beta_1(1)=\beta_0+\beta_1. \]
Portanto, \(\beta_0\) é a média de A e \(\beta_1\) é (B-A). O zero funciona como baseline: quando \(X=0\), ficamos apenas com o intercepto.
Esta codificação, chamada frequentemente treatment coding, é a escolha por defeito do R para factores não ordenados. É muito natural quando existe uma categoria de referência substantiva. Podemos ver a coluna criada pelo R:
contr.treatment(c("female", "male")) male
female 0
male 1m_treatment <- lm(body_mass_g ~ sex, data = ds,
contrasts = list(sex = contr.treatment(2)))Neste exemplo, female é a referência porque é o primeiro nível do factor, não porque tenha um estatuto biológico especial.
Uma Codificação Centrada: -1 e +1
Nem sempre existe um grupo que mereça ser a baseline. Além disso, queremos uma codificação que continue a dar interpretações úteis quando chegarmos a modelos factoriais e interacções. Neste capítulo vamos por isso usar sobretudo contrastes centrados.
Com dois grupos:
| Grupo | \(X\) |
|---|---|
| A | -1 |
| B | +1 |
então
\[ \hat Y_A=\beta_0-\beta_1,\qquad \hat Y_B=\beta_0+\beta_1. \]
Logo, \(\beta_0\) fica a meio das duas médias e \(2\beta_1=B-A\). Mudámos a forma de escrever as duas médias, não as médias que o modelo consegue reproduzir.
Deixamos agora o R construir a coluna soma-zero. A partir daqui usamos esta convenção para os factores não ordenados, antes de ajustar os modelos:
       [,1]
female    1
male     -1
Call:
lm(formula = body_mass_g ~ sex, data = ds)

Residuals:
    Min      1Q  Median      3Q     Max
-1295.7  -595.7  -237.3   737.7  1754.3

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   4204.0       40.0 105.088  < 2e-16 ***
sex1          -341.7       40.0  -8.542  4.9e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 730 on 331 degrees of freedom
Multiple R-squared:  0.1806,    Adjusted R-squared:  0.1781
F-statistic: 72.96 on 1 and 331 DF, p-value: 4.897e-16anova(m0, m1)| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 332 | 215259666 | NA | NA | NA | NA |
| 331 | 176380769 | 1 | 38878897 | 72.96099 | 0 |
Atenção à ordem: contr.sum() atribui +1 ao primeiro nível (female) e -1 ao segundo (male). Na tabela algébrica acima, A é portanto male e B é female. O coeficiente sex1 é metade de female − male. Não existe aqui um grupo de referência: o intercepto é o ponto médio das duas médias, mesmo que os grupos tenham tamanhos diferentes. A última categoria fecha a restrição de soma zero; não funciona como baseline.
summary(m1) mostra o t deste coeficiente e anova(m0, m1) mostra o F da mesma comparação. As previsões são as mesmas do modelo de tratamento; mudaram a origem e a escala dos coeficientes.
Com dois grupos, o modelo com um preditor -1/+1 prevê uma média para cada grupo. O teste-t de Student para a diferença entre médias, o t do coeficiente sex1 e o F da comparação entre os dois modelos testam exactamente \(H_0:\mu_A=\mu_B\). O coeficiente sex1 representa metade da diferença entre a média das fêmeas e a dos machos. Como \(\hat\beta_1=(\bar Y_B-\bar Y_A)/2\) e \(SE_{\hat\beta_1}=SE_{\mathrm{dif}}/2\),
\[ F=t^2= \left(\frac{\hat\beta_1}{SE_{\hat\beta_1}}\right)^2 = \left(\frac{\bar Y_B-\bar Y_A}{SE_{\mathrm{dif}}}\right)^2. \]
Esta equivalência usa a estimativa comum da variância residual do modelo linear, como no teste de Student para duas amostras. É a mesma hipótese, expressa por estatísticas equivalentes.
NotaStudent e Welch Não São a Mesma Coisa
O teste de Welch usa outra estimativa da incerteza quando não queremos assumir uma variância comum aos grupos. O contraste continua a representar a diferença entre médias; muda a forma como essa diferença é estandardizada para a inferência.
Das Colunas de Contraste às Médias
A álgebra explica o modelo, mas não precisamos de refazer as contas sempre que queremos uma média. emmeans() calcula as médias marginais estimadas (estimated marginal means, EMMs), com erros-padrão e intervalos de confiança:
emmeans(m1, ~ sex) sex emmean SE df lower.CL upper.CL
female 3862 56.8 331 3750 3974
male 4546 56.3 331 4435 4656
Confidence level used: 0.95 Neste modelo só com um factor, são as médias observadas dos dois grupos. Podemos concentrar a interpretação nessas médias, sem confundir um coeficiente soma-zero com a diferença inteira. Quando chegarmos a mais de dois grupos, pediremos também comparações aos pares; por agora, há uma única diferença e o teste do factor já responde à pergunta de igualdade das duas médias.
Dois Vocabulários Para a Mesma Família
É frequente a regressão ser ensinada com palavras como previsão, declive, intercepto, resíduo e variável explicativa. Essa linguagem é natural em muitas aplicações quantitativas, incluindo engenharia, calibração, previsão e modelação de processos. A tradição da ANOVA cresceu muito ligada ao delineamento experimental, onde falamos mais de factores, níveis, efeitos, interacções e decomposição da variância. O desenvolvimento de ANOVA e do delineamento experimental ficou particularmente associado ao trabalho de Fisher no início do século XX.
Estas tradições desenvolveram nomes e formas de apresentar resultados diferentes. É uma diferença em boa medida cultural. Por exemplo, comparar duas médias ou testar o declive de um preditor -1/+1 é a mesma operação matemática. Uma expressão equivalente não passa a ser um teste diferente por lhe chamarmos regressão, ANOVA ou teste-t. Os vocabulários continuam a ser úteis porque chamam a atenção para aspectos diferentes do problema. Mas os números não sabem a que tradição pertencemos.
NotaAs Origens da Regressão e da ANOVA
A história completa é muito mais longa do que «regressão veio da engenharia e ANOVA veio da Psicologia». Regressão e mínimos quadrados têm raízes em astronomia, geodesia e biometria; ANOVA foi desenvolvida no contexto da estatística matemática e do delineamento experimental, com enorme influência dos trabalhos de Fisher. O ponto pedagógico aqui é apenas que as tradições de uso deixaram linguagens diferentes para a mesma família de modelos.
Mais de Dois Grupos
Até agora, sempre que usámos um factor ele tinha apenas dois níveis e, por isso, cabia numa única coluna de contraste. Agora podemos finalmente perguntar: o que muda quando o factor tem três ou mais níveis?
Pergunta de investigação: a massa corporal média é a mesma nas três espécies de pinguins, ou precisamos de permitir médias diferentes?
Com dois grupos resolvemos o problema com uma única coluna -1/+1. E com três?
Poderíamos escrever simplesmente 1, 2 e 3:
| Grupo | \(X\) |
|---|---|
| A | 1 |
| B | 2 |
| C | 3 |
Mas isso já não representa «três grupos» em geral. Impõe uma estrutura: as médias previstas têm de ficar sobre uma recta e a passagem de A para B tem de ser igual à passagem de B para C. Poderíamos acrescentar um termo quadrático, mas estaríamos novamente a impor uma forma particular. Isso faz sentido para níveis quantitativos ou ordenados quando essa forma é a hipótese. Não resolve o problema geral de um factor nominal.
A pista vem do caso com dois grupos. Uma coluna permitia representar uma direcção de diferença. Com três médias há duas direcções independentes de diferença. Por exemplo, podemos construir uma comparação que distingue A de B e outra que acrescenta a informação necessária para localizar C.
Não precisamos de testar os três pares (A-B), (A-C) e (B-C) para saber se as três médias podem ser iguais. Depois de conhecermos duas diferenças independentes, a terceira já está determinada:
\[ A-C=(A-B)+(B-C). \]
É esta a razão para a regra geral:
Um factor com \(k\) níveis precisa de \(k-1\) contrastes independentes para representar livremente as suas \(k\) médias, além do intercepto.
O teste F pode então perguntar de uma só vez se esses \(k-1\) parâmetros são necessários. É a hipótese omnibus da ANOVA: podemos obrigar simultaneamente todos os contrastes do factor a zero, ou perdemos demasiada explicação?
Para três espécies podemos usar, por exemplo, a codificação soma-zero produzida por contr.sum(3):
| Espécie | \(C_1\) | \(C_2\) |
|---|---|---|
| Adelie | 1 | 0 |
| Chinstrap | 0 | 1 |
| Gentoo | -1 | -1 |
e escrever
\[ \hat Y=\beta_0+\beta_1C_1+\beta_2C_2. \]
As duas colunas dão ao modelo os dois graus de liberdade de que precisa para reproduzir quaisquer três médias. Os coeficientes são algebricamente declives: cada um multiplica uma coluna de contrastes, exactamente como um declive de regressão multiplica um preditor quantitativo. A diferença é que cada coluna só assume alguns valores fixos, como -1, 0 e 1. Assim, em vez de uma recta contínua ao longo de um eixo quantitativo, obtemos uma previsão por categoria. Graficamente, é como passar de um único nível horizontal (a média de todas as observações no modelo compacto) para níveis distintos, um por grupo. A ANOVA de um factor compara precisamente dois modelos: um com uma média comum e outro em que as médias dos grupos podem diferir. Os \(k-1\) coeficientes de contraste são a forma de o modelo linear representar essa diferença.
Como cada coluna soma zero, o intercepto corresponde à média não ponderada das médias dos níveis. Os coeficientes individuais dependem da base de contrastes escolhida; o conjunto dos dois coeficientes contém toda a informação necessária para representar as diferenças entre as três médias.
NotaPorque Bastam k − 1 Contrastes?
Com \(k\) grupos queremos representar \(k\) médias. O intercepto já fornece uma dimensão: desloca todas as previsões em conjunto. Restam \(k-1\) dimensões para representar como os grupos se afastam uns dos outros.
Para três grupos, por exemplo, se conhecermos a média geral e duas diferenças independentes, conseguimos reconstruir as três médias. Uma terceira diferença entre pares seria redundante. Geometricamente, os contrastes escolhem uma base para esse espaço de \(k-1\) dimensões.
Há muitas bases possíveis: tratamento, soma-zero, Helmert, polinomiais ou contrastes planeados. Mudam os coeficientes que lemos directamente; se tiverem posto completo, representam o mesmo conjunto de médias.
No R podemos tornar essa escolha explícita:
Código
          [,1] [,2]
Adelie       1    0
Chinstrap    0    1
Gentoo      -1   -1
A comparação também pode ser vista directamente. O modelo compacto prevê a mesma média para todas as espécies; o aumentado prevê uma média por espécie. Os pontos são médias previstas, não posições numa recta contínua. Os segmentos verticais mostram quanto cada previsão mudou ao passarmos do modelo compacto para o aumentado.
A linha pontilhada representa a média de todas as observações, que pondera os grupos pelos seus tamanhos. Já o intercepto soma-zero do modelo aumentado é a média não ponderada das médias dos grupos. Com tamanhos diferentes, esse intercepto pode não coincidir com a linha. Por isso, os segmentos não representam os coeficientes individuais de contr.sum.
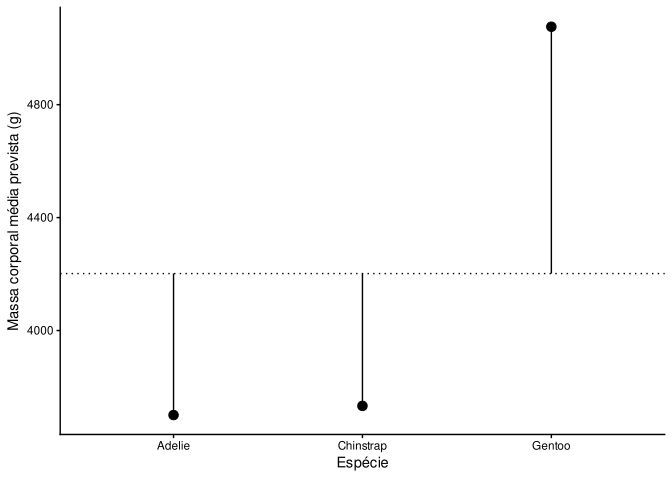
Depois ajustamos exactamente o modelo que já conhecemos:
Ler a Tabela ANOVA
Neste exemplo há um único termo explicativo, species. O factor entra com dois coeficientes de contraste, mas a sua linha na tabela testa-os em conjunto: libertámos dois parâmetros ao passar de uma média comum para três médias. Para esta pergunta, os Tipos I, II e III dão o mesmo teste do factor.
Aqui \(df_1=k-1=2\): tal como no omnibus da regressão múltipla, não se trata do quadrado de um único t. Agora os dois parâmetros pertencem a um só factor, em vez de a dois preditores quantitativos distintos.
O teste omnibus pergunta se as duas colunas de contraste, em conjunto, acrescentam informação. Na prática, estamos a testar se usar uma média diferente para cada grupo melhora a previsão face a usar uma única média para toda a gente. Se os dois contrastes puderem ser tratados como zero, as três médias previstas colapsam para uma só.
Esta é uma pergunta científica por direito próprio. Se species representa um factor substantivamente relevante, podemos querer testar a hipótese geral «a espécie está associada à massa corporal?» antes de a decompor em diferenças particulares entre Adelie, Chinstrap e Gentoo. O F testa directamente esse termo do modelo: pergunta se precisamos do espaço de \(k-1\) parâmetros que representa o factor.
Depois do omnibus podemos fazer uma pergunta diferente: como se organiza essa diferença? Aqui aparece o primeiro «não há almoços grátis». O F permitiu testar a hipótese global numa única comparação de modelos, mas não identifica quais os contrastes responsáveis pelo padrão. Para isso precisamos de examinar as diferenças uma a uma.
Comparações aos Pares
O teste omnibus compara uma média comum com um modelo que permite três médias diferentes. Mas não nos diz quais são diferentes. Com três grupos, podemos comparar cada par de médias.
Retomamos as médias marginais estimadas (estimated marginal means, EMMs) que começámos a usar com dois grupos: são as médias que o modelo prevê para cada nível do factor. Nesta ANOVA de um factor, sem covariáveis, coincidem com as médias observadas de cada grupo. Com mais preditores, permitem calcular previsões especificando como os restantes entram na comparação. Agora pedimos ao pacote emmeans, além das médias, as diferenças entre elas, sempre a partir do mesmo modelo ajustado.
| Comparação | A | B | C | Diferença |
|---|---|---|---|---|
| A − B | +1 | −1 | 0 | \(\bar Y_A-\bar Y_B\) |
| A − C | +1 | 0 | −1 | \(\bar Y_A-\bar Y_C\) |
| B − C | 0 | +1 | −1 | \(\bar Y_B-\bar Y_C\) |
Cada linha define um contraste: multiplicamos as médias previstas pelos pesos e somamos. O zero exclui o grupo que não participa na comparação. Estas três diferenças são fáceis de interpretar, mas apenas duas são independentes: \((A-C)=(A-B)+(B-C)\). Por isso, os dois coeficientes que bastam para ajustar o modelo não limitam as comparações que podemos pedir depois. Também não devemos confundir os coeficientes particulares de contr.sum com estas diferenças aos pares: são duas maneiras de representar ou interrogar as mesmas médias previstas.
No R, obtemos as três médias estimadas e os três pares numa só chamada, sem fazer três análises diferentes:
emmeans(m1, pairwise ~ species, adjust = "tukey")$emmeans
species emmean SE df lower.CL upper.CL
Adelie 3701 37.6 339 3627 3775
Chinstrap 3733 56.1 339 3623 3843
Gentoo 5076 41.7 339 4994 5158
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
Adelie - Chinstrap -32.4 67.5 339 -0.480 0.8807
Adelie - Gentoo -1375.4 56.1 339 -24.495 <0.0001
Chinstrap - Gentoo -1342.9 69.9 339 -19.224 <0.0001
P value adjustment: tukey method for comparing a family of 3 estimates O resultado apresenta primeiro as médias previstas por espécie e depois as diferenças entre pares. O ajustamento de Tukey considera a família destas três comparações. Uma diferença aos pares também pode ser planeada antes de observar os dados; são a pergunta e o momento em que a escolhemos que distinguem a comparação planeada da exploração posterior dos resultados.
Contrastes Planeados
Nem sempre queremos comparar todos os pares. Podemos ter, antes de observar os resultados, uma hipótese mais específica: por exemplo, comparar C com a média de A e B.
| Grupo | C vs média de A e B |
|---|---|
| A | −1/2 |
| B | −1/2 |
| C | +1 |
Esta combinação calcula \(\bar Y_C-(\bar Y_A+\bar Y_B)/2\). É o mesmo mecanismo das comparações aos pares, mas responde a outra pergunta científica. Também podemos planear tendências entre níveis ordenados ou outras combinações estimáveis. Multiplicar todos os pesos por uma constante altera a escala, não a hipótese de diferença igual a zero.
Um contraste planeado traduz uma hipótese escolhida antes de examinar os resultados. Pode ser uma comparação entre dois grupos, como A − B, ou uma combinação de mais grupos, como C menos a média de A e B. O planeamento não dispensa automaticamente de considerar quantos testes pertencem à família inferencial escolhida.
Podemos pedir directamente esse último contraste ao mesmo modelo, respeitando a ordem dos níveis (Adelie, Chinstrap, Gentoo):
 contrast                             estimate   SE  df t.ratio p.value
 Gentoo - media de Adelie e Chinstrap     1359 53.6 339  25.340 <0.0001
Não ajustámos outro modelo. Mudámos apenas a comparação entre as suas médias estimadas.
NotaOpcional: Esquemas de Codificação
Com codificação de tratamento, um nível é a referência e os coeficientes comparam os outros níveis com essa referência. Com contr.sum, o intercepto fica centrado nas médias dos níveis e os coeficientes obedecem a uma restrição de soma zero.
Quando as duas parametrizações descrevem o mesmo espaço de modelos, podem produzir as mesmas previsões ajustadas. O que muda é que comparação aparece directamente em cada coeficiente. Isso torna-se crucial quando há interacções e quando pedimos testes de efeitos de ordem inferior.
No restante percurso do NRB, a nossa escolha de trabalho será a codificação soma-zero, com contr.sum(). Para conhecer outros esquemas, consulte o guia da UCLA, Contrast Coding Systems for Categorical Variables. Encontrará matrizes de codificação, exemplos em R e interpretações dos coeficientes. Inclui tratamento, soma-zero, Helmert, contrastes polinomiais e contrastes definidos pelo investigador.
Comece pela secção Deviation Coding, que corresponde à soma-zero, e compare-a com Dummy Coding. Procure o que representa o intercepto e que diferença entre médias é representada por cada coeficiente. Depois pode explorar os restantes esquemas conforme as perguntas que lhe interessarem.
Comparações Múltiplas e «Post Hoc»
Já distinguimos o teste omnibus, os pares e os contrastes planeados. Falta ver por que o número de comparações importa.
NotaUma Nota Pedante Sobre «Post Hoc»
Comparações múltiplas é o termo geral: fazemos uma família de várias comparações e precisamos de decidir como controlar o erro nessa família.
A expressão post hoc é usada muitas vezes como sinónimo, mas é mais específica. Historicamente, refere-se sobretudo a procedimentos de comparação definidos para uma família de testes, frequentemente depois de um teste omnibus, com uma estatística ou distribuição que já tem em conta essa família de comparações. Tukey é o exemplo clássico. Contrastes planeados, efeitos simples e outras famílias de comparações também podem exigir controlo de multiplicidade sem serem, nesse sentido estrito, testes post hoc.
Porque Muitas Comparações Criam um Problema
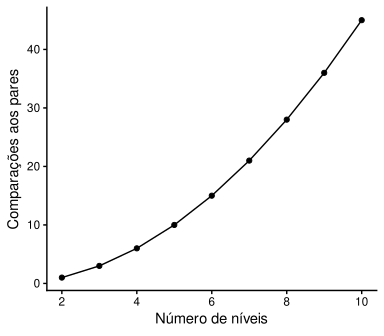
Com \(k\) grupos existem
\[ \frac{k(k-1)}{2} \]
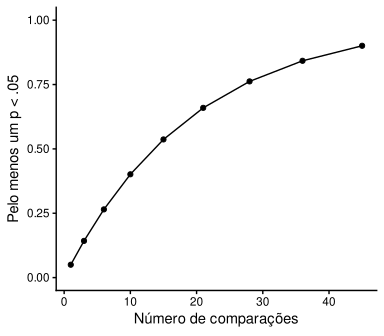
pares possíveis. Quatro grupos já dão 6 pares; seis dão 15; dez dão 45. Se tratássemos \(m\) testes independentes, todos sob as respectivas hipóteses nulas, como testes isolados a \(\alpha=.05\), a probabilidade de aparecer pelo menos um resultado significativo por acaso seria
\[ 1-(1-.05)^m. \]
Os testes reais nem sempre são independentes, portanto esta expressão é uma ilustração e não uma fórmula universal para a taxa de erro de qualquer análise. Mostra, porém, por que repetir testes a 5% não preserva automaticamente um erro de 5% para a família.
Nos modelos factoriais, que veremos depois da ANCOVA aditiva, também podemos comparar os níveis de um factor dentro de cada nível do outro e estudar diferenças de diferenças. Escolhemos as comparações que respondem à pergunta.
ANCOVA Sem Interacção
Já sabemos juntar preditores quantitativos e representar grupos por contrastes. Podemos agora misturá-los no mesmo modelo. Esta combinação recebe frequentemente o nome ANCOVA.
Pergunta de investigação: depois de ter em conta uma variável quantitativa relevante, continuam a existir diferenças entre os grupos?
O nome não exige uma nova matemática: continuamos a ajustar um modelo linear com pelo menos um preditor categórico e um quantitativo.
A versão tradicional mais simples é:
y ~ grupo + xAqui x é a covariável. O modelo permite grupos com interceptos diferentes, mas obriga todos os grupos a partilhar o mesmo declive de x. É a famosa hipótese de declives paralelos. Mais à frente, a interacção entre factor e covariável permitirá libertar essa restrição; por agora, vamos perceber o que o modelo aditivo afirma.
Podemos Misturar Números e Grupos
Uma coluna do modelo pode representar um preditor quantitativo e outra um contraste de um factor. Não há uma fronteira matemática entre «regressão» e «comparação de grupos». Por exemplo:
Código
m <- lm(y ~ idade + ansiedade + grupo, data = dados)
Anova(m, type = "III")
Se grupo tiver dois níveis, a sua linha testa a diferença entre os grupos condicionada aos preditores quantitativos; as linhas de idade e ansiedade testam os respectivos declives condicionados aos outros termos. O nome é secundário. A pergunta continua a ser: que parâmetro ou conjunto de parâmetros libertámos, que termos ficaram no modelo e quanto erro foi reduzido?
Com um factor e uma covariável, a equação aditiva é
\[ \hat Y=\beta_0+\sum_{j=1}^{k-1}\alpha_j C_j+\beta_x x. \]
Comparar y ~ x com y ~ grupo + x testa os \(k-1\) contrastes do grupo, mantendo a covariável. Comparar y ~ grupo com o mesmo modelo completo testa o único declive comum. São as duas linhas parciais da tabela ajustada. As médias de emmeans(m, ~ grupo) são previsões para um valor comum das covariáveis (por defeito, as suas médias), não necessariamente as médias brutas dos grupos. Devemos escolher valores com significado e suporte nos dados.
Aviso«Controlar pela Covariável» Não Resolve Causalidade
Acrescentar x altera a quantidade que estimamos. Pode reduzir variação residual e melhorar precisão; pode também introduzir ou agravar viés em certos cenários causais. Uma ANCOVA não transforma automaticamente dados observacionais numa experiência.
NotaLord: Ajustar a Baseline Pode Mudar a Pergunta
O paradoxo de Lord nasceu de comparações entre grupos que já diferiam antes da medição final. Lord (1967, 1968) mostrou que comparar a mudança bruta e comparar os grupos finais ajustando estatisticamente o valor inicial podem produzir conclusões diferentes. A diferença não é apenas uma escolha de fórmula: os métodos respondem a perguntas diferentes e assentam em pressupostos diferentes sobre os grupos e sobre o papel da medida inicial.
Isto é especialmente importante com grupos preexistentes. Incluir a baseline como covariável não apaga automaticamente as diferenças que já existiam entre os grupos. O delineamento, a forma de constituição dos grupos, a fiabilidade da medida inicial e a pergunta científica determinam que comparação é defensável. Em estudos aleatorizados, o papel do ajuste pode ser muito diferente do que tem em grupos observacionais já distintos à partida.
Paradoxo de Simpson
Há uma armadilha importante escondida na expressão «associação entre duas variáveis»: em que nível estamos a calcular essa associação?
O paradoxo de Simpson aparece quando a relação observada nos dados agregados muda muito — podendo até inverter a direcção — quando separamos os dados por um terceiro factor relevante. O fenómeno tem antecedentes anteriores, mas ficou associado ao exemplo de Simpson (1951) sobre a interpretação de associações em tabelas de contingência. Os resumos agregado e condicionado descrevem relações diferentes.
Os Palmer Penguins dão-nos um exemplo particularmente claro. Se juntarmos as três espécies, o comprimento e a profundidade do bico mostram uma associação negativa. Mas, quando olhamos dentro de cada espécie, a associação é positiva.
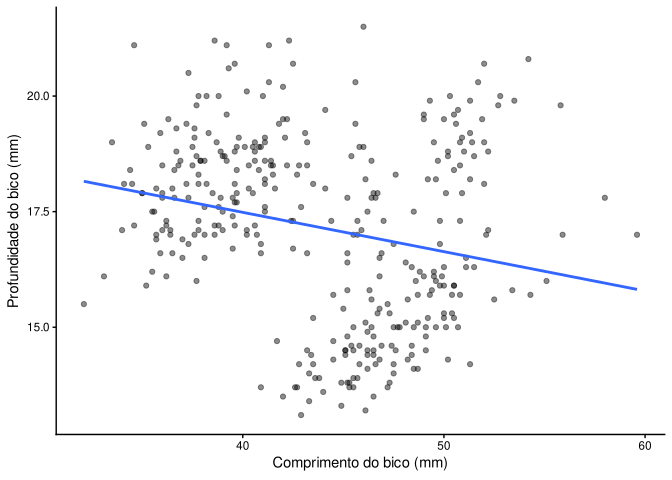
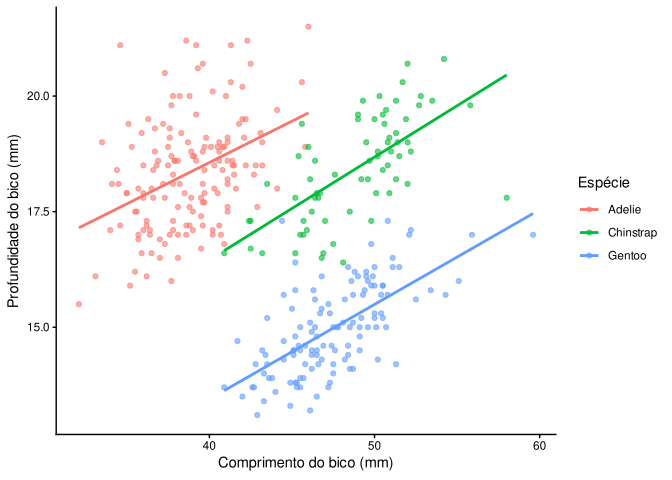
O que aconteceu? As espécies ocupam regiões diferentes do gráfico. Ao misturá-las, a recta global combina duas fontes de informação:
- diferenças entre espécies na forma típica do bico;
- associação dentro de cada espécie entre comprimento e profundidade.
No conjunto, as diferenças entre espécies dominam o declive. Dentro de cada espécie, vemos outra relação. Por isso, «a correlação entre comprimento e profundidade do bico» não é uma descrição suficientemente precisa da pergunta.
Em termos de modelos, podemos comparar:
bill_depth_mm ~ bill_length_mm
bill_depth_mm ~ species + bill_length_mm
O primeiro estima a associação global, ignorando a espécie. O segundo permite níveis médios diferentes entre espécies e estima um declive comum condicionado à espécie: é a ANCOVA aditiva que acabámos de descrever. As rectas separadas do gráfico não impõem um declive comum; mostram as associações dentro de cada espécie. Para representar essa liberdade num só modelo, precisaremos da ANCOVA com interacção.
AvisoO Nível da Pergunta Faz Parte do Modelo
O paradoxo de Simpson não significa que devemos «controlar por tudo». Significa que agregar ou separar grupos muda a quantidade que estamos a estimar.
Antes de interpretar um declive ou uma correlação, precisamos de perguntar:
- Que unidade representa cada linha?
- Há grupos que ocupam regiões diferentes dos dados?
- A pergunta é sobre diferenças entre grupos, relações dentro dos grupos, ou ambas?
- O modelo representa explicitamente esse nível da pergunta?
Neste exemplo, cada linha continua a ser um pinguim diferente. species é um factor entre unidades, não uma medida repetida. A ligação às medidas repetidas está na ideia mais geral: a estrutura dos dados e o nível de análise fazem parte do modelo.
NotaSimpson e a Pergunta Causal
Uma inversão de Simpson não nos diz, por si só, se devemos apresentar a associação agregada ou a associação condicionada. Essa escolha depende da pergunta e do papel da terceira variável no processo que gerou os dados. Simpson (1951) mostrou o problema de interpretação; trabalhos posteriores tornaram explícito que a decisão de agregar ou condicionar exige informação substantiva e, quando a pergunta é causal, uma teoria sobre a estrutura causal.
A escolha dos Palmer Penguins para mostrar esta inversão foi inspirada pela visualização de Tolios (2026). Os gráficos acima destacam primeiro a associação agregada e depois as associações dentro de cada espécie.
3 Interacções e ANCOVA
Dois Factores e a Interacção
Pergunta de investigação: a diferença associada a um factor mantém-se igual em todos os níveis do outro, ou muda consoante o contexto?
Suponhamos dois factores, A e B, ambos com dois níveis. Usando -1/+1, cada célula recebe também o produto dos dois contrastes:
| A | B | A:B |
|---|---|---|
| -1 | -1 | +1 |
| +1 | -1 | -1 |
| -1 | +1 | -1 |
| +1 | +1 | +1 |
O modelo completo é
\[ \hat Y=\beta_0+\beta_AA+\beta_BB+\beta_{AB}AB. \]
Esta tabela parece uma pequena convenção de codificação, mas contém a ideia da ANOVA factorial inteira.
- \(2\beta_A\) é a diferença média entre os níveis de A, agregando os níveis de B;
- \(2\beta_B\) é a diferença média entre os níveis de B, agregando os níveis de A;
- \(4\beta_{AB}\) é a diferença de diferenças.
A escala dos coeficientes vem da escolha -1/+1. Se usássemos outra codificação, os números dos \(\beta\) podiam mudar; as médias previstas por célula e a comparação substantiva não precisavam de mudar.
Mantemos a convenção de tabelas Tipo III para avaliar cada termo neste modelo completo. Com os contrastes centrados, as linhas de A e B correspondem às diferenças médias que acabámos de identificar. Agora que a interacção está explícita, podemos explicar na nota seguinte a diferença em relação ao Tipo II.
NotaTipo II e Tipo III Com Interacções
No modelo y ~ A * B, a tabela Tipo III com a codificação -1/+1 testa:
- para A, \(\beta_A=0\): a diferença de A em média sobre os níveis de B;
- para B, \(\beta_B=0\): a diferença de B em média sobre os níveis de A;
- para A:B, \(\beta_{AB}=0\): a diferença de diferenças.
Ao testar A, os coeficientes de B e de A:B continuam a ser estimados livremente. Para essa pergunta funcionam como nuisance parameters: representam partes do modelo que precisamos de estimar, embora o alvo do teste seja A. Tipo III é a nossa convenção para testar cada componente no modelo científico completo.
O Tipo II segue o princípio da marginalidade: testa um termo depois dos outros, excepto dos termos de ordem superior que o contêm. Aqui, o teste de A é ajustado por B, mas não por A:B. A distinção altera a hipótese sobre os efeitos principais. Para a interacção A:B, que não está contida num termo de ordem superior, os Tipos II e III coincidem.
Em car::Anova() para estes modelos lineares, ambos os tipos usam a variância residual do modelo ajustado. A diferença está na hipótese testada para cada termo. A documentação de car::Anova() explicita estas definições e os cuidados com a codificação dos factores.
Os contrastes soma-zero dão aos testes de ordem inferior a interpretação marginal que queremos, com peso igual para os níveis do outro factor. Com preditores quantitativos e interacções, esses testes referem-se aos valores zero dos outros preditores envolvidos: voltaremos a isso ao centrar os preditores.
NotaEquilíbrio e Ortogonalidade
Num 2 × 2 equilibrado, as colunas -1/+1 para A e B e a coluna produto A:B são ortogonais entre si e ao intercepto. As quatro médias das células ficam decompostas em quatro peças: média geral, contraste de A, contraste de B e contraste A × B.
Num delineamento factorial completo apenas com factores, com o mesmo número de observações por célula, mínimos quadrados usuais e contrastes centrados, a ortogonalidade entre os espaços dos termos faz coincidir os respectivos testes dos Tipos I, II e III. Com covariáveis ou outra estrutura de ponderação, precisamos de verificar a geometria do modelo.
Com factores de mais de dois níveis, contr.sum() mantém os contrastes centrados, mas as suas colunas não são necessariamente ortogonais entre si. Para decompor os vários graus de liberdade de um factor em comparações individuais, podemos escolher contrastes planeados ortogonais que correspondam às hipóteses científicas. Os seus produtos dão as decomposições das interacções.
Tipo III também pode ser usado com células desequilibradas, desde que as hipóteses sejam estimáveis. Com contrastes soma-zero, a comparação marginal continua a dar peso igual aos níveis dos factores; as estimativas, somas de quadrados, erros-padrão e testes dependem dos dados e dos tamanhos das células. Células vazias ou coeficientes redundantes exigem cuidados adicionais com a estimabilidade.
NotaUma Convenção Familiar em Psicologia
O SPSS usa Tipo III por defeito no GLM e o PROC GLM do SAS também apresenta testes Tipo III por defeito, como se pode confirmar nas documentações do SPSS e do SAS. Isto ajuda a perceber a familiaridade desta convenção em muitos cursos de psicologia. No NRB mantemo-la pela ligação à abordagem de comparação de modelos que estamos a desenvolver.
A Tabela Como Comparações de Modelos
Num delineamento factorial cruzamos os níveis dos factores: cada combinação A × B define uma célula. Para a ANOVA entre unidades aqui usada, cada linha representa uma unidade diferente; ter o mesmo nível de A ou de B não torna duas linhas medidas repetidas. A independência continua a depender da amostragem e da atribuição das condições, não apenas dos nomes dos factores.
A tabela Tipo III testa restrições no mesmo modelo completo:
| Linha | Restrição no modelo compacto | Parâmetros que continuam livres |
|---|---|---|
| A | \(\beta_A=0\) | intercepto, B e A:B |
| B | \(\beta_B=0\) | intercepto, A e A:B |
| A:B | \(\beta_{AB}=0\) | intercepto, A e B |
Num 2 × 2 cada linha liberta um parâmetro e tem \(F=t^2\) para o coeficiente correspondente. O teste omnibus de todos os termos, face a uma única média, liberta três parâmetros e responde a outra pergunta.
Vamos aplicar esta leitura a dois factores dos pinguins, apenas com Adelie e Gentoo para manter o 2 × 2. É uma ilustração observacional da parametrização, não uma experiência que permita atribuir causalmente diferenças à espécie ou ao sexo:
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5062052953 | 1 | 54396.658545 | 0.0000000 |
| A | 35877305 | 1 | 385.536369 | 0.0000000 |
| B | 124112967 | 1 | 1333.713956 | 0.0000000 |
| A:B | 278769 | 1 | 2.995642 | 0.0846707 |
| Residuals | 24288180 | 261 | NA | NA |
NotaReconstruir Uma Linha Tipo III
Para testar A mantendo A:B, restringimos a coluna de A na matriz original, sem recodificar a interacção. Neste 2 × 2, a matriz tem as colunas intercepto, A1, B1 e A1:B1:
X <- model.matrix(m_factor)
colnames(X)
[1] "(Intercept)" "A1" "B1" "A1:B1" | Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 262 | 60165485 | NA | NA | NA | NA |
| 261 | 24288180 | 1 | 35877305 | 385.5364 | 0 |
O F coincide com a linha A de Anova(m_factor, type = "III"). Não basta escrever y ~ B + A:B: o R pode construir outras colunas para representar a interacção e deixar de impor a restrição pretendida. O Tipo III restringe os coeficientes do termo na parametrização do modelo completo.
Sem Interacção = Restrição
O modelo
y ~ A + Bnão significa apenas «ainda não testámos a interacção». Ele afirma que a diferença entre A=-1 e A=+1 é a mesma nos dois níveis de B. As duas partes somam-se de forma aditiva.
O modelo
y ~ A * Bexpande para
y ~ A + B + A:Be liberta essa restrição.
Por isso, quando a teoria permite ou prevê uma interacção, o modelo com interacção é o modelo que representa a teoria. Podemos comparar o modelo aditivo com ele para testar a interacção:
Mas não tratamos a interacção como uma decoração que só entra depois de termos garantido efeitos principais. Se a pergunta importante é uma diferença de diferenças, o delineamento e o tamanho da amostra também devem ser pensados para essa diferença de diferenças.
Interacção Entre Dois Factores
Há uma interacção quando a diferença associada a A depende do nível de B.
Num 2 × 2, podemos escrevê-la directamente:
\[ (\bar Y_{A_2B_2}-\bar Y_{A_1B_2})- (\bar Y_{A_2B_1}-\bar Y_{A_1B_1}). \]
Se este valor for zero, a diferença de A é a mesma nos dois níveis de B. Se não for, mudou.
É aqui que a tabela por células volta a ser mais útil do que a linguagem abstracta de «efeitos». Antes de interpretar um valor-p, vale a pena escrever ou desenhar as quatro médias e perguntar: que diferença mudou, em que direcção e quanto?
Há ainda uma cautela histórica importante nos delineamentos 2 × 2. Garcia-Marques et al. (2014), desenvolvendo argumentos de Loftus (1978) e articulando-os com Rosnow e Rosenthal (1989), mostram que a interpretação não depende apenas de saber se o termo de interacção é diferente de zero. Certos padrões podem desaparecer sob uma transformação monotónica da escala, e o padrão completo das quatro células importa para perceber o que a interacção permite afirmar.
O resultado mais forte de Garcia-Marques et al. (2014) é específico do 2 × 2. Com factores de mais de dois níveis há mais estrutura para confrontar e aquele resultado não se transfere literalmente. A cautela geral, porém, continua útil: precisamos de interpretar o padrão das médias e os contrastes substantivos, não apenas a linha «interacção» de uma tabela ANOVA.
AvisoUm Efeito Principal É um Resumo
Com -1/+1, \(\beta_A\) resume A agregando os níveis de B. Isso pode ser uma pergunta substantiva perfeitamente legítima. Mas, quando a interacção é grande, esse resumo pode esconder duas diferenças muito distintas.
Por isso, uma tabela ANOVA não termina a interpretação de uma interacção. Precisamos normalmente das médias por célula, efeitos simples ou contrastes que digam exactamente onde está a diferença de diferenças.
Médias Previstas pelo Modelo
Já temos o modelo factorial:
\[ \hat Y=\beta_0+\beta_AA+\beta_BB+\beta_{AB}AB. \]
A partir daqui não precisamos de uma regra nova para obter médias. Fazemos o mesmo que numa regressão: escolhemos os valores dos preditores, substituímo-los na equação e calculamos a previsão.
A Média Geral
Com contrastes -1/+1, o ponto central dos dois factores é zero. Se colocarmos \(A=0\) e \(B=0\), o termo de interacção também vale zero:
\[ \hat Y(0,0)=\beta_0. \]
O intercepto é, portanto, a previsão no centro do delineamento. Num 2 × 2 equilibrado com esta codificação, corresponde à média geral das quatro células.
O Efeito Principal de A
Para obter as previsões marginais de A, deixamos B no seu valor central, \(B=0\), e resolvemos o modelo para os dois valores de A.
Para \(A=-1\):
\[ \hat Y(-1,0)=\beta_0-\beta_A. \]
Para \(A=+1\):
\[ \hat Y(+1,0)=\beta_0+\beta_A. \]
A diferença entre estas duas previsões é \(2\beta_A\). É precisamente a comparação marginal de A: perguntamos pela diferença associada a A mantendo B no centro do seu contraste.
O Efeito Principal de B
Agora fazemos o simétrico. Colocamos \(A=0\) e variamos B:
\[ \hat Y(0,-1)=\beta_0-\beta_B, \qquad \hat Y(0,+1)=\beta_0+\beta_B. \]
A diferença é \(2\beta_B\). Reutilizámos a mesma operação: escolher os valores dos preditores e resolver a equação.
As Quatro Células e a Interacção
Para obter as médias previstas por célula, usamos agora os valores que correspondem realmente a cada combinação dos factores. O termo de interacção é o produto \(AB\):
| A | B | AB | Previsão |
|---|---|---|---|
| -1 | -1 | +1 | \(\beta_0-\beta_A-\beta_B+\beta_{AB}\) |
| +1 | -1 | -1 | \(\beta_0+\beta_A-\beta_B-\beta_{AB}\) |
| -1 | +1 | -1 | \(\beta_0-\beta_A+\beta_B-\beta_{AB}\) |
| +1 | +1 | +1 | \(\beta_0+\beta_A+\beta_B+\beta_{AB}\) |
Agora podemos ver a interacção directamente no modelo. A diferença de A quando \(B=-1\) é
\[ \hat Y(+1,-1)-\hat Y(-1,-1) =2\beta_A-2\beta_{AB}. \]
Quando \(B=+1\), é
\[ \hat Y(+1,+1)-\hat Y(-1,+1) =2\beta_A+2\beta_{AB}. \]
A diferença entre estas duas diferenças é \(4\beta_{AB}\). Portanto, o coeficiente da interacção é literalmente a peça do modelo que permite que a diferença de A mude quando mudamos B.
Este é o ponto importante: médias gerais, médias marginais, médias por célula e efeitos simples podem ser lidos como previsões do mesmo modelo em pontos diferentes da sua matriz de contrastes. Não estamos a mudar de análise.
São as mesmas médias marginais estimadas (EMMs) que começámos a usar nos dois grupos e retomámos na ANOVA de um factor. Antes pedíamos uma previsão por grupo. Agora precisamos de indicar em que nível do outro factor queremos comparar as previsões. O pacote emmeans faz as contas a partir do mesmo modelo, inclusive em situações com covariáveis ou células desequilibradas. O código aplicado encontra-se no tutorial de modelos lineares.
Como vimos nas comparações da ANOVA de um factor, também aqui precisamos de escolher uma família de comparações e considerar a multiplicidade. Num delineamento factorial podemos comparar os níveis de A dentro de B, os de B dentro de A ou diferenças de diferenças. Não é necessário testar todos os pares possíveis entre células.
Efeitos Simples
Na ANOVA de um factor, começámos por comparar médias duas a duas: A − B, A − C e B − C. Numa ANOVA factorial fazemos exactamente o mesmo, mas especificamos em que nível do outro factor queremos comparar as médias.
Se A tivesse três níveis e B dois, por exemplo, poderíamos calcular A1 − A2, A1 − A3 e A2 − A3 em B1, e repetir os mesmos três pares em B2. É a operação da ANOVA de um factor acrescentando «em que nível de B?».
Num delineamento 2 × 2 temos quatro médias previstas:
| B1 | B2 | |
|---|---|---|
| A1 | \(\hat\mu_{11}\) | \(\hat\mu_{12}\) |
| A2 | \(\hat\mu_{21}\) | \(\hat\mu_{22}\) |
Podemos pedir quatro comparações simples:
| Pergunta | Contraste |
|---|---|
| A1 − A2 em B1 | \(\hat\mu_{11}-\hat\mu_{21}\) |
| A1 − A2 em B2 | \(\hat\mu_{12}-\hat\mu_{22}\) |
| B1 − B2 em A1 | \(\hat\mu_{11}-\hat\mu_{12}\) |
| B1 − B2 em A2 | \(\hat\mu_{21}-\hat\mu_{22}\) |
São efeitos simples: cada comparação usa apenas duas das quatro médias, mantendo o outro factor num nível fixo. Tal como antes, podemos pensá-las como contrastes cujos pesos são +1 e -1 para as duas células comparadas e zero para as restantes.
A interacção pergunta se uma dessas diferenças muda quando passamos de um nível do outro factor para o seguinte. Por exemplo:
\[ (\hat\mu_{11}-\hat\mu_{21}) - (\hat\mu_{12}-\hat\mu_{22}). \]
Isto é uma diferença de diferenças, ou um contraste de contrastes. Se a expressão for zero, as duas diferenças de A são iguais; se não for, a diferença associada a A depende de B. Podemos chegar à mesma pergunta pela outra direcção, comparando os dois efeitos simples de B (com o sinal adequado à ordem das subtracções). Num 2 × 2, estas são formas alternativas de ler a mesma interacção, não quatro interacções distintas.
Os efeitos simples ajudam-nos a descrever onde está o padrão: uma diferença pode ser grande em B1 e pequena em B2, mudar de sinal, ou surgir apenas num dos níveis. Contudo, o teste da interacção avalia a diferença entre os efeitos simples; não equivale a verificar se um deles é significativo e o outro não. A comparação de valores-p separados não testa essa diferença de diferenças.
No R, reutilizamos a chamada pairwise da ANOVA de um factor. Acrescentamos apenas a condição indicada após |:
emmeans(m_factor, ~ A * B) A B emmean SE df lower.CL upper.CL
female Adelie 3369 35.7 261 3299 3439
male Adelie 4043 35.7 261 3973 4114
female Gentoo 4680 40.1 261 4601 4759
male Gentoo 5485 39.1 261 5408 5562
Confidence level used: 0.95 emmeans(m_factor, pairwise ~ A | B)$emmeans
B = Adelie:
A emmean SE df lower.CL upper.CL
female 3369 35.7 261 3299 3439
male 4043 35.7 261 3973 4114
B = Gentoo:
A emmean SE df lower.CL upper.CL
female 4680 40.1 261 4601 4759
male 5485 39.1 261 5408 5562
Confidence level used: 0.95
$contrasts
B = Adelie:
contrast estimate SE df t.ratio p.value
female - male -675 50.5 261 -13.361 <0.0001
B = Gentoo:
contrast estimate SE df t.ratio p.value
female - male -805 55.9 261 -14.390 <0.0001emmeans(m_factor, pairwise ~ B | A)$emmeans
A = female:
B emmean SE df lower.CL upper.CL
Adelie 3369 35.7 261 3299 3439
Gentoo 4680 40.1 261 4601 4759
A = male:
B emmean SE df lower.CL upper.CL
Adelie 4043 35.7 261 3973 4114
Gentoo 5485 39.1 261 5408 5562
Confidence level used: 0.95
$contrasts
A = female:
contrast estimate SE df t.ratio p.value
Adelie - Gentoo -1311 53.7 261 -24.431 <0.0001
A = male:
contrast estimate SE df t.ratio p.value
Adelie - Gentoo -1441 52.9 261 -27.237 <0.0001Aqui, m_factor é o modelo com A * B ajustado acima. ~ A | B pede as médias e as diferenças de A em cada nível de B. ~ B | A faz o inverso. Não ajustamos um modelo novo para cada par.
Por defeito, quando usamos |, os ajustamentos em emmeans são geralmente feitos dentro de cada grupo definido após a barra. Se as comparações de vários grupos ou orientações forem tratadas como uma só família inferencial, será preciso definir e justificar o ajustamento comum.
Os gráficos seguintes permitem olhar para as mesmas quatro médias nas duas orientações: uma vista facilita a leitura de A dentro de B; a outra, de B dentro de A. O modelo e a interacção são os mesmos.
Padrões de um 2 × 2
Num 2 × 2 há três termos na tabela ANOVA: A, B e A:B. Podemos combinar a presença ou ausência desses termos de várias formas. Os exemplos abaixo são ilustrações de padrões populacionais, não classificações obtidas a partir de testes significativos ou não significativos: cada conjunto de quatro médias é desenhado duas vezes. À esquerda, A fica no eixo horizontal e B forma as linhas; à direita trocamos os papéis.
Os dados são os mesmos. O modelo é o mesmo. O que muda é a direcção em que o gráfico nos convida a ler os efeitos simples.
As médias são hipotéticas e usamos a mesma escala vertical nos seis pares. Os padrões sem efeitos e com A e B aditivos, mas sem interacção, também são possíveis; estes seis pares não pretendem esgotar as combinações. Em cada par, compare primeiro as diferenças entre os níveis do factor no eixo horizontal. Depois olhe para as linhas: os seus declives mostram se essa diferença se mantém ou muda com o outro factor.
Efeito de A
As médias de A são 4 e 8; as duas médias marginais de B são 6. À esquerda, as linhas de B coincidem. À direita, a diferença entre os níveis de A aparece como duas linhas horizontais separadas.
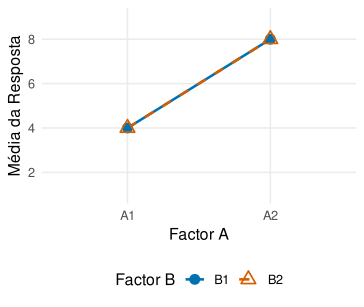
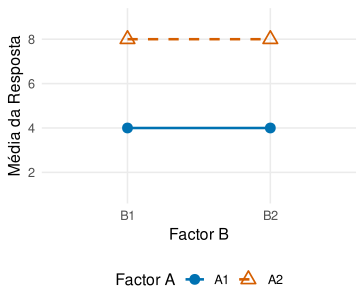
Efeito de B
Agora a diferença média é entre os níveis de B. As médias marginais de A são ambas 6. Com A no eixo, vemos duas linhas horizontais; com B no eixo, as duas linhas de A coincidem e sobem de 4 para 8.
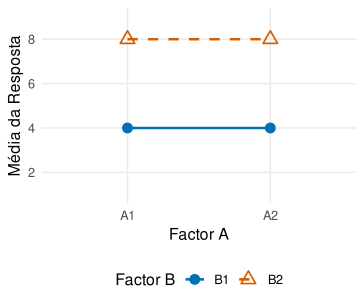
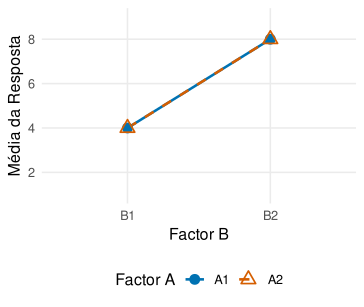
Apenas Interacção
Todas as médias marginais são 6. Os efeitos simples têm direcções opostas e anulam-se quando fazemos a média sobre o outro factor. As linhas cruzam-se nas duas orientações.
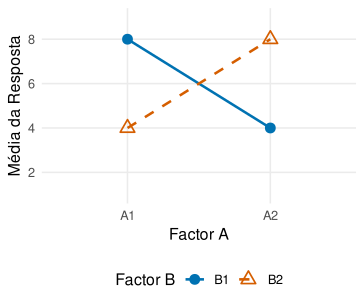
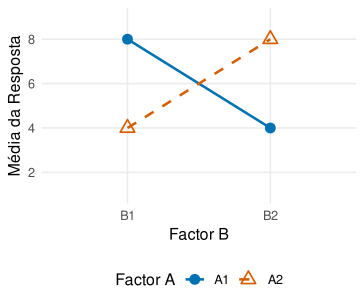
A e Interacção
As médias marginais de A são 3.5 e 6.5; as de B são ambas 5. A diferença entre os níveis de A é 6 em B1 e zero em B2. Na vista com B no eixo, as linhas de A têm declives opostos e encontram-se em B2.
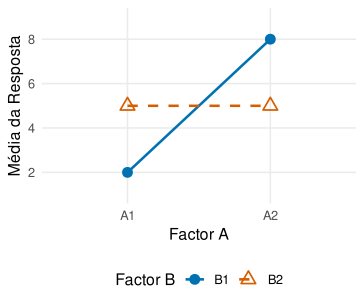
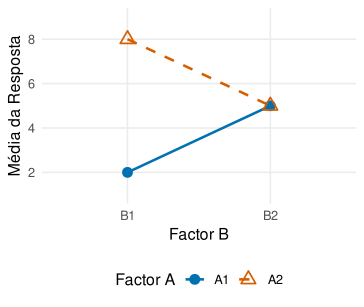
B e Interacção
As médias marginais de A são ambas 5; as de B são 3.5 e 6.5. A diferença entre os níveis de B é 6 em A1 e zero em A2. Compare este par com o anterior: os factores trocaram de papel.
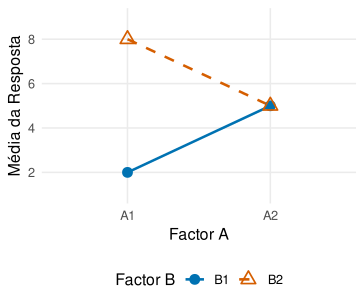
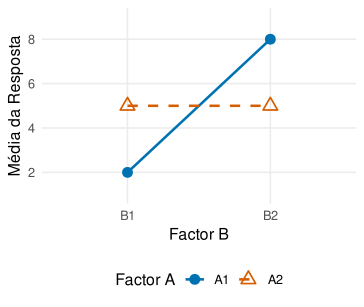
A, B e Interacção
Ambos os factores têm diferenças marginais: A passa de 5 para 2 e B de 2 para 5. A diferença entre os níveis de A é zero em B1 e -6 em B2, pelo que também há interacção.
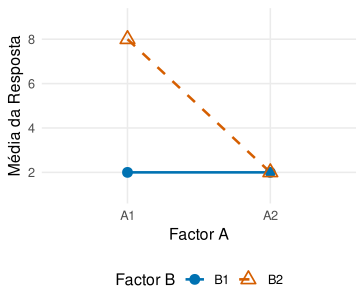
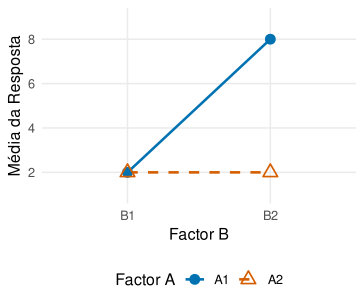
A troca de eixos é particularmente útil quando há interacção. Numa orientação vemos imediatamente A dentro de cada nível de B; na outra vemos B dentro de cada nível de A. Nenhuma orientação é «a correcta». Escolhemos a que torna mais fácil explicar a pergunta substantiva e, muitas vezes, vale a pena olhar para as duas antes de decidir como reportar o padrão.
Os seis desenhos representam combinações simples dos três termos da tabela, não seis formas únicas que os dados podem assumir. Dentro de cada combinação existem infinitos padrões de magnitudes e direcções.
DicaDa Interacção à Pergunta
Quando uma interacção é substantivamente importante, escreva primeiro a diferença de diferenças. Depois escolha os efeitos simples ou contrastes que explicam essa diferença. As EMMs dão uma forma conveniente de obter as médias previstas pelo modelo; o controlo de comparações múltiplas acompanha a família de perguntas que realmente pretende responder.
Factores Com Mais Níveis
A mesma construção estende-se a um factorial \(a\times b\). O primeiro factor precisa de \(a-1\) contrastes, o segundo de \(b-1\), e a interacção contém os \((a-1)(b-1)\) produtos entre essas colunas. O modelo completo representa as \(ab\) médias das células, incluindo o intercepto.
Comparar y ~ A + B com y ~ A * B testa conjuntamente esses \((a-1)(b-1)\) parâmetros de interacção. Numa tabela Tipo III, cada efeito principal é testado restringindo o seu bloco de colunas e mantendo a interacção. Com mais de um grau de liberdade, a linha do termo já não é o quadrado do t de um único coeficiente. As EMMs e os efeitos simples permitem decompor a pergunta: quais as diferenças de A dentro de cada B, e quais dessas diferenças mudam entre níveis de B?
ANCOVA Com Interacção: Factor × Variável Quantitativa
Na ANCOVA sem interacção impusemos um declive quantitativo comum aos grupos. Mas isso também é uma restrição. E se o declive mudar entre grupos? Comecemos por um factor com dois níveis, para que a mudança caiba num único parâmetro.
Consideremos:
y ~ grupo * xIsto expande para
y ~ grupo + x + grupo:xA interacção pergunta se o declive de x é igual entre grupos.
Mantemos a codificação soma-zero: \(C=-1\) num grupo e \(C=+1\) no outro. A equação completa é
\[ \hat Y=\beta_0+\beta_C C+\beta_x x+\beta_{Cx}Cx. \]
Assim,
\[ \hat Y_{C=-1}=(\beta_0-\beta_C)+(\beta_x-\beta_{Cx})x, \qquad \hat Y_{C=+1}=(\beta_0+\beta_C)+(\beta_x+\beta_{Cx})x. \]
O declive médio dos dois grupos é \(\beta_x\) e a diferença entre declives é \(2\beta_{Cx}\). A diferença entre os grupos, por sua vez, é
\[ \hat Y_{C=+1}(x)-\hat Y_{C=-1}(x)=2\beta_C+2\beta_{Cx}x. \]
A linha do factor num teste Tipo III refere-se a \(x=0\). Não resume uma diferença constante entre grupos quando a interacção está presente. Por isso preparamos uma referência quantitativa interpretável antes de ajustar:
ds_binary <- drop_na(palmerpenguins::penguins, body_mass_g, sex, flipper_length_mm)
ds_binary <- mutate(ds_binary, flipper_200 = flipper_length_mm - 200)

m_binary_add <- lm(body_mass_g ~ sex + flipper_200, data = ds_binary)
m_binary_int <- lm(body_mass_g ~ sex * flipper_200, data = ds_binary)
anova(m_binary_add, m_binary_int)| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 330 | 41795374 | NA | NA | NA | NA |
| 329 | 41794088 | 1 | 1286.001 | 0.0101233 | 0.9199177 |
Anova(m_binary_int, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5.384793e+09 | 1 | 4.238870e+04 | 0.0000000 |
| sex | 9.415818e+06 | 1 | 7.412063e+01 | 0.0000000 |
| flipper_200 | 1.312989e+08 | 1 | 1.033576e+03 | 0.0000000 |
| sex:flipper_200 | 1.286001e+03 | 1 | 1.012330e-02 | 0.9199177 |
| Residuals | 4.179409e+07 | 329 | NA | NA |
A comparação aditivo/com interacção testa \(\beta_{Cx}=0\), com \(df_1=1\): é o mesmo F da linha sex:flipper_200 e o quadrado do t desse coeficiente. Já a linha sex compara as previsões aos 200 mm, não os declives. Com a ordem de contr.sum() neste exemplo, +1 é female e -1 é male.
Para interpretar, pedimos os declives estimados com emtrends() e médias previstas em comprimentos escolhidos. Os 190, 200 e 210 mm servem de pontos de leitura; devemos confirmar o suporte observado em cada grupo antes de lhes dar uma interpretação substantiva:
emtrends(m_binary_int, pairwise ~ sex, var = "flipper_200")$emtrends
sex flipper_200.trend SE df lower.CL upper.CL
female 47.2 2.23 329 42.8 51.5
male 46.9 1.90 329 43.1 50.6
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
female - male 0.294 2.92 329 0.101 0.9199$emmeans
flipper_200 = -10:
sex emmean SE df lower.CL upper.CL
female 3515 32.2 329 3452 3578
male 3866 38.9 329 3789 3942
flipper_200 = 0:
sex emmean SE df lower.CL upper.CL
female 3987 28.4 329 3931 4042
male 4335 28.8 329 4278 4391
flipper_200 = 10:
sex emmean SE df lower.CL upper.CL
female 4458 39.5 329 4380 4536
male 4803 29.4 329 4745 4861
Confidence level used: 0.95
$contrasts
flipper_200 = -10:
contrast estimate SE df t.ratio p.value
female - male -351 50.5 329 -6.947 <0.0001
flipper_200 = 0:
contrast estimate SE df t.ratio p.value
female - male -348 40.4 329 -8.609 <0.0001
flipper_200 = 10:
contrast estimate SE df t.ratio p.value
female - male -345 49.3 329 -7.005 <0.0001
NotaReconhecer a Parametrização 0/1
Com codificação de tratamento, 0/1, podemos ler directamente a diferença entre declives. Podemos escrever:
\[ \hat Y_{grupo0}=\beta_0+\beta_1x \]
e
\[ \hat Y_{grupo1}=(\beta_0+\beta_2)+(\beta_1+\beta_3)x. \]
\(\beta_3\) é então a diferença entre declives. Se for zero, as rectas são paralelas. Se não for, a associação entre x e y depende do grupo.
O factor de dois na interpretação soma-zero desaparece nesta codificação; a igualdade dos declives continua a ser exactamente a mesma restrição.
Este é o mesmo conceito que vimos na interacção entre dois factores. Mudou a geometria da variável, não a ideia de «o efeito de um preditor depende do outro».
Mais de Dois Grupos × Variável Quantitativa
Com \(k>2\) grupos já precisamos de \(k-1\) contrastes para representar os seus níveis médios. Para permitir um declive próprio por grupo, acrescentamos outros \(k-1\) parâmetros, os produtos de cada contraste por \(x\):
\[ \hat Y=\beta_0+\sum_{j=1}^{k-1}\alpha_j C_j +\beta_x x+\sum_{j=1}^{k-1}\gamma_j C_jx. \]
Com as três espécies e contr.sum(3), os declives são
\[ s_{\mathrm{Adelie}}=\beta_x+\gamma_1,\qquad s_{\mathrm{Chinstrap}}=\beta_x+\gamma_2,\qquad s_{\mathrm{Gentoo}}=\beta_x-\gamma_1-\gamma_2. \]
O modelo aditivo obriga os três declives a serem iguais. O teste da interacção liberta os dois \(\gamma\)s em conjunto: tem \(df_1=k-1=2\) e não corresponde a um único \(t^2\). Os testes t de cada coeficiente continuam a testar uma só restrição, não o factor inteiro.
ds_species <- drop_na(palmerpenguins::penguins,
                      body_mass_g, species, flipper_length_mm)
ds_species <- mutate(ds_species, flipper_200 = flipper_length_mm - 200)

m_species_add <- lm(body_mass_g ~ species + flipper_200, data = ds_species)
m_species_int <- lm(body_mass_g ~ species * flipper_200, data = ds_species)
anova(m_species_add, m_species_int)| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 338 | 47666988 | NA | NA | NA | NA |
| 336 | 46147424 | 2 | 1519564 | 5.531985 | 0.0043271 |
Anova(m_species_int, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 1344834810 | 1 | 9791.759963 | 0.0000000 |
| species | 1017981 | 2 | 3.705967 | 0.0255867 |
| flipper_200 | 23113816 | 1 | 168.291999 | 0.0000000 |
| species:flipper_200 | 1519564 | 2 | 5.531985 | 0.0043271 |
| Residuals | 46147424 | 336 | NA | NA |
emtrends(m_species_int, pairwise ~ species, var = "flipper_200",
         adjust = "tukey")
$emtrends
species flipper_200.trend SE df lower.CL upper.CL
Adelie 32.8 4.63 336 23.7 41.9
Chinstrap 34.6 6.35 336 22.1 47.1
Gentoo 54.6 5.17 336 44.4 64.8
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
Adelie - Chinstrap -1.74 7.86 336 -0.222 0.9733
Adelie - Gentoo -21.79 6.94 336 -3.139 0.0052
Chinstrap - Gentoo -20.05 8.19 336 -2.448 0.0394
P value adjustment: tukey method for comparing a family of 3 estimates A linha species:flipper_200 testa a igualdade conjunta dos declives; os pares de emtrends() dizem quais os declives que estamos a comparar. Não são diferenças de médias. Para comparar massas previstas a um comprimento comum, usamos antes emmeans():
emmeans(m_species_int, pairwise ~ species,
        at = list(flipper_200 = 0), adjust = "tukey")
$emmeans
species emmean SE df lower.CL upper.CL
Adelie 4031 55.4 336 3922 4140
Chinstrap 3877 52.2 336 3775 3980
Gentoo 4137 95.0 336 3950 4324
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
Adelie - Chinstrap 153 76.1 336 2.010 0.1113
Adelie - Gentoo -107 110.0 336 -0.970 0.5961
Chinstrap - Gentoo -260 108.0 336 -2.396 0.0449
P value adjustment: tukey method for comparing a family of 3 estimates Esta última pergunta coincide com a hipótese da linha species Tipo III quanto à igualdade das três previsões aos 200 mm, mas os pares de Tukey decompõem-na em comparações específicas, com ajustamento de multiplicidade. A linha flipper_200 testa o declive médio, com peso igual para as três espécies; não testa se todos os declives são simultaneamente zero. Se mudarmos a referência quantitativa, mudará a pergunta sobre as médias, não a hipótese de igualdade dos declives. A região comum de comprimentos continua a limitar as comparações que podemos interpretar sem extrapolar.
Retomando o exemplo de Simpson, o modelo bill_depth_mm ~ species * bill_length_mm permite um declive diferente em cada espécie, como nas rectas separadas do gráfico. É a extensão do modelo aditivo, não uma consequência necessária da inversão entre a associação global e as associações dentro das espécies.
ANCOVA Factorial Tradicional
Podemos ter dois factores categóricos e permitir a sua interacção, mantendo a covariável apenas como efeito aditivo:
y ~ A * B + xEste modelo permite:
- diferenças entre níveis de A;
- diferenças entre níveis de B;
- uma interacção A × B;
- uma associação linear com
x; -
mas o mesmo declive de
xem todas as células A × B.
Esta é uma forma muito comum de ANCOVA. É importante perceber que «não incluir interacções com a covariável» não é uma propriedade matemática obrigatória da ANCOVA. É uma restrição do modelo.
Quando a Convenção Falha
Se houver razão científica para pensar que a relação entre x e a resposta muda entre grupos, impor um único declive pode esconder precisamente o padrão que nos interessa. Podemos então comparar o modelo anterior com um modelo que liberta essas interacções.
Por exemplo, para uma covariável e dois factores:
y ~ A * B * xinclui A × x, B × x e A × B × x, além dos termos de ordem inferior. Não somos obrigados a incluir toda a estrutura se a pergunta justificar apenas uma parte, mas devemos respeitar a hierarquia dos termos e dizer claramente que modelo estamos a testar.
Dois Preditores Quantitativos
Já deixámos um factor modificar um declive. Falta apenas retirar a última fronteira artificial: o segundo preditor também pode ser quantitativo. A pergunta continua a ser se o efeito de um preditor depende do outro.
Finalmente:
\[ Y=\beta_0+\beta_1X+\beta_2Z+\beta_3XZ+e. \]
ou, em R:
y ~ x * zO declive de x é
\[ \frac{\partial \hat Y}{\partial X}=\beta_1+\beta_3Z. \]
Portanto, quando existe uma interacção, não há um único declive de X. O declive depende do valor de Z. E, simetricamente, o declive de Z depende de X:
\[ \frac{\partial \hat Y}{\partial Z}=\beta_2+\beta_3X, \qquad \frac{\partial^2 \hat Y}{\partial X\,\partial Z}=\beta_3. \]
\(\beta_3\) indica quanto muda o declive de X por unidade adicional de Z. Comparar y ~ x + z com y ~ x * z testa \(H_0:\beta_3=0\), libertando um único parâmetro. Aqui voltamos a ter \(F=t^2\) para a interacção, embora o omnibus do modelo completo liberte três parâmetros. Os testes Tipo III de X e Z avaliam os respectivos declives quando o outro preditor vale zero, não a ausência de qualquer associação ao longo de toda a superfície.
É por isso que interacções quantitativas costumam ser apresentadas através de declives simples em valores substantivamente úteis do moderador. Média, média ± 1 DP e quantis são convenções possíveis, não leis. Se um desses valores ficar fora da região onde há dados, a interpretação passa a depender de extrapolação.
Podemos voltar à água, agora perguntando se a associação entre temperatura e oxigénio varia com a turbidez. É uma demonstração de associação, não uma identificação de mecanismos causais. Centramos as duas variáveis nas médias da amostra e mantemos as mesmas linhas nos dois modelos:
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 497 | 299.9786 | NA | NA | NA | NA |
| 496 | 299.8124 | 1 | 0.1662167 | 0.2749836 | 0.6002424 |
Anova(m_water_int, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 3.303046e+04 | 1 | 5.464453e+04 | 0.0000000 |
| temp_c | 1.210523e+01 | 1 | 2.002651e+01 | 0.0000095 |
| ntu_c | 1.539618e+01 | 1 | 2.547094e+01 | 0.0000006 |
| temp_c:ntu_c | 1.662167e-01 | 1 | 2.749836e-01 | 0.6002424 |
| Residuals | 2.998124e+02 | 496 | NA | NA |
  ntu_c temp_c.trend     SE  df lower.CL upper.CL
 -0.397        0.200 0.0611 496   0.0805    0.320
  0.000        0.179 0.0399 496   0.1003    0.257
  0.397        0.157 0.0538 496   0.0513    0.263

Confidence level used: 0.95
A última chamada lê o declive da temperatura em três valores de turbidez: média − 1 DP, média e média + 1 DP. Não compara três grupos naturais; são pontos escolhidos numa variável contínua. O teste da interacção é que avalia se o declive muda, sem depender de um desses declives simples atingir ou não um limiar de significância.
NotaCentrar Muda a Interpretação
Se substituirmos \(X\) por \(X-c\), o modelo continua a representar a mesma superfície quando os termos correspondentes são incluídos. O que muda é o ponto onde interpretamos o intercepto e o «efeito principal» de outro preditor. Centrar numa média pode tornar coeficientes mais interpretáveis, mas não é necessário para que uma interacção exista nem a torna estatisticamente válida.
Para ver exactamente o que muda, escrevamos \(X_c=X-c\) e \(Z_c=Z-d\). Substituindo \(X=X_c+c\) e \(Z=Z_c+d\) no modelo completo, obtemos
\[ \hat Y=(\beta_0+c\beta_1+d\beta_2+cd\beta_3) +(\beta_1+d\beta_3)X_c+(\beta_2+c\beta_3)Z_c +\beta_3X_cZ_c. \]
A interacção conserva o seu coeficiente e o seu teste. Os coeficientes de ordem inferior e os seus testes podem mudar porque passámos a perguntar pelos declives noutros pontos. As previsões e os resíduos permanecem iguais: não melhorámos o ajuste por subtrair uma constante.
4 Ligações e Extensões
O Que Une Tudo Isto?
A tabela abaixo é uma tradução entre nomes tradicionais e modelos lineares. Serve para reconhecer a estrutura comum, sem ter de decorar uma lista de testes.
| Nome tradicional | Modelo linear típico | Pergunta central |
|---|---|---|
| teste-t de uma amostra |
y ~ 1 face a uma referência |
precisamos de estimar um intercepto diferente da referência? |
| regressão simples | y ~ x |
precisamos de um declive de x? |
| correlação de Pearson | regressão simples padronizada | existe associação linear? |
| regressão múltipla | y ~ x1 + x2 + ... |
que termos acrescentam informação condicionada aos outros? |
| teste-t de duas amostras | y ~ grupo |
um contraste entre dois níveis reduz o erro? |
| ANOVA unifactorial | y ~ factor |
o conjunto de contrastes do factor melhora o modelo? |
| ANCOVA aditiva | y ~ A + x |
diferenças entre grupos condicionadas à covariável, assumindo declive comum? |
| ANOVA factorial aditiva | y ~ A + B |
diferenças médias de A e B chegam? |
| ANOVA factorial com interacção | y ~ A * B |
a diferença associada a A depende de B? |
| ANCOVA factorial com declive comum | y ~ A * B + x |
diferenças e interacção entre factores, condicionadas à covariável? |
| ANCOVA com declives diferentes | y ~ A * x |
a relação com a covariável depende do grupo? |
| moderação quantitativa | y ~ x * z |
o declive de x depende de z? |
A vantagem desta tradução é podermos crescer sem trocar de filosofia a cada capítulo. Acrescentamos parâmetros, libertamos restrições e perguntamos sempre que comparação responde à hipótese.
E Se Não For uma Recta?
Até aqui trabalhámos com respostas quantitativas que podemos modelar directamente numa escala linear. Mas uma probabilidade não pode descer abaixo de 0 nem subir acima de 1, e uma contagem não pode prever -3 animais.
A lógica dos contrastes, interacções e comparação de modelos não desaparece. O que muda é a forma como representamos a resposta e a sua variabilidade.
Em Modelos Lineares Generalizados, começamos pelos problemas concretos que obrigam a mudar de família ou de ligação e só depois introduzimos a matemática.
E as Medidas Repetidas?
Até aqui tratámos cada linha como uma observação independente. Quando a mesma pessoa ou unidade aparece várias vezes, precisamos de representar essa estrutura de dependência. A lógica de comparação de modelos continua, mas o termo de erro deixa de ser tão simples.
No capítulo de medidas repetidas e modelos mistos vamos construir primeiro uma ANOVA de medidas repetidas a partir de modelos lineares que incluem o participante, perceber exactamente o que essa manobra faz e ver por que se torna incómoda em delineamentos maiores. Só depois passamos às funções que automatizam essa contabilidade e aos modelos mistos.
E os Pressupostos do Modelo?
A mesma pergunta acompanha todos os modelos deste capítulo: quando é que esta representação dos dados sustenta a inferência que queremos fazer?
A vantagem de a colocar aqui, depois de vermos a família inteira, é que já não precisamos de memorizar uma lista ligeiramente diferente ao lado de cada nome tradicional. Podemos estudar os pressupostos como propriedades do modelo, do termo de erro, do delineamento e da forma como os dados foram gerados. Depois perguntamos o que muda em cada aplicação concreta.
Algumas condições podem ser garantidas pela estrutura do modelo ou pelo próprio delineamento: um único termo numérico não constante, com intercepto, não tem outros preditores com que ser colinear; o factorial completo equilibrado permite a decomposição ortogonal descrita acima. Isso não garante a distribuição ou a independência dos erros. A tradução entre pressupostos de ANOVA e regressão mostra também por que normalidade dentro das células e normalidade dos erros condicionais, tal como homogeneidade e homoscedasticidade, são maneiras de exprimir as mesmas condições nos modelos apropriados. Outras condições tornam-se mais ou menos plausíveis conforme a variável, os grupos, o tamanho da amostra ou a estrutura dos resíduos. Algumas condições relevantes numa aplicação deixam simplesmente de ser a pergunta certa noutra. E diferentes violações ameaçam diferentes conclusões.
Esta organização é menos parecida com uma árvore de decisões, mas permite uma análise mais detalhada. Em vez de decorar «se A, use teste X; se B, use teste Y», podemos perguntar:
- que parte do modelo está em causa?
- que conclusão depende dela?
- quão sensível é essa conclusão ao problema observado?
- que diagnóstico ou conhecimento do delineamento nos informa?
- que alternativa muda apenas a parte do modelo que precisa de mudar?
As respostas podem incluir outra distribuição, uma transformação substantivamente defensável, erros-padrão robustos, bootstrap, estimadores robustos, modelos mistos ou métodos baseados em postos. Pressupostos do Modelo Linear explica as condições e as suas garantias; Estatística Robusta vai mais longe nas alternativas. O tutorial de diagnóstico mostra como investigar os padrões no R.
A árvore de decisões pode ser útil quando estamos a começar. Com a família de modelos já construída, podemos ir além dela e explicar o que cada alternativa muda na análise.
E os Testes «Não-Paramétricos»?
Antes de organizar os métodos em «paramétricos» e «não-paramétricos», preferimos construir a estrutura comum: uma pergunta, um modelo, parâmetros, restrições e uma comparação. Podemos agora usar essa estrutura para perceber o que muda nos métodos baseados em postos.
Muitos destes testes encaixam surpreendentemente bem nesta linguagem quando pensamos em modelos ajustados aos postos (ranks). Mann–Whitney, Wilcoxon, Kruskal–Wallis e Spearman podem ser ligados desta forma a modelos que já conhecemos. A página de Jonas Lindeløv, Common statistical tests are linear models, mostra essas ligações de forma especialmente clara.
Não precisamos de abrir já essa caixa. A equivalência nem sempre é exacta em todos os detalhes do teste, e transformar os dados em postos também muda a quantidade que estamos a analisar.
A receita «testar pressupostos e, se algum teste der significativo, trocar para um teste não-paramétrico» aparece muitas vezes em manuais e aulas introdutórias. É simples, mas pode levar-nos a mudar de método sem perceber o problema. Um teste formal de normalidade, por exemplo, não decide sozinho se um modelo é adequado, e «não-paramétrico» não quer dizer «sem pressupostos».
A pergunta que precisamos de levar para esses métodos é a mesma da secção anterior: que pressuposto importa para que conclusão? Em Pressupostos do Modelo Linear veremos como a estrutura do modelo e o delineamento ajudam a responder. Para perceber o que mudam o trimming, a Winsorização, os estimadores-M, o bootstrap e o jackknife, consulte Estatística Robusta.
5 Síntese
Se tivermos de reter apenas uma ideia deste capítulo, é esta: os nomes tradicionais mudam mais depressa do que a matemática subjacente. Uma média, uma diferença entre grupos, um declive, um factor com vários níveis e uma interacção podem ser representados como parâmetros do mesmo modelo linear.
Fazer inferência passa então por saber:
- que parâmetros o modelo contém;
- que restrição representa a hipótese que queremos avaliar;
- que modelo compacto corresponde a essa restrição;
- que variabilidade deve servir de termo de erro;
- que estimativa e incerteza respondem realmente à pergunta científica.
O tutorial prático de modelos lineares parte daqui, mas faz deliberadamente o contrário deste capítulo: começa pela pergunta de investigação e mostra apenas o código necessário para a responder.
6 Exercícios
As respostas mostram um percurso possível. Tentem resolver cada problema antes de abrir a caixa correspondente.
- Queremos saber se uma variável quantitativa
xajuda a prevery. Escreva um modelo compacto que prevê apenas a média deye um modelo aumentado que acrescentax. Escreva depois a chamadaanova()que compara os dois modelos. Que parâmetro é libertado e o que significa concluir que o modelo aumentado reduz suficientemente o erro?
Solução 1 — Comparar Dois Modelos
Podemos ajustar m0 <- lm(y ~ 1, data = ds) e m1 <- lm(y ~ x, data = ds), comparando-os com anova(m0, m1). O modelo compacto prevê a mesma média para todos os valores de x. O aumentado liberta o declive, \(\beta_1\), e admite que a previsão varie com x.
A comparação pergunta se a redução do erro residual justifica esse parâmetro adicional, tendo em conta a variabilidade que permanece e os pressupostos do teste. Um resultado favorável ao modelo aumentado fornece evidência de associação condicional ao modelo. Não demonstra, por si, que x causa a mudança em y.
- Num contraste -1/+1 para dois grupos, derive as duas médias previstas. Explique por que o intercepto fica a meio das médias e por que o coeficiente do contraste é metade da diferença entre elas.
Solução 2 — Contrastes -1/+1
Se \(\widehat y=\widehat\beta_0+\widehat\beta_1 x\), então \(\widehat y_A=\widehat\beta_0-\widehat\beta_1\) para \(x=-1\) e \(\widehat y_B=\widehat\beta_0+\widehat\beta_1\) para \(x=+1\). Somando as previsões e dividindo por dois, obtemos \(\widehat\beta_0=(\widehat y_A+\widehat y_B)/2\). Subtraindo-as, obtemos \(\widehat\beta_1=(\widehat y_B-\widehat y_A)/2\).
É a codificação que explica estes valores. Com 0/1, a interpretação do intercepto e do declive seria diferente, embora as médias previstas pudessem ser exactamente as mesmas.
- Num modelo
y ~ x1 + x2 + x3, explique o que significa testarx2mantendo os outros dois preditores no modelo. Compare essa pergunta com o teste global do conjunto dos três preditores.
Solução 3 — Um Preditor Condicional aos Outros
Testar x2 mantendo x1 e x3 significa comparar y ~ x1 + x3 com y ~ x1 + x2 + x3. Perguntamos que melhoria x2 acrescenta depois de permitirmos que os outros dois preditores expliquem parte da variação de y. Com um único coeficiente para x2, a comparação liberta um grau de liberdade.
O teste global compara y ~ 1 com y ~ x1 + x2 + x3 e pergunta pelo contributo conjunto dos três declives. É possível que o conjunto ajude a prever y sem que cada preditor acrescente uma melhoria detectável quando os restantes já estão incluídos.
- Um factor tem quatro níveis. Quantos coeficientes são necessários para o representar além do intercepto? Por que o teste omnibus não corresponde a um único teste-t?
Solução 4 — Quatro Níveis
Precisamos de três coeficientes para representar quatro médias, além do intercepto. O modelo usa \(k-1=3\) contrastes independentes, cuja interpretação depende da codificação escolhida.
O teste omnibus compara o modelo sem o factor com o modelo que liberta esses três graus de liberdade. Usa um F com três graus de liberdade no numerador. Um teste-t de um único coeficiente examina apenas um contraste específico e não substitui essa comparação global.
- Numa ANOVA com três grupos A, B e C, as médias estimadas são 4, 6 e 9. Calcule A − B, A − C e B − C. Depois calcule o contraste planeado C − (A + B)/2 e indique os pesos de cada grupo. Quantas diferenças aos pares são independentes?
Solução 5 — Comparações e Contraste Planeado
Com médias A = 4, B = 6 e C = 9, obtemos \(A-B=-2\), \(A-C=-5\) e \(B-C=-3\). O contraste planeado é \(C-(A+B)/2=9-(4+6)/2=4\). Os pesos para A, B e C são, respectivamente, \(-0.5\), \(-0.5\) e \(1\). Somam zero, como esperamos de um contraste entre médias.
Existem três pares possíveis, mas apenas duas diferenças linearmente independentes: por exemplo, \(A-C=(A-B)+(B-C)\). A independência linear dos contrastes não significa que três testes aos pares possam ser interpretados como três decisões sem qualquer problema de multiplicidade.
- Num 2 × 2, compare A1 − A2 em B1 com A1 − A2 em B2. Explique por que comparar os dois valores-p não testa a interacção. Compare ainda
y ~ A + Bcomy ~ A * B.
Solução 6 — Testar a Interacção
Calculemos \(d_1=\overline y_{A1,B1}-\overline y_{A2,B1}\) e \(d_2=\overline y_{A1,B2}-\overline y_{A2,B2}\). A interacção pergunta se \(d_1-d_2\) difere de zero, com a incerteza apropriada. Comparar os valores-p de dois testes separados é outra operação: um resultado significativo e outro não significativo podem ser compatíveis com diferenças de efeito muito semelhantes.
y ~ A + B impõe que a diferença associada a A seja a mesma nos dois níveis de B. y ~ A * B liberta A:B, permitindo que as diferenças mudem. A comparação entre estes modelos testa directamente essa restrição.
- Explique a diferença entre
y ~ A * B + xey ~ A * B * x. Qual deles obriga a covariável a ter o mesmo declive em todas as células?
Solução 7 — Declives da Covariável
Em y ~ A * B + x, a interacção A:B é admitida, mas o declive de x é comum às quatro células de A × B. Estamos a assumir que uma unidade adicional de x se associa à mesma mudança prevista em y, qualquer que seja a combinação dos factores.
y ~ A * B * x inclui também A:x, B:x e A:B:x. Assim, o declive de x pode diferir entre células. Vale a pena perguntar se o delineamento e os dados sustentam essa flexibilidade.
- Num modelo
y ~ x * z, qual é o declive dexquandoz = 0? E quandoz = 2? O que representa o coeficiente dex:z?
Solução 8 — Interacção Entre Preditores Quantitativos
Escrevendo o modelo como \(\widehat y=\beta_0+\beta_x x+\beta_z z+\beta_{xz}xz\), o declive de x para um valor fixo de z é \(\beta_x+\beta_{xz}z\).
Para \(z=0\), o declive é \(\beta_x\). Para \(z=2\), passa a \(\beta_x+2\beta_{xz}\). O coeficiente \(\beta_{xz}\) indica quanto muda o declive de x por cada unidade adicional de z. É esse o significado da interacção neste modelo.
- Opcional: consulte as notas sobre somas de quadrados na regressão múltipla e no modelo factorial. Num 2 × 2 com uma interacção teoricamente importante, explique por que neste material preferimos uma tabela Tipo III com contrastes centrados. Depois dê um caso em que uma comparação sequencial Tipo I seria substantivamente mais natural.
Solução 9 — Tipo III e Tipo I
Num 2 × 2 em que a interacção interessa, a tabela Tipo III com contrastes centrados permite testar cada termo mantendo os restantes no modelo, com efeitos principais interpretados como comparações marginais no quadro da codificação escolhida. É por isso que aqui preferimos essa apresentação para a ANOVA factorial tradicional. Ainda assim, convém interpretar os efeitos principais à luz da interacção e do equilíbrio do delineamento.
O Tipo I responde a uma pergunta diferente: quanto acrescenta cada termo na ordem em que entrou? Imagine um estudo em que variáveis de base, escolhidas previamente, entram no primeiro bloco e uma intervenção entra no segundo. Se a pergunta for expressamente a melhoria obtida depois do primeiro bloco, a comparação sequencial é natural. Mudar a ordem pode mudar as somas de quadrados quando os termos não são ortogonais.
7 Recursos
- Visualização UBC Kingfisher do Teorema do Limite Central
- Aplicação sobre interceptos e declives
- Lindeløv (2019), Common statistical tests are linear models
- Correll et al. (2025), Data Analysis: A Model Comparison Approach to Regression, ANOVA, and Beyond (4.ª ed.) — referência central para a abordagem usada neste capítulo.
- UCLA, contrast coding systems
- NIST/SEMATECH e-Handbook of Statistical Methods
8 Referências
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
Lord, F. M. (1968). Statistical adjustments when comparing preexisting groups (Research Bulletin RB-68-67). Educational Testing Service. https://doi.org/10.1002/j.2333-8504.1968.tb00724.x
Correll, J., Folberg, A. M., Judd, C. M., McClelland, G. H., & Ryan, C. S. (2025). Data analysis: A model comparison approach to regression, ANOVA, and beyond (4.ª ed.). Routledge. https://doi.org/10.4324/9781003438335
Garcia-Marques, L., Garcia-Marques, T., & Brauer, M. (2014). Buy three but get only two: The smallest effect in a 2 × 2 ANOVA is always uninterpretable. Psychonomic Bulletin & Review, 21(6), 1415–1430. https://doi.org/10.3758/s13423-014-0640-3
Loftus, G. R. (1978). On interpretation of interactions. Memory & Cognition, 6(3), 312–319. https://doi.org/10.3758/BF03197461
Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143
Tolios, G. (2026). Simpson’s paradox is a statistical phenomenon where the relationship between two variables changes when grouping the sample into subcategories [LinkedIn post]. LinkedIn. https://lnkd.in/p/eucEvEkn