Modelos Lineares no R
0 Introdução
Este tutorial é para analisar dados. A teoria que une teste-t, regressão, ANOVA, ANCOVA e interacções está no capítulo de comparação de modelos. Para a mecânica de erro-padrão, t e valor-p, consulte Fundamentos da Inferência; para unidades, replicação e alcance causal, consulte Delineamento da Investigação. Aqui partimos dessas ideias e concentramo-nos num fluxo de trabalho mais simples:
pergunta → modelo → estimativa → comparação → gráfico → interpretação
Não precisamos de começar pelo nome do teste. Começamos por perguntar o que queremos saber e escrevemos um modelo que represente essa pergunta.
Depois do modelo de uma média, reutilizamos os dados dos pinguins, acrescentando uma só decisão de cada vez: regressão simples, regressão múltipla aditiva, comparação de grupos e ANCOVA sem interacção. Só depois passamos à ANOVA de dois factores com interacção, à ANCOVA com interacção e à interacção entre preditores quantitativos. É a mesma ordem do capítulo teórico. Em cada caso percorremos o mesmo caminho: formulamos a pergunta, ajustamos o modelo, obtemos a estimativa, comparamos o que precisa de ser comparado, fazemos um gráfico e interpretamos o resultado à luz do delineamento.
Por exemplo, em Dois Grupos perguntamos pela massa nos dois sexos, ajustamos body_mass_g ~ sex, pedimos as médias e a diferença estimada com emmeans(), mostramos os pontos e a média, e só então interpretamos a comparação. Em Preditor Quantitativo, a mesma sequência termina num declive e numa recta ajustada. O modelo muda. O modo de raciocinar mantém-se.
Confirme sempre:
- qual é a unidade de observação;
- se cada linha pode ser tratada como independente;
- que variáveis são quantitativas e quais são factores;
- se há observações repetidas da mesma pessoa, animal, local ou item.
Se a mesma unidade aparece várias vezes, consulte medidas repetidas.
Ter o mesmo nível de um factor em várias linhas é outra coisa. Vários espécimes podem ser Adelie e continuar a ser unidades diferentes. Nesse caso, species é um preditor entre unidades. Procure medidas repetidas ou pseudorreplicação quando as linhas repetem a mesma unidade, ou quando partilham um agrupamento relevante que o modelo está a ignorar.
Confirme também se o identificador é realmente um identificador. Duas linhas com IDs diferentes não garantem duas unidades diferentes se o mesmo organismo, participante ou utilizador puder ter sido registado novamente sob outro código.
1 Preparação
Este tutorial usa palmerpenguins, dplyr, tidyr, ggplot2, emmeans, car e parameters. Se ainda não os instalou, veja a secção sobre pacotes. Num script de análise, carregamos as dependências no início. Usamos ds para a tabela de dados: ao mudar de exemplo, voltamos a preparar ds com os dados adequados.
Sempre que usar preditores categóricos, inclua esta chamada a options() na preparação do script, antes de ajustar os modelos. É a convenção deste material; numa nova sessão do R, volte a executá-la.
A chamada define os contrastes, isto é, a codificação numérica dos factores nos modelos ajustados a partir daí nesta sessão. Não altera modelos já ajustados nem substitui contrastes definidos explicitamente num factor ou na chamada do modelo. Usamos contr.sum para factores não ordenados e contr.poly para factores ordenados. Em contr.sum, os coeficientes dos factores são desvios e não diferenças contra um nível de referência. As previsões e as comparações entre as mesmas médias não mudam por trocar uma codificação completa por outra; muda a leitura dos coeficientes. Esta escolha prepara os testes Tipo III dos modelos factoriais que veremos mais à frente. Por agora, podemos pedir as médias e diferenças com emmeans() sem interpretar essa matriz à mão. A explicação está em contrastes e somas de quadrados.
A sintaxe principal de lm() é:
lm(response ~ predictors, data = ds)+ acrescenta termos. * inclui efeitos principais e a interacção. Para uma explicação completa das fórmulas e da matemática por trás destas comparações, volte ao capítulo teórico.
2 Uma Média
Pergunta
No ficheiro Love4Taylor.csv, a média de Love4Taylor difere de zero? Zero é uma referência com significado nesta escala.
Modelo
m_mean <- lm(Love4Taylor ~ 1, data = ds)Estimativa e Comparação
A estimativa que procuramos é a média. O resumo testa se o intercepto é zero; o intervalo quantifica a incerteza da estimativa:
summary(m_mean)
Call:
lm(formula = Love4Taylor ~ 1, data = ds)

Residuals:
    Min      1Q  Median      3Q     Max
-2.2552 -0.8202  0.1648  0.7548  2.4348

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   0.5652     0.1549   3.649 0.000638 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.095 on 49 degrees of freedomparameters(m_mean)| Parameter | Coefficient | SE | CI | CI_low | CI_high | t | df_error | p |
|---|---|---|---|---|---|---|---|---|
| (Intercept) | 0.5652 | 0.1548904 | 0.95 | 0.2539361 | 0.8764639 | 3.649031 | 49 | 0.0006379 |
O modelo compacto Love4Taylor ~ 0 fixa todas as previsões em zero; Love4Taylor ~ 1 estima uma média. A comparação pergunta se acrescentar o intercepto melhora o ajuste. É o teste t de uma amostra contra zero: para este único parâmetro, o F da comparação é o quadrado do t. A demonstração teórica desenvolve esta comparação.
Não nos interessa apenas saber se o valor-p atravessou um limiar. A estimativa é a média. O intervalo mostra a incerteza associada a essa estimativa sob o modelo.
Para testar a média contra uma referência mu0, recentre a resposta:
mu0 <- 3
m_ref <- lm(I(Love4Taylor - mu0) ~ 1, data = ds)
summary(m_ref)
parameters(m_ref)
O intercepto passa a ser a diferença média relativamente a mu0.
3 Preditor Quantitativo
Pergunta
Como varia a massa corporal prevista com o comprimento da barbatana?
Dados. Voltamos a preparar ds, agora com os pinguins. Seleccionamos as variáveis usadas nos exemplos seguintes e conservamos os casos completos, como na limpeza de dados:
Usamos a mesma amostra nos modelos seguintes. Num estudo próprio, seleccione apenas as variáveis necessárias, registe as exclusões e investigue os omissos: um valor em falta em sex não impediria, por si só, um gráfico de massa.
Modelo. Ajustamos uma recta aos dados:
m_flipper <- lm(body_mass_g ~ flipper_length_mm, data = ds)Comparamos esta recta com um modelo que prevê apenas a média: acrescentar o declive justifica a complexidade adicional?
Estimativa e comparação. O declive responde directamente à pergunta: mudança prevista na massa por unidade adicional de flipper_length_mm. O intervalo quantifica a incerteza dessa estimativa.
summary(m_flipper)
Call:
lm(formula = body_mass_g ~ flipper_length_mm, data = ds)
Residuals:
Min 1Q Median 3Q Max
-1057.33 -259.79 -12.24 242.97 1293.89
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -5872.09 310.29 -18.93 <2e-16 ***
flipper_length_mm 50.15 1.54 32.56 <2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 393.3 on 331 degrees of freedom
Multiple R-squared: 0.7621, Adjusted R-squared: 0.7614
F-statistic: 1060 on 1 and 331 DF, p-value: < 2.2e-16parameters(m_flipper)| Parameter | Coefficient | SE | CI | CI_low | CI_high | t | df_error | p |
|---|---|---|---|---|---|---|---|---|
| (Intercept) | -5872.09268 | 310.285155 | 0.95 | -6482.47224 | -5261.71313 | -18.92483 | 331 | 0 |
| flipper_length_mm | 50.15327 | 1.540231 | 0.95 | 47.12339 | 53.18314 | 32.56217 | 331 | 0 |
emmeans() Sem Grupos: ~ 1
Mergulhar Mais Fundo
Na primeira leitura, podemos seguir para o gráfico da relação. Para explorar as previsões e o intercepto, continue abaixo.
Também podemos pedir uma única estimativa prevista, sem a dividir por grupos:
emmeans(m_flipper, ~ 1) 1 emmean SE df lower.CL upper.CL
overall 4207 21.6 331 4165 4249
Confidence level used: 0.95 ~ 1 Não Significa «Intercepto»
Em emmeans, ~ 1 significa apenas uma estimativa sem grupos. Se o modelo tiver preditores quantitativos, estes são por defeito avaliados nos valores da grelha de referência — normalmente as suas médias — e não necessariamente em zero. Portanto, não chame automaticamente a este resultado «o intercepto».
Aqui, a chamada devolve a massa prevista para um pinguim com comprimento da barbatana igual à média observada.
Se quisermos pedir exactamente a previsão associada ao intercepto do modelo, temos de avaliar a recta em zero:
coef(m_flipper)[1](Intercept)
-5872.093 O primeiro coeficiente é o intercepto: num modelo y = beta0 + beta1 * x, quando x = 0 a previsão é beta0. Neste exemplo, contudo, uma barbatana com 0 mm está muito fora dos dados e o intercepto original não tem uma interpretação biológica útil.
Podemos recentrar o preditor para dar ao zero um significado melhor:
(Intercept)
4158.561 Agora zero significa 200 mm de barbatana. O intercepto descreve uma previsão num ponto plausível e fácil de interpretar. Em modelos Gaussianos com ligação identidade, não precisamos de type = "response": a escala do modelo já é a escala da resposta.
Gráfico
Gráfico. Mostramos os dados, a recta estimada e a respectiva faixa de incerteza:
ggplot(ds, aes(x = flipper_length_mm, y = body_mass_g)) +
geom_point(alpha = 0.45) +
geom_smooth(method = "lm", se = TRUE) +
theme_classic() +
labs(x = "Flipper length (mm)", y = "Body mass (g)")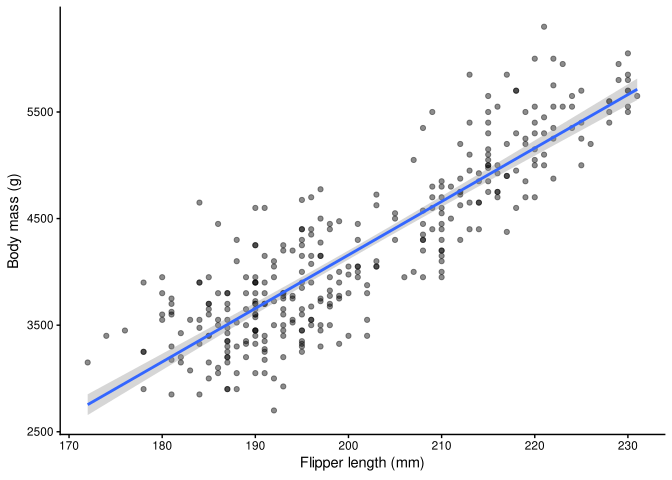
Interpretação
O declive é a mudança prevista na massa corporal por cada milímetro adicional de barbatana, dentro do intervalo observado. A recta ajuda a verificar se uma relação linear é uma descrição razoável e se há zonas com poucos dados. Não interprete automaticamente a associação como causal: estes dados não são uma experiência em que se tenha manipulado o comprimento da barbatana.
4 Dois Preditores Quantitativos
Pergunta
A associação entre comprimento da barbatana e massa mantém-se quando incluímos também o comprimento do bico?
Call:
lm(formula = body_mass_g ~ flipper_length_mm + bill_length_mm,
data = ds)
Residuals:
Min 1Q Median 3Q Max
-1083.08 -282.65 -17.18 242.95 1293.24
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -5836.299 312.604 -18.670 <2e-16 ***
flipper_length_mm 48.890 2.034 24.034 <2e-16 ***
bill_length_mm 4.959 5.214 0.951 0.342
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 393.4 on 330 degrees of freedom
Multiple R-squared: 0.7627, Adjusted R-squared: 0.7613
F-statistic: 530.4 on 2 and 330 DF, p-value: < 2.2e-16Anova(m_two_quant, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 53945591.1 | 1 | 348.5678643 | 0.0000000 |
| flipper_length_mm | 89395169.9 | 1 | 577.6242850 | 0.0000000 |
| bill_length_mm | 139999.8 | 1 | 0.9046045 | 0.3422461 |
| Residuals | 51071962.9 | 330 | NA | NA |
No summary(), o F global compara os dois declives em conjunto com um modelo que prevê apenas a média. Na tabela Tipo III, flipper_length_mm compara o modelo completo com a restrição de declive zero para a barbatana, mantendo o bico; bill_length_mm faz a comparação inversa. Residuals descreve o erro restante e a linha do intercepto testa a previsão quando ambos os preditores são zero, aqui sem interesse biológico directo. Cada F compara a redução de erro com os graus de liberdade acrescentados.
O declive de cada preditor descreve a mudança prevista mantendo o outro constante. Trata-se de associações, não necessariamente de efeitos causais.
5 Dois Grupos
Pergunta
Nos dados dos pinguins, qual é a diferença estimada de massa corporal entre os dois níveis de sex?
Modelo. Ajustamos uma média para cada nível:
m_sex <- lm(body_mass_g ~ sex, data = ds)Estimativa e comparação. Em vez de interpretar a codificação do coeficiente à mão, pedimos ao modelo as médias previstas e a diferença entre elas:
emmeans(m_sex, pairwise ~ sex)$emmeans
sex emmean SE df lower.CL upper.CL
female 3862 56.8 331 3750 3974
male 4546 56.3 331 4435 4656
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
female - male -683 80 331 -8.542 <0.0001Gráfico. Verificamos se a diferença resumida pelo modelo faz sentido face aos dados:
ggplot(ds, aes(x = sex, y = body_mass_g)) +
geom_jitter(width = 0.12, alpha = 0.35) +
stat_summary(fun = mean, geom = "point", size = 3) +
theme_classic() +
labs(x = "Sex", y = "Body mass (g)")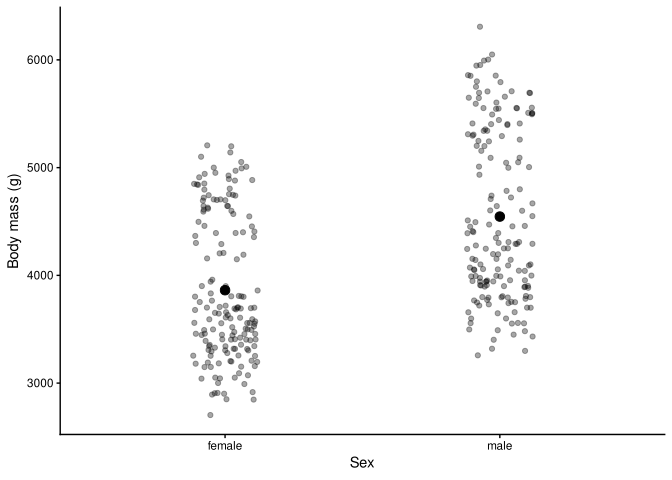
Interpretação
A diferença estimada compara as massas previstas para os dois sexos no modelo sem outros preditores. Com os níveis female, male, contr.sum atribui +1 a female e −1 a male: o intercepto é o ponto médio das duas médias e sex1 é metade de female − male, não a diferença inteira nem male − female. O contraste de emmeans() mostra directamente female − male, em gramas. O gráfico permite ver se essa diferença representa a separação geral dos dados ou se esconde grande sobreposição. Como sex não foi atribuído experimentalmente, a comparação descreve estes pinguins. Não estima o efeito causal de alterar o sexo.
6 Vários Grupos
Pergunta
A massa corporal prevista varia entre espécies?
m_species <- lm(body_mass_g ~ species, data = ds)A linha species dá o teste omnibus: compara o modelo completo, com as duas colunas de contraste necessárias para três espécies, com o modelo sem esses contrastes, que prevê uma única média. Pergunta se as três médias são iguais. Não precisamos de ajustar um modelo compacto à parte:
Anova(m_species, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5242015989 | 1 | 24687.8683 | 0 |
| species | 145190219 | 2 | 341.8949 | 0 |
| Residuals | 70069447 | 330 | NA | NA |
Depois, escolha as comparações que respondem à pergunta. Na saída de emmeans(), a primeira tabela apresenta as médias marginais estimadas (EMMs) por espécie; a segunda, as diferenças entre pares. Nesta ANOVA de um factor as EMMs coincidem com as médias observadas de cada grupo. Para a família completa dos três pares, Tukey é uma escolha natural. A explicação dos pesos dos contrastes está na primeira ANOVA da teoria:
emmeans(m_species, pairwise ~ species, adjust = "tukey")$emmeans
species emmean SE df lower.CL upper.CL
Adelie 3706 38.1 330 3631 3781
Chinstrap 3733 55.9 330 3623 3843
Gentoo 5092 42.2 330 5009 5176
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
Adelie - Chinstrap -26.9 67.7 330 -0.398 0.9164
Adelie - Gentoo -1386.3 56.9 330 -24.359 <0.0001
Chinstrap - Gentoo -1359.3 70.0 330 -19.406 <0.0001
P value adjustment: tukey method for comparing a family of 3 estimates Se tinha planeado uma comparação mais específica, escreva-a directamente em vez de gerar todos os pares só porque estão disponíveis.
ggplot(ds, aes(x = species, y = body_mass_g, colour = sex)) +
geom_jitter(
position = position_jitterdodge(dodge.width = 0.5, jitter.width = 0.12),
alpha = 0.3
) +
stat_summary(
fun = mean,
geom = "point",
position = position_dodge(width = 0.5),
size = 3
) +
theme_classic() +
labs(x = "Species", y = "Body mass (g)", colour = "Sex")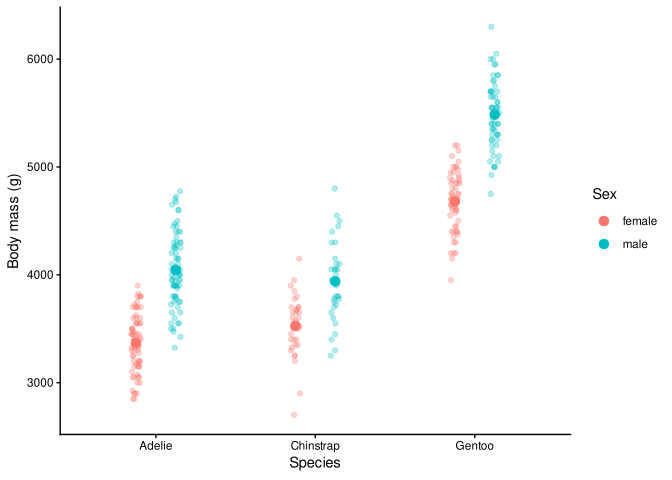
Interpretação
O omnibus responde apenas se o modelo com médias específicas por espécie melhora o modelo de uma só média. As comparações e o gráfico dizem quais espécies diferem e quanta sobreposição existe. Se a pergunta tiver sido planeada para um par de espécies, esse contraste é preferível a escolher uma comparação depois de ver todos os resultados.
7 ANCOVA Sem Interacção
Pergunta
A associação entre comprimento da barbatana e massa corporal mantém-se quando também incluímos species?
Call:
lm(formula = body_mass_g ~ species + flipper_length_mm, data = ds)
Residuals:
Min 1Q Median 3Q Max
-898.8 -252.0 -24.8 229.8 1191.6
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -3986.80 619.53 -6.435 4.36e-10 ***
species1 -26.38 43.81 -0.602 0.547
species2 -231.76 37.50 -6.180 1.89e-09 ***
flipper_length_mm 40.61 3.08 13.186 < 2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 373.3 on 329 degrees of freedom
Multiple R-squared: 0.787, Adjusted R-squared: 0.7851
F-statistic: 405.3 on 3 and 329 DF, p-value: < 2.2e-16Anova(m_additive, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5770339 | 1 | 41.41167 | 0 |
| species | 5368818 | 2 | 19.26505 | 0 |
| flipper_length_mm | 24226302 | 1 | 173.86359 | 0 |
| Residuals | 45843144 | 329 | NA | NA |
A partir daqui mostramos regularmente dois resumos do mesmo modelo. summary() apresenta as estimativas, erros-padrão e testes t dos coeficientes. Anova(..., type = "III") organiza testes F por termo: uma linha pode testar um único declive ou, no caso de um factor, vários coeficientes em conjunto. A linha species testa esse factor depois de considerar o comprimento; a linha do comprimento testa o declive depois de considerar a espécie.
Com contr.sum e os níveis Adelie, Chinstrap, Gentoo, os coeficientes species1 e species2 representam os desvios de Adelie e Chinstrap relativamente à média das três previsões por espécie, com pesos iguais. O desvio de Gentoo é o negativo da soma dos outros dois. Não são diferenças contra uma espécie de referência. Neste modelo aditivo, as três previsões usam o mesmo comprimento de barbatana; o intercepto refere-se a 0 mm e, por isso, não tem uma interpretação biológica útil.
Para perceber que comparação corresponde a cada linha, veja contrastes e somas de quadrados.
Para comunicar os resultados, costuma ser mais útil pedir previsões ou médias ajustadas que correspondam à pergunta científica:
emmeans(m_additive, pairwise ~ species)$emmeans
species emmean SE df lower.CL upper.CL
Adelie 4147 45.5 329 4058 4237
Chinstrap 3942 48.0 329 3848 4036
Gentoo 4432 60.7 329 4312 4551
Confidence level used: 0.95
$contrasts
contrast estimate SE df t.ratio p.value
Adelie - Chinstrap 205 57.6 329 3.568 0.0012
Adelie - Gentoo -285 95.4 329 -2.981 0.0086
Chinstrap - Gentoo -490 87.0 329 -5.631 <0.0001
P value adjustment: tukey method for comparing a family of 3 estimates emtrends(m_additive, ~ species, var = "flipper_length_mm") species flipper_length_mm.trend SE df lower.CL upper.CL
Adelie 40.6 3.08 329 34.5 46.7
Chinstrap 40.6 3.08 329 34.5 46.7
Gentoo 40.6 3.08 329 34.5 46.7
Confidence level used: 0.95 O gráfico sobrepõe aos dados as previsões de m_additive: as rectas têm um declive comum e estão desenhadas dentro dos comprimentos observados em cada espécie.
ds$pred_additive <- predict(m_additive)
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species)) +
geom_point(alpha = 0.4) +
geom_line(aes(y = pred_additive)) +
theme_classic() +
labs(x = "Flipper length (mm)", y = "Body mass (g)",
colour = "Species")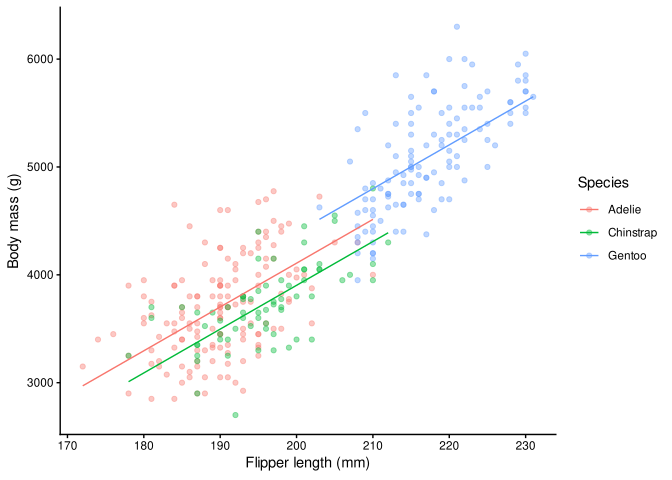
Interpretação
Aqui a pergunta mudou: o declive de flipper_length_mm é estimado depois de incluir species, e as médias de espécie são comparadas no mesmo valor de referência do preditor quantitativo. As rectas são paralelas porque o modelo impõe um declive comum; os pontos ajudam a avaliar essa descrição. Para examinar declives que podem diferir entre espécies, precisamos da interacção apresentada mais à frente.
Incluir uma variável num modelo não resolve, por si só, o confundimento. Num modelo múltiplo, a interpretação de cada coeficiente depende dos restantes termos que também estão no modelo. Isso é uma propriedade estatística, não uma afirmação causal sobre o que aconteceria se manipulássemos uma das variáveis.
8 Interacção Entre Factores
Pergunta
A diferença entre níveis de sex é igual em todas as espécies?
Na ANOVA de dois factores, cada combinação de species e sex é uma célula. O modelo completo permite uma média própria por célula: os contrastes dos factores e os seus produtos representam esses vários níveis médios. Sem species:sex, as diferenças entre sexos seriam obrigatoriamente iguais em todas as espécies. Ajustamos o modelo com interacção e lemos essa linha:
Call:
lm(formula = body_mass_g ~ species * sex, data = ds)
Residuals:
Min 1Q Median 3Q Max
-827.21 -213.97 11.03 206.51 861.03
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 4173.85 17.85 233.799 < 2e-16 ***
species1 -467.68 23.18 -20.177 < 2e-16 ***
species2 -440.76 28.07 -15.702 < 2e-16 ***
sex1 -315.25 17.85 -17.659 < 2e-16 ***
species1:sex1 -22.08 23.18 -0.952 0.341589
species2:sex1 109.37 28.07 3.896 0.000118 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 309.4 on 327 degrees of freedom
Multiple R-squared: 0.8546, Adjusted R-squared: 0.8524
F-statistic: 384.3 on 5 and 327 DF, p-value: < 2.2e-16Anova(m_interaction, type = "III")| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5232595969 | 1 | 54661.827958 | 0.0000000 |
| species | 143001222 | 2 | 746.924492 | 0.0000000 |
| sex | 29851220 | 1 | 311.838003 | 0.0000000 |
| species:sex | 1676557 | 2 | 8.756997 | 0.0001973 |
| Residuals | 31302628 | 327 | NA | NA |
Essa linha testa se a diferença entre sexos varia entre espécies. A tabela Tipo III mantém species, sex e species:sex no mesmo modelo, usando os contrastes centrados definidos no início. Neste modelo com interacção, sex1 é metade da diferença female − male, calculada com o mesmo peso para cada espécie. Os coeficientes species1:sex1 e species2:sex1 são os desvios das respectivas meias-diferenças relativamente a essa média. Para obter diferenças inteiras em gramas, usamos os contrastes abaixo.
Ao testar a diferença média entre espécies, por exemplo, o modelo continua a estimar os coeficientes de sex e de species:sex. Para essa pergunta, são parâmetros auxiliares (nuisance parameters): precisamos de os estimar, embora o alvo do teste seja a diferença entre espécies. A nota sobre Tipo II e Tipo III com interacções explica a convenção que usamos.
Se a interacção for relevante, não pare na linha da tabela. Na ANOVA de um factor aprendemos a comparar pares; agora repetimos a mesma operação em cada nível do outro factor. Podemos comparar os sexos dentro de cada espécie, ou as espécies dentro de cada sexo. Estas são comparações de efeitos simples, como as que desenvolvemos na ANOVA factorial da teoria. Não precisamos de gerar todos os pares possíveis entre as seis células.
O ajustamento refere-se à família de comparações que decidimos interpretar. Esta chamada reúne as médias por célula e as duas orientações das comparações condicionais, usando Tukey para os pares. Uma chamada única não transforma automaticamente todas as diferenças numa só família: as comparações com | são normalmente ajustadas separadamente dentro dos níveis do factor que aparece depois da barra. Se pretendermos interpretar conjuntamente várias dessas comparações, precisamos de escolher o ajustamento adequado:
$`emmeans of species, sex`
species sex emmean SE df lower.CL upper.CL
Adelie female 3369 36.2 327 3273 3465
Chinstrap female 3527 53.1 327 3387 3668
Gentoo female 4680 40.6 327 4572 4787
Adelie male 4043 36.2 327 3948 4139
Chinstrap male 3939 53.1 327 3799 4079
Gentoo male 5485 39.6 327 5380 5590
Confidence level used: 0.95
Conf-level adjustment: sidak method for 6 estimates
$`emmeans of sex | species`
species = Adelie:
sex emmean SE df lower.CL upper.CL
female 3369 36.2 327 3298 3440
male 4043 36.2 327 3972 4115
species = Chinstrap:
sex emmean SE df lower.CL upper.CL
female 3527 53.1 327 3423 3632
male 3939 53.1 327 3835 4043
species = Gentoo:
sex emmean SE df lower.CL upper.CL
female 4680 40.6 327 4600 4760
male 5485 39.6 327 5407 5563
Confidence level used: 0.95
$`pairwise differences of sex | species`
species = Adelie:
2 estimate SE df t.ratio p.value
female - male -675 51.2 327 -13.174 <0.0001
species = Chinstrap:
2 estimate SE df t.ratio p.value
female - male -412 75.0 327 -5.487 <0.0001
species = Gentoo:
2 estimate SE df t.ratio p.value
female - male -805 56.7 327 -14.188 <0.0001
$`emmeans of species | sex`
sex = female:
species emmean SE df lower.CL upper.CL
Adelie 3369 36.2 327 3298 3440
Chinstrap 3527 53.1 327 3423 3632
Gentoo 4680 40.6 327 4600 4760
sex = male:
species emmean SE df lower.CL upper.CL
Adelie 4043 36.2 327 3972 4115
Chinstrap 3939 53.1 327 3835 4043
Gentoo 5485 39.6 327 5407 5563
Confidence level used: 0.95
$`pairwise differences of species | sex`
sex = female:
2 estimate SE df t.ratio p.value
Adelie - Chinstrap -158 64.2 327 -2.465 0.0377
Adelie - Gentoo -1311 54.4 327 -24.088 <0.0001
Chinstrap - Gentoo -1153 66.8 327 -17.246 <0.0001
sex = male:
2 estimate SE df t.ratio p.value
Adelie - Chinstrap 105 64.2 327 1.627 0.2357
Adelie - Gentoo -1441 53.7 327 -26.855 <0.0001
Chinstrap - Gentoo -1546 66.2 327 -23.345 <0.0001
P value adjustment: tukey method for comparing a family of 3 estimates ggplot(ds, aes(x = species, y = body_mass_g, colour = sex)) +
geom_jitter(
position = position_jitterdodge(dodge.width = 0.5, jitter.width = 0.12),
alpha = 0.3
) +
stat_summary(
fun = mean,
geom = "point",
position = position_dodge(width = 0.5),
size = 3
) +
theme_classic() +
labs(x = "Species", y = "Body mass (g)", colour = "Sex")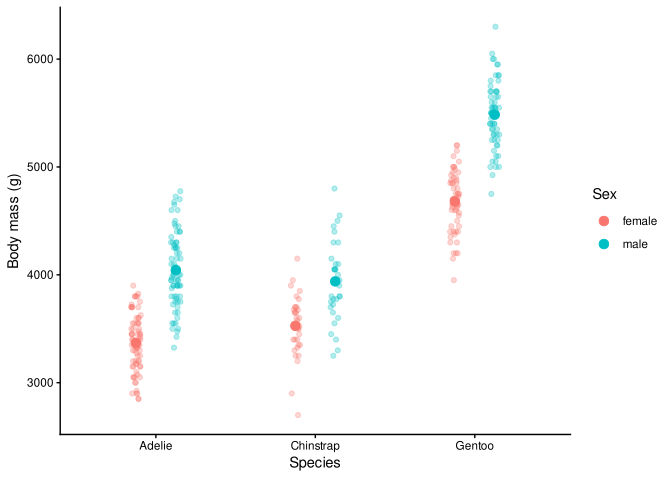
Interpretação
A diferença entre sexos não é necessariamente a mesma em todas as espécies. A comparação entre os modelos pergunta se permitir essa diferença entre espécies melhora a explicação dos dados. As médias por célula, os contrastes condicionais e o gráfico mostram em que espécies a diferença aparece e evitam reduzir uma interacção a dois valores-p separados.
9 ANCOVA Com Interacção
Pergunta
A associação entre comprimento da barbatana e massa corporal é igual nas três espécies?
Na ANCOVA Sem Interacção, ajustámos m_additive, com um único declive e interceptos diferentes por espécie. Agora libertamos a restrição de declives paralelos. É a mesma lógica da interacção entre factores: uma associação pode depender do outro preditor. Permitimos que o declive varie por espécie:
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5663696 | 1 | 41.720187 | 0.0000000 |
| species | 1229661 | 2 | 4.528993 | 0.0114771 |
| flipper_length_mm | 22649648 | 1 | 166.842898 | 0.0000000 |
| species:flipper_length_mm | 1451475 | 2 | 5.345963 | 0.0051931 |
| Residuals | 44391669 | 327 | NA | NA |
A linha species:flipper_length_mm testa se os declives são iguais. Se o modelo com interacção for necessário para responder à pergunta, examine os declives directamente. Mantemos emtrends() e pairs() separados: primeiro estimamos os declives por espécie, depois contrastamos essas estimativas. Não são médias e comparações da resposta numa única especificação emmeans().
| species | flipper_length_mm.trend | SE | df | lower.CL | upper.CL | t.ratio | p.value |
|---|---|---|---|---|---|---|---|
| Adelie | 32.68891 | 4.691630 | 327 | 23.45933 | 41.91850 | 6.967497 | 0e+00 |
| Chinstrap | 34.57339 | 6.311529 | 327 | 22.15707 | 46.98972 | 5.477816 | 1e-07 |
| Gentoo | 54.16542 | 5.150527 | 327 | 44.03307 | 64.29777 | 10.516481 | 0e+00 |
| contrast | estimate | SE | df | lower.CL | upper.CL | t.ratio | p.value |
|---|---|---|---|---|---|---|---|
| Adelie - Chinstrap | -1.88448 | 7.864273 | 327 | -20.40041 | 16.6314458 | -0.2396254 | 0.9688451 |
| Adelie - Gentoo | -21.47651 | 6.967016 | 327 | -37.87990 | -5.0731138 | -3.0825974 | 0.0062871 |
| Chinstrap - Gentoo | -19.59203 | 8.146369 | 327 | -38.77213 | -0.4119247 | -2.4050013 | 0.0440144 |
E veja o padrão no gráfico:
ggplot(ds, aes(
x = flipper_length_mm,
y = body_mass_g,
colour = species
)) +
geom_point(alpha = 0.4) +
geom_smooth(method = "lm", se = TRUE) +
theme_classic() +
labs(
x = "Flipper length (mm)",
y = "Body mass (g)",
colour = "Species"
)
Interpretação
O modelo aditivo impõe uma diferença constante entre espécies ao longo do comprimento de barbatana. O modelo com interacção permite que essa diferença mude: continuamos a poder comparar espécies para o mesmo comprimento, mas precisamos de dizer qual. A linha de interacção de m_slopes, as estimativas dos declives e o gráfico descrevem essa mudança, em vez de usarmos apenas um limiar de valor-p para escolher o modelo. Devemos interpretar os declives ou previsões em valores substantivamente úteis, com suporte nas espécies comparadas, sem extrapolar.
10 Interacção Quantitativa
Para uma interacção entre duas variáveis quantitativas, o fluxo é o mesmo. Ajuste o modelo com interacção e leia a linha x:z:
Se a interacção for necessária, não há um único «efeito de x» que possamos apresentar sem qualificação. Estime o declive de x em valores de z que sejam úteis para a pergunta e estejam dentro do intervalo coberto pelos dados.
A página de comparação de modelos explica por que este declive muda com z. emtrends() permite pedir esses declives sem fazer a álgebra à mão.
Estimativa, Gráfico e Interpretação
Depois de ler o teste da interacção, peça os declives de x em valores de z que façam sentido para a investigação e represente as previsões. Assim, a conclusão pode dizer em que valores de z a associação muda, em vez de apresentar um efeito médio que não responde à pergunta. Se z não variar suficientemente na amostra, essa leitura será incerta. O gráfico deve tornar essa limitação visível.
11 Diagnóstico
Um modelo executado sem erro não é automaticamente um bom modelo. Depois de especificar a pergunta e ajustar o modelo, examine:
- linearidade quando há preditores quantitativos;
- padrão e variância dos resíduos;
- observações muito influentes;
- independência de acordo com o delineamento;
- se as previsões estão a extrapolar para regiões sem dados.
O tutorial de pressupostos e diagnóstico desenvolve este passo.
12 Da Pergunta ao Modelo
| Pergunta | Modelo típico | O que pedir depois |
|---|---|---|
| A média difere de uma referência? |
y ~ 1 depois de recentrar |
intercepto + IC |
| Y varia com X? | y ~ x |
declive + IC + gráfico |
| X acrescenta informação depois de incluir Z? | y ~ x + z |
coeficiente/contraste condicional |
| Dois grupos diferem? | y ~ group |
emmeans() + pairs()
|
| Vários grupos diferem? | y ~ group |
omnibus + contrastes planeados |
| Os grupos diferem para o mesmo valor de X, com declive comum? | y ~ group + x |
médias ajustadas + declive comum |
| Uma diferença depende de outro factor? | y ~ A * B |
células + efeitos simples |
| Um declive depende do grupo? | y ~ group * x |
emtrends() + gráfico |
| Um declive depende de outra variável quantitativa? | y ~ x * z |
declives simples |
13 Exercícios
- Em
Love4Taylor.csv, escolha uma referência com significado diferente de zero. Recentre a resposta e interprete o intercepto e o intervalo de confiança.
Solução 1: Uma Referência Com Significado
Por exemplo, se 3 for uma referência substantivamente útil na escala, recentre a resposta nesse valor. O intercepto passa a ser a diferença média relativamente a 3, e o intervalo é o intervalo dessa diferença:
Uma estimativa positiva indica uma média acima de 3; uma negativa indica uma média abaixo de 3. O intervalo mostra quais diferenças relativamente a 3 são compatíveis com o modelo.
- Em
penguins, ajustebody_mass_g ~ species. Escolha antes de ver os resultados uma diferença que lhe interessaria comparar. Depois peça, comemmeans(), as médias estimadas e todos os pares, e calcule o contraste que tinha planeado. O que distingue este contraste do conjunto das comparações exploratórias?
Solução 2: Comparação Planeada Entre Espécies
Podemos decidir antecipadamente comparar Adelie com Gentoo. O modelo dá-nos primeiro as três médias estimadas e todas as comparações aos pares. A pergunta que planeámos usa o mesmo modelo, mas pede directamente a diferença escolhida:
ds <- penguins |>
  select(body_mass_g, flipper_length_mm, bill_length_mm, species, sex) |>
  drop_na()
m_species <- lm(body_mass_g ~ species, data = ds)
# Estimated means and all three pairs.
emmeans(m_species, pairwise ~ species, adjust = "tukey")
# Comparison chosen before inspecting the results.
emm_species <- emmeans(m_species, ~ species)
levels(emm_species)
contrast(
emm_species,
list("Adelie - Gentoo" = c(1, 0, -1))
)Os pesos seguem a ordem dos níveis, que neste conjunto é Adelie, Chinstrap, Gentoo. Uma comparação aos pares pode ser planeada. O que muda é quando e porquê escolhemos a pergunta, não a fórmula da diferença. Interpretar muitos contrastes continua a exigir atenção à multiplicidade.
- Ajuste
body_mass_g ~ flipper_length_mm. Interprete o declive em unidades reais e faça um gráfico com os dados observados e a recta ajustada.
Solução 3: Declive e Recta Ajustada
m_flipper <- lm(body_mass_g ~ flipper_length_mm, data = ds)

coef(m_flipper)["flipper_length_mm"]
parameters(m_flipper)

ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(alpha = 0.45) +
  geom_smooth(method = "lm", se = TRUE) +
  theme_classic() +
  labs(
    x = "Flipper length (mm)",
    y = "Body mass (g)"
  )
O declive está em gramas por milímetro: o seu sinal indica a direcção da mudança prevista e o intervalo quantifica a incerteza. Interprete-o dentro do intervalo de comprimentos observado, não como uma previsão para qualquer comprimento.
-
Ajuste
body_mass_g ~ species * sexe interprete a linhaspecies:sexda tabela Tipo III. Depois peça, numa só chamada:Distinga efeitos médios de comparações condicionais. Se olhar apenas para uma diferença média entre sexos, que informação pode perder?
Solução 4: Interacção Entre Espécie e Sexo
As comparações sem | resumem diferenças médias considerando os níveis do outro factor. As comparações condicionais depois de | perguntam pela diferença dentro de cada nível. Uma única diferença média entre sexos pode esconder que a sua magnitude, ou mesmo a sua direcção, varia entre espécies.
- Ajuste o modelo
species * flipper_length_mme interprete o teste da interacção. Useemtrends()para avaliar a hipótese de declive comum.
Solução 5: Declives Comuns ou Específicos por Espécie
No modelo paralelo, todas as espécies partilham um declive. No modelo com interacção, emtrends() estima um declive por espécie e compara-os; se estes forem importantes para a pergunta, uma única diferença ajustada entre espécies não resume todos os comprimentos de barbatana.
14 Recursos
15 Síntese
No trabalho prático, podemos consultar a teoria de cada teste quando for necessário. O percurso é escrever claramente a pergunta, ajustar um modelo que a represente, pedir a estimativa ou contraste que lhe responde e mostrar a incerteza e o padrão nos dados.
Quando surgir uma dúvida sobre por que duas análises são equivalentes, por que um factor precisa de contrastes, o que uma interacção muda ou o que distingue Tipo I, II e III, essa explicação pertence ao capítulo teórico.