Fundamentos da Inferência
Do processo aleatório ao valor-p, ao erro-padrão e ao t
Fundamentos
Inferência
Do erro-padrão ao valor-p: como funciona a inferência frequentista.
Voltemos à moeda: seis caras em dez lançamentos são motivo para suspeitar de que favorece caras? Se cada lançamento independente tiver probabilidade .5 de dar cara, obter seis ou mais caras tem probabilidade aproximada de .377. Na Filosofia da Estatística, este exemplo levou-nos a distinguir evidência, decisão e capacidade de descobrir erros.
Agora vamos perceber como se fazem as contas e generalizar: a mesma estrutura aparece numa tarefa auditiva, nas médias e nos testes. Especificamos um processo de referência, calculamos o que ele poderia produzir e comparamos com o resultado observado. Não precisamos de saber R para acompanhar o raciocínio.
0 Do Processo Aleatório à Distribuição de Referência
Imaginem uma tarefa de percepção com duas alternativas. Em cada ensaio, a pessoa ouve dois intervalos: num deles há um tom muito ténue misturado com ruído; no outro há apenas ruído. A posição do tom é aleatorizada e a pessoa tem de escolher em que intervalo o ouviu.
Se não conseguir detectar qualquer diferença, resta-lhe adivinhar. Como o tom pode estar em qualquer um dos dois intervalos com igual probabilidade, sob a hipótese nula de puro palpite, \(H_0\), a probabilidade de acertar é
\[ P(\text{acerto}\mid H_0)=.5. \]
Depois de 10 ensaios independentes, observámos 6 acertos. A pergunta passa a ser: quantos acertos seriam ainda compatíveis com este processo de puro palpite?
Aqui, «aleatório» não identifica sozinho uma distribuição. Precisamos de dizer que processo estamos a modelar, que resultados admite e com que probabilidades.
Primeiro: Um Processo 50/50
A matemática da moeda transfere-se para esta tarefa: contamos acertos em vez de caras, com a mesma probabilidade de referência de .5. Vamos agora construir a distribuição e mostrar de onde vêm as probabilidades.
Se não existe qualquer capacidade de discriminação, cada decisão tem duas alternativas e a probabilidade de acertar é .5. Para 10 decisões independentes, o número de respostas correctas, \(X\), segue então uma distribuição binomial:
\[ X \sim \operatorname{Binomial}(10,.5). \]
Como esta distribuição é discreta, conseguimos escrever todos os resultados que o processo aleatório especificado pode produzir e a probabilidade de cada um. Já sabemos, pelas distribuições de probabilidade, que somar essas probabilidades nos permite calcular a probabilidade de um conjunto de resultados.
Agora vamos perceber de onde vêm os números. Para obter exactamente seis acertos em dez tentativas independentes, precisamos de escolher quais foram as seis tentativas correctas. Existem \(\binom{10}{6}=210\) maneiras de o fazer. Cada sequência específica com seis acertos e quatro erros tem probabilidade \((.5)^{10}\). Por isso:
\[ P(X=6)=\binom{10}{6}(.5)^6(.5)^4 =\frac{210}{1024}\approx .205. \]
A distribuição binomial faz este cálculo para cada contagem possível. A seguir, juntamos as probabilidades dos resultados que respondem à pergunta científica. Ainda não precisamos de um erro-padrão estimado nem de uma distribuição t.
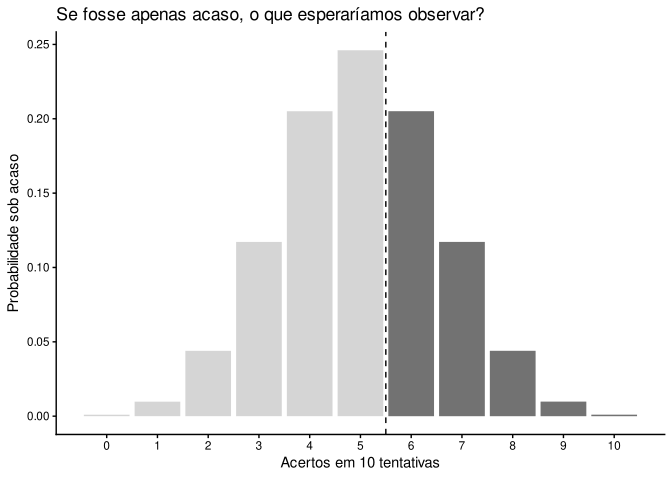
Agora já podemos tornar a pergunta precisa. Para os 6 acertos em 10 que observámos, não perguntamos apenas se 6 é maior do que 5. Perguntamos: se as respostas fossem geradas pelo processo de puro palpite especificado em \(H_0\), com que frequência obteríamos 6 ou mais acertos? O limite inclui o valor observado: contamos 6, 7, 8, 9 e 10.
Sob \(H_0:p=.5\),
\[ P(X\geq x_{obs}\mid H_0) = \sum_{k=x_{obs}}^{10}{10\choose k}(.5)^{10}. \]
Isso dá, num teste direccional para desempenho acima do acaso:
- 6 ou mais acertos: \(p=.377\);
- 7 ou mais: \(p=.172\);
- 8 ou mais: \(p=.055\);
- 9 ou mais: \(p=.011\);
- 10 em 10: \(p<.001\).
Reparem no que aconteceu. Não tivemos de saber quão boa a pessoa seria se tivesse uma capacidade real. Poderia acertar 60%, 70% ou 95% das vezes. Para esta pergunta, bastou especificar com precisão o que aconteceria se não houvesse capacidade nenhuma.
É esta a lógica de uma distribuição de referência. E a probabilidade que acabámos de calcular é um valor-p: sob o modelo nulo, qual é a probabilidade de obter um resultado tão extremo ou mais extremo do que aquele que observámos? No nosso exemplo de 6 acertos,
\[ p=P(X\geq 6\mid p=.5)=0.377. \]
Não há ainda nenhuma magia em .05. Primeiro construímos o mapa do que o processo aleatório especificado prevê e localizamos nele o resultado observado. Na secção sobre caudas e \(\alpha\) veremos como uma regra como \(\alpha=.05\) se relaciona com esta área.
Seis acertos em dez não são extraordinários sob este modelo de puro palpite: se o repetíssemos, cerca de 37.7% das séries teriam seis ou mais acertos. Este resultado não basta para concluir que a pessoa distingue o tom. Também não demonstra que seja incapaz de o ouvir, nem nos diz qual é a sua capacidade real ou se dez ensaios permitiriam detectá-la.
E se a pessoa tivesse acertado oito vezes? Observámos seis acertos; com oito, a lista acima mostra que oito ou mais ainda ocorreriam em cerca de 5.5% das séries sob o mesmo modelo. Precisamos da distribuição inteira para avaliar a discrepância, não apenas de comparar o número de acertos com cinco.
Em que sentido isto é evidência, e quando decidir? As três perguntas da moeda distinguem essas questões da capacidade de descobrir erros. Aqui continuamos pelo exemplo do dado, antes de passar de contagens a médias em Da Amostra à População. As notas seguintes aprofundam a história e a geração de números aleatórios; não são necessárias para acompanhar esses exemplos.
História e Aleatoriedade
Fisher tornou célebre esta pergunta com a experiência da senhora que provava chá. Ela afirmava conseguir distinguir se o leite ou o chá tinham sido servidos primeiro. Acertar uma vez não provaria grande coisa: mesmo alguém sem essa capacidade acertaria algumas vezes.
NotaA Experiência de Fisher Não Era Binomial
No delineamento original, Fisher apresentou oito chávenas, quatro preparadas de cada forma, e a participante sabia que havia quatro de cada tipo. A distribuição de referência é, por isso, combinatória: entre as 70 maneiras de escolher quatro chávenas em oito, apenas uma acerta nas quatro. Não são oito ensaios de Bernoulli independentes.
A versão 50/50 usada aqui conserva a pergunta pedagógica de Fisher, mas não pretende reproduzir o seu delineamento exacto.
NotaUm Antecedente do 50/50
Em 1710, John Arbuthnot usou uma ideia 50/50 para analisar 82 anos de registos de nascimentos em Londres. Em todos esses anos nasceram mais rapazes do que raparigas. No modelo que adoptou, qualquer dos sexos teria probabilidade .5 de ser o mais frequente num dado ano.
A unidade do argumento era o ano, não cada nascimento individual. O que nos interessa aqui é a estrutura estatística: definir um mecanismo de referência e perguntar quão extremo seria o padrão observado se esse mecanismo fosse adequado. A história mais completa fica na página de filosofia da estatística.
NotaDe Onde Vêm Números «Aleatórios»?
Nos computadores modernos, a estratégia não é tentar inventar por algoritmo algo «verdadeiramente aleatório». Recolhe-se primeiro entropia de fontes difíceis de prever e usa-se depois um gerador criptográfico determinístico para transformar esse estado imprevisível numa sequência longa de valores. Esta separação entre fontes de entropia e geradores determinísticos aparece explicitamente nas recomendações modernas do NIST (SP 800-90B; SP 800-90C, 2025).
A famosa parede de lâmpadas de lava da Cloudflare é um exemplo memorável: as imagens contribuem informação física difícil de prever para o sistema de entropia. Não são, por si só, «o algoritmo aleatório».
Em estatística computacional queremos muitas vezes precisamente o contrário da imprevisibilidade: reprodutibilidade. Em R, set.seed(2026) fixa o estado inicial do gerador pseudo-aleatório. O algoritmo produz uma sequência adequada à simulação, ao bootstrap ou à aleatorização, mas outra pessoa que use a mesma seed inteira pode reproduzir os mesmos resultados.
Para explorar o tema actual, vejam também o projecto de Random Bit Generation do NIST, que reúne normas e publicações recentes sobre fontes de entropia e geradores.
Depois: Outro Processo, Outra Distribuição
Agora mudemos o mecanismo sem mudar a lógica.
Imaginem que um casino tem razões, antes de observar esta sequência, para suspeitar que um dado foi adulterado para favorecer o número 6. Se o dado for justo, cada lançamento tem seis resultados equiprováveis e a probabilidade de sair 6 é
\[ P(6\mid H_0)=\frac{1}{6}. \]
Se contarmos apenas «saiu 6» versus «não saiu 6», cada lançamento continua a ser um ensaio de Bernoulli. Em 10 lançamentos, porém, a distribuição de referência é agora
\[ X \sim \operatorname{Binomial}(10,1/6). \]
Suponham que aparecem 5 seis em 10 lançamentos. Repetimos o raciocínio em quatro passos:
- Hipótese. O dado é justo, por isso cada lançamento tem probabilidade 1/6 de sair 6.
- Resultados tão extremos quanto o observado. Se o casino suspeita de um excesso de seis, interessam 5, 6, 7, 8, 9 ou 10 seis.
- Probabilidade de cada resultado. Com 10 lançamentos e \(p = 1/6\), a binomial dá a probabilidade de cada contagem. A tabela mostra os seis valores.
- Soma. O valor-p é a soma das probabilidades desses resultados.
| Seis | \(P(X = k)\) | \(P(X \geq k)\) |
|---|---|---|
| 5 | 0.01302 | 0.01546 |
| 6 | 0.002171 | 0.002438 |
| 7 | 0.0002481 | 0.0002675 |
| 8 | 1.861e-05 | 1.945e-05 |
| 9 | 8.269e-07 | 8.434e-07 |
| 10 | 1.654e-08 | 1.654e-08 |
Na tabela, \(k\) é o número de vezes que saiu 6. A segunda coluna dá a probabilidade de sair exactamente esse número de seis; a terceira soma essa linha e todas as seguintes. É por isso que, na linha de 5 seis, encontramos o valor-p do resultado observado:
\[ p=P(X\geq5\mid p=1/6)=0.015. \]
Um dado justo produziria cinco ou mais seis em cerca de 1.55% das séries de dez lançamentos independentes. É um resultado pouco frequente sob este modelo. Para concluir que houve batota, teríamos ainda de investigar como foram feitos os lançamentos. Comparemos agora as duas distribuições:
Nos dois casos contamos sucessos e usamos a mesma família binomial. O que muda é a definição de «sucesso» e a probabilidade que o delineamento ou o processo atribui a esse resultado sob \(H_0\). «Aleatório» não é uma distribuição. Precisamos de especificar o mecanismo.
NotaDas Contagens às Médias
E se, em vez de contarmos acertos, quisermos estudar uma média? A pergunta sobre o resultado observado mantém-se, mas precisamos de perceber como uma média varia entre amostras.
1 Da Amostra à População
Da População à Amostra
Mudemos agora de uma decisão binária para uma variável quantitativa. Partimos de uma população que não conseguimos observar por inteiro e recolhemos uma amostra. A inferência tenta fazer o caminho de regresso, da amostra para a população, sem esconder a incerteza dessa passagem.
A escala Love4Taylor varia de -5 a 5 e zero representa indiferença. A pergunta é: como podemos saber se, em média, as pessoas na população apreciam a música da Taylor Swift, se só observámos uma amostra?
Na nossa amostra, a média de Love4Taylor é 0.57. Isso descreve os participantes que observámos. Ainda não responde à pergunta sobre a população.
Se repetíssemos o estudo com outra amostra, obteríamos outra média. E outra. Mesmo que nada mudasse na população, as médias das amostras não seriam todas iguais.
É aqui que começa a inferência estatística. Não basta saber o valor da estimativa. Precisamos de saber quanto essa estimativa varia de amostra para amostra.
Distribuições: O Mapa da Inferência
Acabámos de usar uma distribuição para mapear exactamente os resultados possíveis sob o modelo aleatório de referência. Já usámos também distribuições para descrever dados: onde se concentram os valores, quanto variam e que forma têm. Agora precisamos de distinguir esses papéis.
Já conhecemos a diferença entre a distribuição dos dados observados e uma distribuição matemática de probabilidade. Na inferência, precisamos agora de distinguir mais duas ideias:
- Uma distribuição amostral mostra como uma estatística, por exemplo uma média, variaria se repetíssemos o processo de amostragem muitas vezes.
- Uma distribuição de referência mostra que valores uma estatística de teste poderia assumir sob uma hipótese e as restantes condições do modelo.
A binomial do exemplo anterior já era uma distribuição de referência: representava o que o número de acertos poderia fazer sob o modelo de puro palpite.
É essa mudança de papel que permite passar de «observámos esta média» para «quão surpreendente seria obter uma discrepância desta dimensão se \(H_0\) fosse verdadeira?».
A curva acima é apenas um lembrete visual. Na inferência, o objecto decisivo não é necessariamente a distribuição dos dados originais. Muitas vezes é a distribuição de uma estatística calculada sobre amostras possíveis.
O Teorema do Limite Central
Para a média, o Teorema do Limite Central dá-nos a ponte de que precisamos. Sob condições apropriadas, à medida que aumentamos o tamanho \(N\) de cada amostra, a distribuição das médias amostrais aproxima-se de uma distribuição normal. A população original não tem de ser normal e, em muitos casos, esta aproximação já é bastante boa para amostras relativamente pequenas.
O teorema descreve uma convergência, não um ponto de corte: a aproximação pode ser boa para valores finitos e relativamente pequenos de \(N\), mas a rapidez com que isso acontece depende da distribuição original.
Para observações independentes da mesma população, com média \(\mu\) e variância finita \(\sigma^2\),
\[ E(\bar X)=\mu, \qquad SD(\bar X)=\frac{\sigma}{\sqrt{N}}. \]
A dispersão dessa distribuição é o erro-padrão. Se conhecêssemos o desvio-padrão populacional,
\[ SE_{\bar X}=\frac{\sigma}{\sqrt{N}}. \]
Como normalmente não conhecemos \(\sigma\), usamos o desvio-padrão da amostra, \(s\), para o estimar:
\[ SE_{\bar X}\approx\frac{s}{\sqrt{N}}. \]
No nosso exemplo,
\[ SE_{\bar X} = \frac{1.1}{\sqrt{50}} = 0.155. \]
O desvio-padrão descreve a dispersão dos valores individuais; o erro-padrão descreve a variabilidade da média entre amostras.
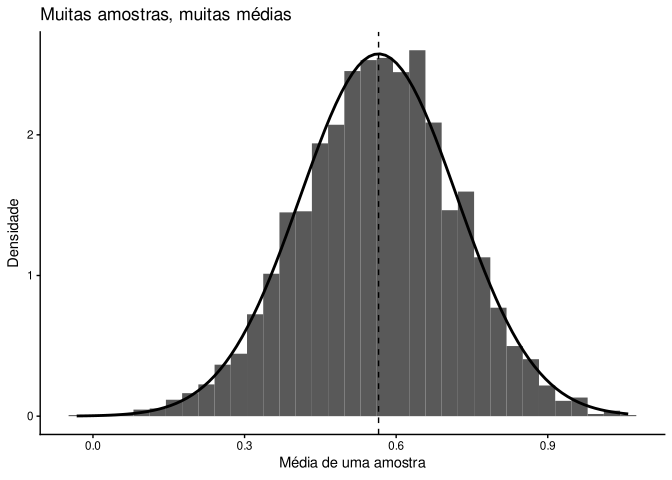
Para ilustrar a diferença, retiramos muitas amostras com reposição dos dados que temos e calculamos a média de cada uma. Este procedimento, chamado bootstrap, usa a amostra observada como uma população empírica. O histograma seguinte mostra a distribuição dessas médias.
A dispersão destas médias ilustra o que o erro-padrão mede.
A visualização da Universidade de British Columbia permite alterar a distribuição da população e o tamanho da amostra e observar directamente o que acontece às médias de muitas amostras.
Link directo para a demonstração do Teorema do Limite Central
AvisoO Que o CLT Não Nos Autoriza a Dizer
O CLT não transforma os dados originais numa distribuição normal e não existe um número mágico, como \(N=30\), a partir do qual todos os problemas desaparecem. A rapidez da aproximação depende da distribuição e do processo de amostragem; dependência, caudas muito pesadas e outras violações do modelo podem continuar a importar.
Nos modelos lineares, os resultados exactos sob erros normais e os resultados assintóticos fora desse caso exigem condições mais precisas do que «a amostra é grande». Voltaremos a isso no capítulo sobre pressupostos.
Do Erro-Padrão ao t
Agora já podemos perceber por que dividimos uma estimativa pelo seu erro-padrão.
Se a hipótese nula diz que a média populacional é zero, queremos saber a que distância a média observada está de zero na escala da variabilidade que esperamos para médias amostrais:
\[ t = \frac{\bar X-\mu_0}{SE_{\bar X}}. \]
Uma diferença de uma unidade pode ser enorme se estimamos a média com muita precisão e banal se a estimativa varia muito de amostra para amostra. O t exprime essa distância em unidades de erro-padrão. Quando \(\mu_0=0\), a fórmula abrevia-se para \(t=M/SE\); para outra referência, temos de a subtrair.
Dos Valores à Estatística
Antes de voltar à Taylor Swift, vejamos as contas com dez valores construídos para este exemplo, em unidades arbitrárias. Não são observações recolhidas nem uma amostra aleatória. \(M\) (ou \(\bar x\)) é a média; \(SD\) (ou \(s\)) é o desvio-padrão amostral e \(SE\) é a estimativa do erro-padrão. Testamos como referência \(\mu_0=0\).
Ver as contas dos dez valores
constructed_x <- -2:7
constructed_n <- length(constructed_x)
constructed_mu0 <- 0
constructed_m <- mean(constructed_x)
constructed_ss <- sum((constructed_x - constructed_m)^2)
constructed_sd <- sqrt(constructed_ss / (constructed_n - 1))
constructed_se <- constructed_sd / sqrt(constructed_n)
constructed_t <- (constructed_m - constructed_mu0) / constructed_se
constructed_df <- constructed_n - 1| Passo | Cálculo | Resultado |
|---|---|---|
| Valores individuais | -2, -1, 0, 1, 2, 3, 4, 5, 6, 7 | \(N=10\) |
| Média | \(M=25/10\) | \(2.5\) |
| Desvio-padrão | \(SD=\sqrt{82.5/9}\) | 3.028 |
| Erro-padrão estimado | \(SE=SD/\sqrt{10}\) | 0.957 |
| Estatística de teste | \(t=(M-0)/SE\) | 2.611 |
Primeiro calculamos a média. A soma dos quadrados dos desvios em relação a ela é 82.5; dividimos por \(N-1\) e tiramos a raiz quadrada para obter \(SD\). Depois dividimos \(SD\) por \(\sqrt N\) para estimar a variabilidade da média sob amostragem independente da mesma população, com variância finita. Finalmente, \(t\) diz-nos que a média ficou a cerca de 2.61 erros-padrão de zero. As contas usam valores não arredondados.
Muitas Amostras, Muitos Valores de t
De onde vem a curva com que vamos comparar um t? Agora geramos amostras aleatórias de uma população normal com média zero e desvio-padrão 3. Cada amostra contém dez observações independentes. Em cada uma, repetimos as contas: valores → \(M\) → \(SD\) → \(SE\) → \(t\).
Nos seis exemplos abaixo, cada ponto é uma observação. A linha tracejada marca a média amostral e a pontilhada marca zero, a média da população. Os resumos no título de cada painel foram calculados a partir dos pontos desse painel.
Ver as amostras e os cálculos
set.seed(20261006)
null_raw <- matrix(rnorm(constructed_n * 20000, mean = 0, sd = 3),
                   nrow = constructed_n)
null_summary <- data.frame(
  amostra = seq_len(ncol(null_raw)),
  M = colMeans(null_raw),
  SD = apply(null_raw, 2, sd)
)
null_summary$SE <- null_summary$SD / sqrt(constructed_n)
null_summary$t <- (null_summary$M - constructed_mu0) / null_summary$SE
visible_summary <- null_summary[1:6, ]
visible_summary$painel <- sprintf(
  "Amostra %d: M = %.2f; SD = %.2f\nSE = %.2f; t = %.2f",
  visible_summary$amostra, visible_summary$M, visible_summary$SD,
  visible_summary$SE, visible_summary$t
)
visible_summary$painel <- factor(visible_summary$painel,
                                 levels = visible_summary$painel)
visible_raw <- data.frame(
  observacao = rep(seq_len(constructed_n), 6),
  valor = as.vector(null_raw[, 1:6]),
  painel = rep(visible_summary$painel, each = constructed_n)
)
raw_samples_plot <- ggplot(visible_raw, aes(observacao, valor)) +
  geom_hline(yintercept = 0, linetype = "dotted", colour = "grey50") +
  geom_hline(data = visible_summary, aes(yintercept = M),
             linetype = "dashed", colour = "#0072B2") +
  geom_point(size = 2) +
  facet_wrap(~painel, ncol = 2) +
  scale_x_continuous(breaks = c(1, 5, 10)) +
  labs(x = "Observação dentro da amostra", y = "Valor individual") +
  theme_classic(base_size = 11)
raw_samples_plot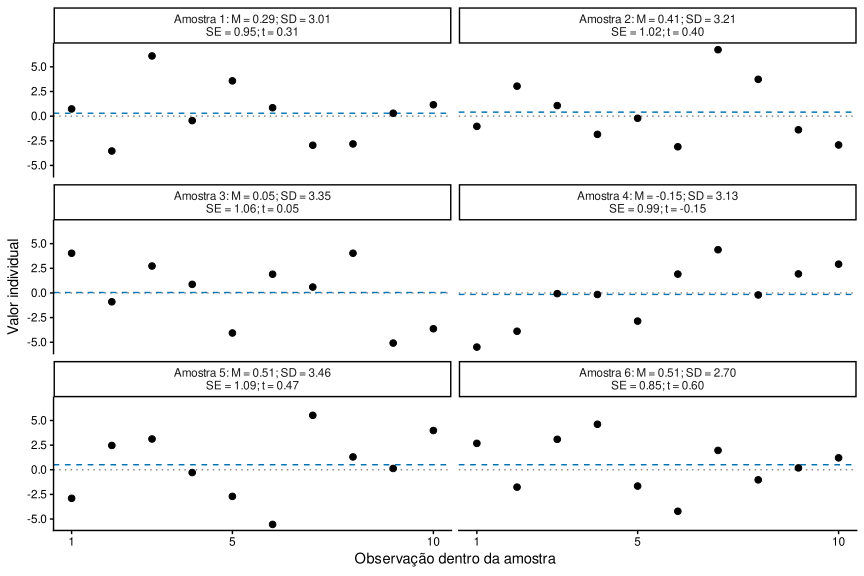
Uma estatística é uma função dos dados: mudam os pontos, muda o t. Juntando os valores de t calculados em 20000 amostras, obtemos este histograma. A linha azul é a densidade t com 9 graus de liberdade.
Ver o histograma dos valores calculados
sampled_t_plot <- ggplot(null_summary, aes(t)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = .15,
                 fill = "grey80", colour = "white") +
  stat_function(fun = dt, args = list(df = constructed_df),
                 colour = "#0072B2", linewidth = 1) +
  coord_cartesian(xlim = c(-5, 5)) +
  labs(x = "t calculado em cada amostra", y = "Densidade") +
  theme_classic()
sampled_t_plot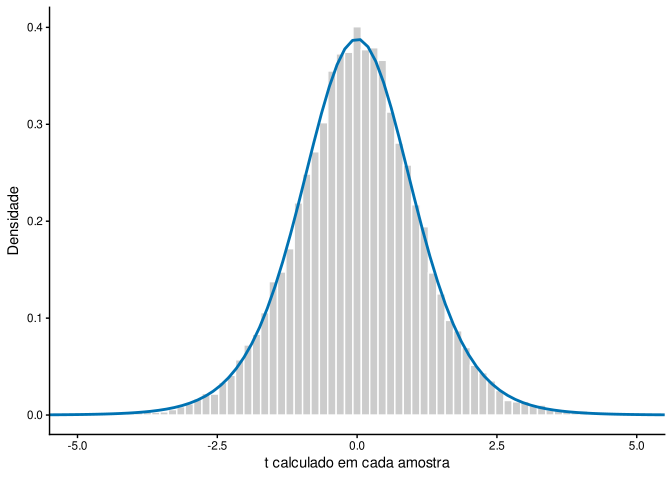
A curva não foi ajustada ao histograma. Sob este modelo normal e \(H_0\), a estatística segue exactamente uma distribuição t com \(N-1=9\) graus de liberdade (documentação do R, TDist, «Details»). A simulação aproxima essa distribuição por repetição: aumentámos o número de amostras, não o tamanho de cada uma. Isto é diferente do CLT, que descreve o que acontece quando aumenta o tamanho de cada amostra.
Voltar aos Dados
Retomemos agora as observações do ficheiro Love4Taylor, não os dez números construídos nem as amostras normais simuladas. Aplicamos a mesma conta:
\[ t=\frac{0.57-0}{0.155}=3.65. \]
A média observada está a cerca de 3.6 erros-padrão de zero. Para observações independentes da mesma população normal, a referência t é exacta sob \(H_0\). Uma escala limitada entre -5 e 5 não é literalmente normal: neste exemplo, usamos uma aproximação cuja adequação depende da distribuição e da amostragem. O teste não estabelece, por si só, que estes participantes representam todas as pessoas.
NotaStudent, Fisher e a Interpretação do t
A distribuição tem o nome de Student, pseudónimo de William Sealy Gosset. No artigo original, Student (1908) aplicou-a a dados de sono e transformou uma probabilidade acumulada de cerca de \(.9985\) em odds de aproximadamente 666 para 1 de que um tratamento fosse melhor. Zabell (2008) descreve a sua perspectiva inferencial inicial como bayesiana, e Senn e Richardson (1994) destacam a mesma interpretação.
Fisher reformulou a estatística para a forma moderna e popularizou uma leitura diferente das probabilidades de cauda: probabilidade do resultado sob um modelo, não probabilidade do parâmetro ou da hipótese à luz do resultado. Esta história ajuda a perceber por que não devemos projectar a definição moderna de valor-p para trás como se todos os autores estivessem a interpretar a mesma quantidade da mesma forma.
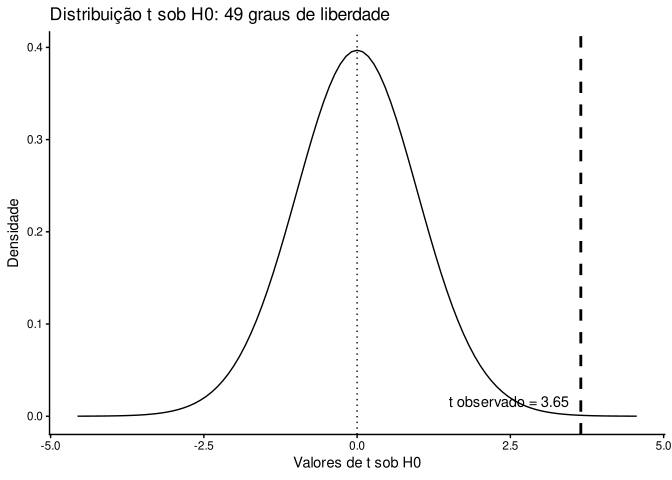
Antes de calcular qualquer área, vale a pena colocar a estatística observada na distribuição que lhe dá significado.
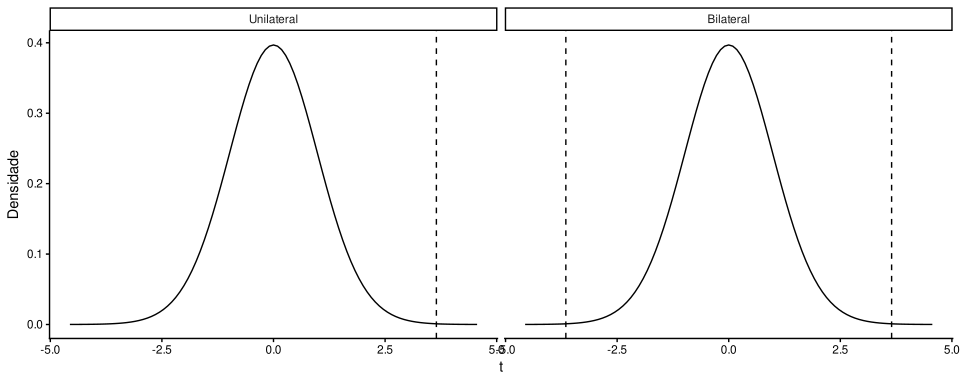
O zero está no centro porque, sob \(H_0\), não esperamos uma discrepância sistemática. O valor observado mostra onde os dados nos colocaram nessa distribuição de referência.
Pausa de Leitura
2 Valor-p: Área, Não Etiqueta
A lógica é a mesma que vimos no exemplo binomial: escolhemos os resultados que contam como tão ou mais extremos e calculamos a probabilidade que lhes corresponde. Na explicação geométrica das distribuições, vimos por que numa distribuição contínua essa probabilidade aparece como uma área. Agora a distribuição de referência é a distribuição t.
Imaginemos que a hipótese nula é verdadeira: a população é mesmo indiferente à Taylor Swift. Mesmo assim, amostras diferentes dariam valores de t diferentes. A distribuição t descreve quão frequentes seriam esses valores se repetíssemos o estudo sob \(H_0\) e se as restantes condições do modelo fossem satisfeitas.
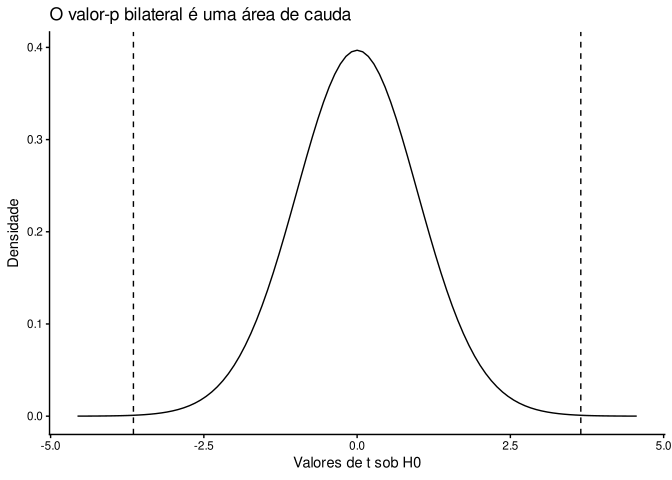
O nosso valor observado foi t = 3.65. Num teste bilateral, o valor-p é a área nas duas caudas correspondente a valores pelo menos tão extremos como esse:
\[ p=P\left(|T|\geq |t_{obs}|\mid H_0\right). \]
Nos nossos dados,
\[ p < .001. \]
Isto não é a probabilidade de \(H_0\) ser verdadeira. É uma pergunta condicional: se \(H_0\) fosse verdadeira, que proporção da distribuição de resultados possíveis seria tão extrema ou mais extrema do que o resultado que observámos?
A área é a ideia importante. O computador faz a integração por nós. Uma área pequena basta para testar bem a afirmação científica? A discussão do teste severo retoma essa pergunta; aqui falta ainda distinguir a área observada da regra de decisão.
NotaO Que o Computador Está a Calcular?
Não precisam de saber integrar para seguir esta página. Este bloco mostra o que uma tabela ou uma função como pt() nos poupa de fazer à mão.
No exemplo binomial conseguimos somar as probabilidades dos resultados que contam como «tão extremos ou mais extremos». Num teste bicaudal discreto é ainda preciso definir cuidadosamente essa regra; nem todos os testes exactos bicaudais se reduzem simplesmente a duplicar uma cauda.
Numa distribuição contínua, a soma dá lugar a uma área. Suponham que um teste produziu \(t=2.50\) com 9 graus de liberdade. A densidade t com \(\nu\) graus de liberdade é
\[ f_\nu(x)= \frac{\Gamma\left(\frac{\nu+1}{2}\right)} {\sqrt{\nu\pi}\,\Gamma\left(\frac{\nu}{2}\right)} \left(1+\frac{x^2}{\nu}\right)^{-\frac{\nu+1}{2}}. \]
Num teste bicaudal, o valor-p é a área das duas caudas para além de \(\pm2.50\):
\[ p =2\int_{2.50}^{\infty}f_9(x)\,dx \approx .03386. \]
A integral pede-nos que somemos fatias infinitamente estreitas da curva. Uma aproximação manual começaria por escolher um limite \(b\), dividir o intervalo em \(m\) partes de largura \(\Delta x=(b-2.50)/m\), calcular a altura da densidade em muitos pontos e somar rectângulos ou trapézios:
\[ \int_{2.50}^{b} f_9(x)\,dx \approx \sum_{i=1}^{m} f_9(x_i)\,\Delta x. \]
Seria ainda necessário levar \(b\) suficientemente longe para que a área restante fosse desprezável, repetir o cálculo na outra cauda e controlar o erro da aproximação. Além disso, cada altura exige avaliar potências e a função gama que normaliza a densidade. É possível fazer estas contas por aproximações e relações recorrentes, mas não é uma operação prática para repetir em cada teste.
É aqui que as tabelas históricas entram. Alguém fazia antecipadamente o trabalho matemático para vários graus de liberdade e imprimia quantis ou pontos críticos. O utilizador já não calculava a área: procurava a linha dos seus graus de liberdade e comparava a estatística observada com os valores da tabela.
Por exemplo, para 9 graus de liberdade, uma tabela de pontos críticos dá aproximadamente
\[ t_{P=.05}=2.262,\qquad t_{P=.02}=2.821. \]
Como \(2.262<2.50<2.821\), sem avaliar directamente a integral já podemos escrever
\[ .02<P<.05. \]
Hoje pt() avalia a função de distribuição t com algoritmos numéricos e devolve uma probabilidade muito mais precisa do que aquela leitura da tabela:
O exemplo binomial do início também cabe numa linha de R; para 9 ou mais acertos em 10 tentativas:
pbinom(8, size = 10, prob = .5, lower.tail = FALSE)
# 0.01074219
A tabela não muda a teoria. É outra camada de abstracção entre a área de probabilidade que queremos e a aritmética necessária para a obter.
3 Caudas e Regra de Decisão
A área depende da pergunta: contamos discrepâncias numa direcção ou nas duas? Depois de escolher as caudas, podemos distinguir a área observada da regra de decisão definida antes dos dados.
Testes Bilaterais e Unilaterais
Se resultados nas duas direcções são substantivamente possíveis, usamos por omissão um teste bilateral. Não é uma lei sem excepções. É uma escolha que mantém aberta a possibilidade de os dados nos contradizerem também na direcção oposta àquela que esperávamos.
Para o mesmo valor observado, a diferença no cálculo é simples. Um teste unilateral usa uma cauda; um teste bilateral conta resultados igualmente extremos nas duas direcções.
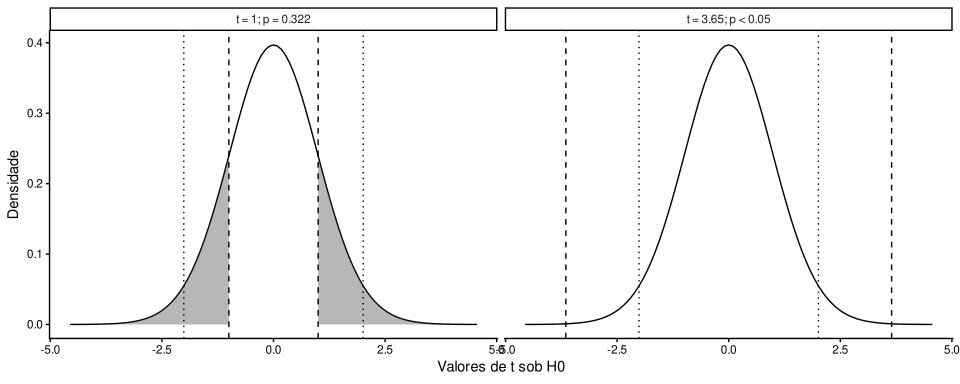
A diferença não é apenas «pôr ou tirar metade do valor-p». É uma diferença na pergunta que decidimos fazer.
O bilateral é uma boa escolha por omissão quando:
- ambas as direcções são possíveis em princípio;
- um efeito na direcção oposta seria cientificamente relevante;
- queremos que uma discrepância forte na direcção inesperada conte como evidência contra \(H_0\), em vez de desaparecer sob a etiqueta «não significativo na direcção prevista».
Um teste unilateral pode fazer sentido quando a pergunta é genuinamente direccional, essa direcção foi justificada antes de ver os dados e estamos dispostos a aceitar a consequência lógica: um resultado forte na direcção oposta não é tratado pelo teste da mesma maneira.
Esta lógica não pertence apenas ao teste t de uma média. A mesma decisão pode surgir para declives, contrastes e outros coeficientes. Por isso, não faz sentido tratar a unilateralidade como um privilégio natural de meia dúzia de testes de manual.
DicaDar aos Dados a Possibilidade de Nos Contradizer
Uma previsão direccional pode ser cientificamente interessante sem obrigar a um teste unilateral. Quando o efeito oposto também teria significado, o teste bilateral mantém essa possibilidade visível: os dados podem contrariar a expectativa na direcção que não antecipámos.
\(\alpha\) ≠ Valor-p
O nível \(\alpha\) é definido antes de observar o resultado como parte da regra de decisão. O valor-p é calculado depois de observar os dados.
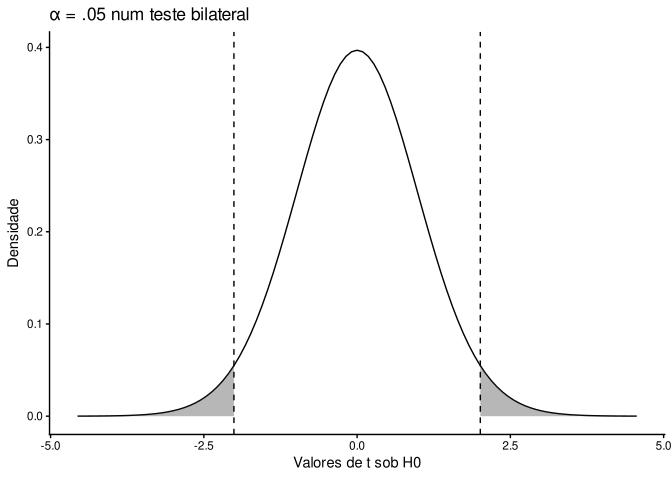
Com \(\alpha=.05\) num teste bilateral, dividimos essa probabilidade pelas duas caudas. Os valores críticos são
\[ \pm t_{1-\alpha/2,\,df} = \pm 2.01. \]
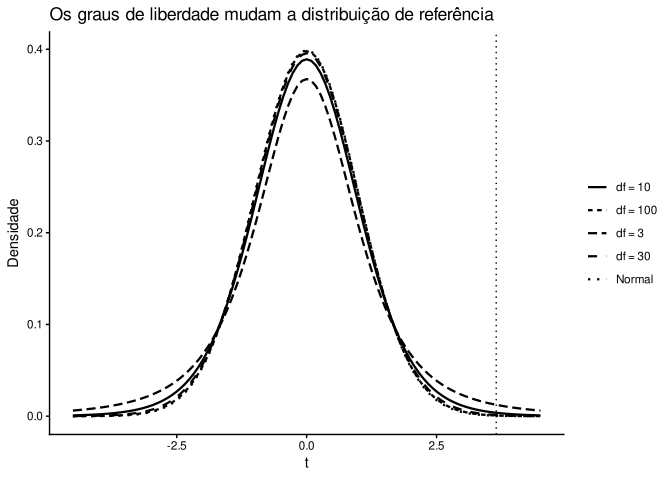
Este gráfico responde a «que resultados decidimos considerar suficientemente incompatíveis com \(H_0\)?». O gráfico do valor-p responde a uma pergunta diferente: «quão longe nas caudas ficou o resultado que realmente observámos?».
Dois Resultados Simulados
No exemplo da Taylor Swift, o valor de t é tão grande que quase não se vê a área das caudas. Vejamos dois resultados menos extremos, para comparar graficamente o valor-p com \(\alpha=.050\).
Simulamos duas amostras de 20 observações independentes de populações normais, ambas com desvio-padrão 1. Testamos \(H_0:\mu=0\) nas duas. A primeira população tem média zero e a segunda tem média 0.7. Escolhemos estas simulações para ilustrar um resultado não significativo e outro significativo; não esperamos que todas as amostras destas populações dêem as mesmas decisões.
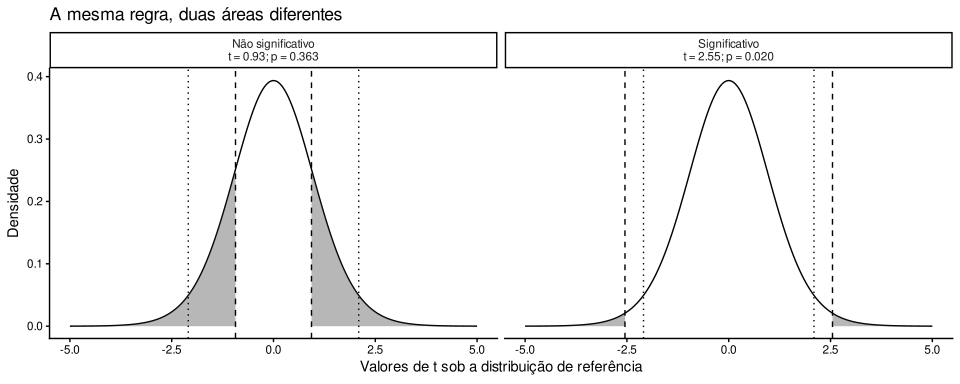
Com n = 20, os graus de liberdade são 19 e os valores críticos para α = .050 são ±2.093.
- No primeiro caso, \(t =\) 0.93 e \(p =\) 0.363. O valor-p é maior do que α, por isso não há evidência suficiente para rejeitar \(H_0\) a este nível. Isto não mostra que \(H_0\) é verdadeira.
- No segundo caso, \(t =\) 2.55 e \(p =\) 0.0196. O valor observado fica para além do valor crítico e o valor-p é menor do que α. Rejeitamos \(H_0\) a este nível, mas a decisão não diz qual é o tamanho do efeito.
Com os mesmos graus de liberdade, quanto maior for \(|t|\), menor será a área das duas caudas. Quando essa área é inferior a \(\alpha\), o valor observado fica para além de um dos valores críticos.
Erros e Poder
Já vimos como a regra se aplica a um resultado. E se repetíssemos o estudo quando existe uma diferença real? Para perceber que diferenças a regra conseguiria detectar, precisamos também da distribuição de t sob alternativas.
Consideremos um exemplo separado: um teste t bilateral de uma média, com \(N=30\) observações independentes da mesma população normal e \(\alpha=.05\). Testamos \(H_0:\mu=\mu_0\). Os limites críticos são aproximadamente \(\pm2.045\); rejeitamos \(H_0\) quando o t fica para lá de um deles.
No primeiro painel, \(H_0\) é verdadeira: a área cinzenta das duas caudas soma \(.05\) e corresponde ao erro de Tipo I. Nos outros dois painéis, a média populacional está acima da referência em 0.2 ou 0.8 desvios-padrão populacionais. São diferenças ilustrativas, expressas por \(d=(\mu-\mu_0)/\sigma\). Os limites mantêm-se; muda a distribuição dos resultados possíveis.
Ver os cálculos e as áreas
inference_power_examples <- power_t(c(0, .2, .8), n = 30, alpha = .05)
inference_power_critical <- inference_power_examples$critical[1]
power_panels <- c(
  "H0: d = 0; alfa = .050",
  sprintf("d = %.1f; beta = %.3f; poder = %.3f",
          inference_power_examples$d[-1], inference_power_examples$beta[-1],
          inference_power_examples$power[-1])
)
inference_power_curves <- do.call(rbind, lapply(1:3, function(i) {
  result <- inference_power_examples[i, ]
  t <- sort(unique(c(seq(-5, 9, length.out = 1401),
                     -result$critical, result$critical)))
  data.frame(t, density = dt(t, result$df, ncp = result$ncp),
             null_density = dt(t, result$df), painel = power_panels[i])
}))
inference_power_regions <- do.call(rbind, lapply(1:3, function(i) {
  result <- inference_power_examples[i, ]
  limits <- c(-5, -result$critical, result$critical, 9)
  do.call(rbind, lapply(1:3, function(piece) {
    t <- seq(limits[piece], limits[piece + 1], length.out = 400)
    region <- if (i == 1) {
      if (piece == 2) "Não rejeição sob H0" else "Alfa"
    } else {
      if (piece == 2) "Beta" else "Poder"
    }
    data.frame(t, density = dt(t, result$df, ncp = result$ncp),
               region, piece, painel = power_panels[i])
  }))
}))
inference_power_curves$painel <- factor(inference_power_curves$painel,
                                         levels = power_panels)
inference_power_regions$painel <- factor(inference_power_regions$painel,
                                          levels = power_panels)
inference_power_plot <- ggplot() +
  geom_area(data = subset(inference_power_regions,
                          region != "Não rejeição sob H0"),
            aes(t, density, fill = region, group = piece), alpha = .65) +
  geom_line(data = inference_power_curves,
            aes(t, null_density), linetype = "dashed", colour = "grey45") +
  geom_line(data = inference_power_curves, aes(t, density), linewidth = .8) +
  geom_vline(xintercept = c(-inference_power_critical, inference_power_critical),
             linetype = "dotdash") +
  facet_wrap(~painel, ncol = 1) +
  scale_fill_manual(values = c("Alfa" = "grey55", "Beta" = "#E69F00",
                               "Poder" = "#0072B2"), name = NULL) +
  coord_cartesian(xlim = c(-5, 9), ylim = c(0, .43), expand = FALSE) +
  labs(x = "Valor da estatística t", y = "Densidade") +
  theme_classic() +
  theme(legend.position = "bottom")
inference_power_plot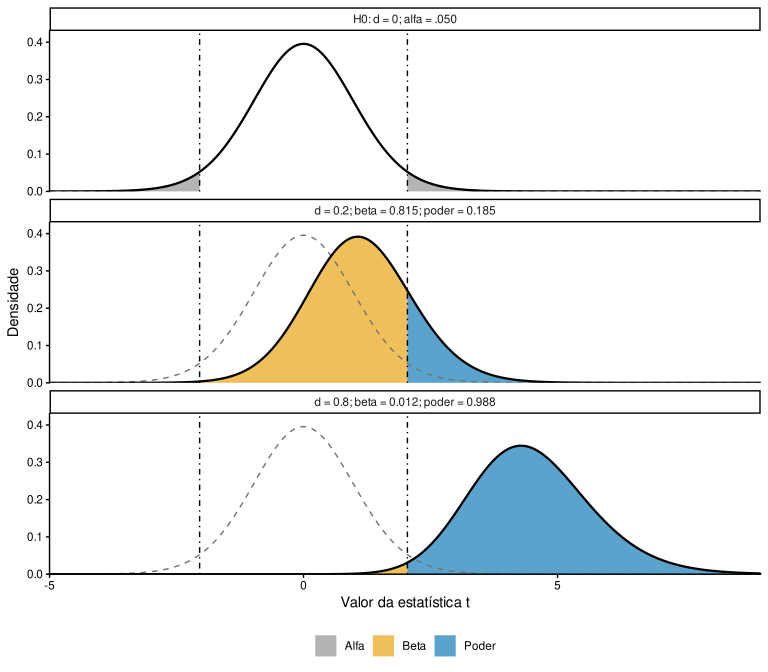
Nos painéis das alternativas, a curva tracejada conserva a referência nula; as cores estão sob a curva da alternativa. A área laranja é \(\beta\): a probabilidade de não rejeitar \(H_0\) apesar desta diferença, ou erro de Tipo II. O azul soma as duas caudas e é o poder, \(1-\beta\): a probabilidade de rejeitar \(H_0\) quando essa diferença existe. A cauda esquerda conta mesmo quando é demasiado pequena para se distinguir no gráfico.
Com esta regra, muitas diferenças de \(d=.2\) passam despercebidas; diferenças de \(d=.8\) são detectadas com muito maior frequência. Por isso, não rejeitar \(H_0\) não demonstra que a diferença é zero. E «80% de poder» exige dizer para que diferença, com que amostra e sob que modelo. Alterar o tamanho da amostra, a variabilidade ou o delineamento também pode alterar o poder.
NotaA Distribuição Sob a Alternativa
Neste modelo normal, a estatística segue uma t não-central com \(N-1\) graus de liberdade e não-centralidade \(d\sqrt N\). A documentação do R para TDist descreve esta relação. A curva muda de forma; não é simplesmente a curva nula deslocada. O auxiliar power_t() soma as probabilidades das duas caudas com pt(), usando os limites definidos sob \(H_0\). Os cálculos incluem as caudas até ao infinito, embora o gráfico mostre apenas o intervalo de -5 a 9.
Se calcularmos estas probabilidades para muitas diferenças, obtemos a curva de poder. A discussão em Filosofia da Estatística explica por que esta avaliação do procedimento não substitui a interpretação de um resultado concreto.
Pausa de Leitura
4 Incerteza e Graus de Liberdade
Usámos uma distribuição t com \(N-1\) graus de liberdade. Vejamos de onde vem esta restrição e por que altera a distribuição de referência.
O Que São Graus de Liberdade?
A expressão parece mais misteriosa do que a ideia básica. Pensemos primeiro na média. Se conhecemos \(N\), a média e \(N-1\) observações, a última observação já não é livre: fica determinada pelas restantes.
Por exemplo, suponham quatro valores com média 10. A soma tem de ser 40. Se já conhecemos três valores,
\[ 8,\quad 9,\quad 11,\quad ? \]
o quarto só pode ser 12. Em geral,
\[ x_N = N\bar{x} - \sum_{i=1}^{N-1}x_i. \]
Mas, se conhecermos apenas \(N-2\) valores, isso já não chega. Se soubermos apenas que os dois primeiros são 8 e 9, os dois restantes têm de somar 23, mas podem ser 11 e 12, 10 e 13, 9 e 14, e assim por diante. Há ainda mais do que uma maneira de completar os dados.
Essa é a intuição de graus de liberdade: quantas peças de informação podem variar independentemente depois de impormos as restrições criadas pelas quantidades que estimámos. Quando estimamos uma média a partir de \(N\) observações, usamos uma dessas peças de informação. Restam
\[ df=N-1. \]
A mesma ideia aparece nos desvios em relação à média. Eles têm de satisfazer
\[ \sum_{i=1}^{N}(x_i-\bar{x})=0, \]
por isso, depois de conhecermos \(N-1\) desvios, o último fica determinado.
NotaA Intuição Generaliza
Nos modelos lineares, a ideia reaparece de forma mais geral. Num modelo de posto completo com \(N\) observações e \(p\) parâmetros estimados, os graus de liberdade residuais são \(N-p\). No teste t de uma média estimamos um parâmetro, a média, e por isso ficamos com \(N-1\).
Graus de Liberdade e Distribuição t
A distribuição t não tem sempre a mesma forma porque estamos também a estimar a variabilidade a partir dos próprios dados. Com poucos graus de liberdade, essa estimativa é mais incerta e a distribuição tem caudas mais pesadas. À medida que os graus de liberdade aumentam, a estimativa estabiliza e a distribuição t aproxima-se da normal.
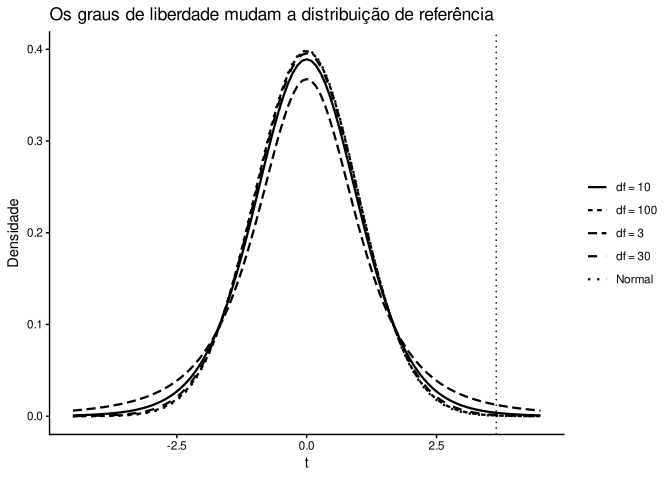
Assim, o mesmo valor de t pode corresponder a áreas de cauda diferentes quando muda a incerteza usada para construir a distribuição de referência. Os graus de liberdade não são decoração: fazem parte da ligação entre a estatística observada e o seu valor-p.
5 Interpretação e Generalização
Uma área de cauda responde a uma pergunta sob um modelo. Para passar dessa conta a uma conclusão científica, precisamos de examinar o que medimos, o delineamento e as explicações que o resultado ainda admite.
O Que o Valor-p Não É
O valor-p não é:
- \(P(H_0\mid D)\), a probabilidade de \(H_0\) ser verdadeira dados os dados;
- a dimensão do efeito;
- a importância prática ou científica do resultado;
- a probabilidade de o resultado «ter acontecido por acaso».
É uma área numa distribuição de referência construída sob \(H_0\). Para dizer algo sobre a dimensão e a relevância do efeito precisamos de olhar também para as estimativas, a sua incerteza e a pergunta científica.
Antes de Generalizar a Decisão
Voltemos à tarefa auditiva. Um número de acertos difícil de explicar pelo puro palpite dá-nos uma razão para investigar o que a pessoa consegue detectar. Mas o teste, por si só, não identifica o que a ajudou a acertar.
ImportanteO Valor-p Não Explica a Discrepância
Se os dados forem muito pouco compatíveis com o modelo nulo, aprendemos que alguma coisa nesse modelo não descreve bem o processo que gerou os dados. Isso não nos diz automaticamente qual é a explicação correcta.
Talvez exista realmente a capacidade que estávamos a testar. Mas também pode haver uma pista involuntária, dependência entre ensaios, uma falha no delineamento, um problema de medição ou outra explicação que produza a mesma discrepância. A estatística ajuda-nos a detectar que há algo a explicar. A ciência continua a exigir que comparemos explicações alternativas.
O Modelo Nulo Tem de Fazer Sentido
Uma distribuição de referência só é útil se aquilo que colocámos no modelo nulo fizer sentido para o processo e para o delineamento.
Imaginem que queremos comparar praias com orientações diferentes. Se amostrarmos muitas mais praias de uma orientação do que de outra e depois compararmos simplesmente o número total de indivíduos de uma espécie, ou o número total de espécies que encontrámos, criámos uma diferença de esforço amostral antes mesmo de olhar para qualquer efeito ecológico.
O problema não se resolve escolhendo mecanicamente \(H_0\) como «números iguais». Precisamos de tornar as quantidades comparáveis de uma forma adequada à pergunta. Para abundância, isso pode significar comparar por unidade de esforço, modelar cada praia como unidade de observação ou incluir explicitamente exposição/esforço no modelo. Para riqueza específica, simplesmente dividir o total de espécies pelo número de praias pode não chegar: quanto mais amostramos, maior é a probabilidade de encontrar espécies raras. Podemos precisar de esforço padronizado, riqueza por unidade de observação, rarefacção/curvas de acumulação ou um modelo que represente explicitamente o processo de amostragem.
A inferência começa, portanto, antes do valor-p: começa por perguntar qual seria uma comparação justa sob este delineamento?
Uma Inferência Deliberadamente Parcial
O teste não precisa de uma probabilidade a priori para a hipótese. Fixados os dados, o modelo e o procedimento, investigadores com crenças iniciais diferentes obtêm o mesmo valor-p. O conhecimento anterior continua a ser necessário para formular a pergunta, escolher o delineamento e a medição, construir o modelo e interpretar o resultado. Não entra no cálculo como uma probabilidade da hipótese.
Mayo (1997) chama a esta separação uma abordagem piecemeal da testagem: o teste responde a uma pergunta local no contexto de um modelo experimental. Justificar esse modelo e ligar a resposta a uma afirmação científica mais ampla são passos adicionais. Podemos reproduzir a conta sem herdar as crenças dos autores e, ainda assim, reinterpretar o resultado se descobrirmos problemas no delineamento, na medição ou no modelo de referência.
Na perspectiva de Mayo (2018), a afirmação precisa de passar um teste severo: os dados devem estar de acordo com ela e o procedimento teria, com elevada probabilidade, produzido um resultado menos favorável se ela estivesse errada de uma forma relevante. A Filosofia da Estatística desenvolve esta posição e distingue a avaliação do procedimento da avaliação de uma afirmação após observarmos os dados.
Aqui importa conservar a advertência prática: um valor-p pequeno não transforma uma experiência fraca em boa evidência. Probabilidades de erro, poder e avaliações formais de severidade ajudam, mas não dispensam verificar a aleatorização, a adequação das medições, dependências ignoradas, confundimento, selecção de resultados ou decisões analíticas tomadas depois de ver os dados. O delineamento pode tornar o resultado demasiado fácil de obter ou deixar abertas explicações alternativas. A severidade não se reduz a uma medida formal (Mayo, 2018).
Que erros poderia este estudo revelar? O Delineamento de Investigação ajuda a examinar essa pergunta antes de atribuir força probatória à conta. Usamos o conhecimento anterior para criticar o teste: se o resultado fosse fácil de obter mesmo com a explicação errada, aprenderíamos pouco.
O teste é local. A ciência à volta dele não é.
A Mesma Lógica Reaparece nos Modelos
No caso contínuo usámos uma média porque permite ver toda a mecânica sem demasiadas peças ao mesmo tempo. Mas a sequência não é específica de um teste t:
- definimos uma estimativa ou discrepância;
- medimos a sua incerteza;
- construímos uma estatística de teste;
- identificamos a distribuição de referência sob \(H_0\);
- localizamos a estatística observada nessa distribuição;
- calculamos uma área de cauda e, quando faz parte da regra escolhida, comparamo-la com \(\alpha\).
Nos capítulos seguintes aplicaremos este raciocínio a declives, contrastes, diferenças entre modelos e termos de interacção.
Para comparar duas condições, o delineamento decide como estimar a diferença e o seu erro-padrão:
- Unidades diferentes em cada condição: a secção Dois Grupos desenvolve a comparação entre médias de grupos independentes.
- As mesmas unidades nas duas condições: Duas Medições começa pelas diferenças dentro de cada unidade. O teste t emparelhado aplica a lógica de uma média a essas diferenças, preservando a ligação entre observações.
6 O Que Reter
Começámos por situações em que a distribuição de referência podia ser calculada exactamente. Isso deixou visível a ideia central antes de introduzir o CLT: especificamos o que esperaríamos sob um modelo nulo plausível e perguntamos quão extremo é o resultado observado nesse mapa de possibilidades. Esse modelo pode implicar \(p=.5\), \(p=1/6\) ou outra probabilidade qualquer. O valor tem de vir do processo e do delineamento, não de uma convenção.
A inferência acrescenta uma pergunta à descrição: quanto poderia variar a nossa estimativa se repetíssemos o processo que a produziu? A distribuição amostral representa essa repetição. O erro-padrão resume a variabilidade da estimativa. Uma estatística como t exprime a discrepância observada nessa escala. O valor-p é uma área numa distribuição de referência construída sob o modelo nulo.
Para interpretar o resultado, precisamos de acompanhar a cadeia completa, para além dos passos de cálculo de t e de p:
amostra → estimativa → erro-padrão → estatística de teste → distribuição de referência → área de cauda → decisão e interpretação.
Por omissão, usamos testes bilaterais quando ambas as direcções podem ensinar-nos alguma coisa. \(\alpha\) é uma regra definida antes de observar o resultado. O valor-p é a área determinada pela estatística que observámos. Nenhum deles substitui a estimativa do efeito ou o juízo científico sobre a sua importância.
Para regressão, ANOVA, ANCOVA e interacções, podemos continuar em Comparação de Modelos. Para regressar às diferenças entre Fisher, Neyman–Pearson, Bayesianismo e teste severo, podemos voltar a Filosofia da Estatística.