Filosofia da Estatística
Filosofia da Estatística
Introdução
Frequencismo
Bayesianismo
Filosofia da inferência estatística: probabilidade, valores-p, Fisher, Neyman–Pearson, Bayesianismo e teste severo, com uma perspectiva frequentista explícita.
0 Porque Precisamos de Filosofia da Estatística?
É possível aprender a calcular uma média, obter um valor-p ou ajustar um modelo sem perceber ainda muito bem que pergunta cada procedimento responde. Esta página começa precisamente aí.
A estatística não é apenas uma caixa de ferramentas matemática. Também envolve ideias sobre evidência, incerteza, erro, decisão e aprendizagem. Quando dizemos que um resultado é «significativo», que um intervalo é «preciso» ou que um estudo «não encontrou efeito», estamos a fazer afirmações que precisam de ser interpretadas. A filosofia da estatística ajuda-nos a perceber o que essas frases podem legitimamente querer dizer e onde começam os exageros.
O objectivo aqui não é escolher uma escola vencedora, nem fingir que as escolas são perfeitamente homogéneas. É aprender a reconhecer perguntas diferentes, a história das ferramentas que usamos e os compromissos filosóficos que tornam algumas respostas aceitáveis para uns autores e inaceitáveis para outros.
NotaA Perspectiva Deste Curso
Neste material, as análises que vamos aprender a fazer são frequentistas. Vamos explicar o Bayesianismo porque é uma alternativa inferencial importante e porque ajuda a perceber o que está em jogo quando interpretamos probabilidade, evidência e incerteza. Não vamos, porém, ensinar aqui a especificar priors, ajustar modelos bayesianos ou fazer inferência bayesiana no R.
A preferência é explícita. A tradição de error statistics desenvolvida por Deborah Mayo influencia fortemente esta página: interessa-nos sobretudo saber que discrepâncias um procedimento teria conseguido revelar e quão exigente foi o teste que uma afirmação conseguiu ultrapassar (Mayo, 2018). Uma distribuição posterior pode ser uma forma coerente de representar incerteza dentro de um modelo bayesiano, mas não responde automaticamente a esta pergunta sobre capacidade de detectar erro.
Isto não torna o teorema de Bayes «errado» nem os métodos bayesianos matematicamente inválidos. A divergência é filosófica e metodológica: que significado damos à probabilidade e que tipo de evidência queremos que um procedimento produza? Vamos apresentar a alternativa bayesiana seriamente, mas não fingir neutralidade sobre a abordagem que este curso desenvolve.
NotaUma Dívida Pedagógica
A selecção, a ordem e a forma de apresentar muitos destes temas devem muito, sobretudo, às aulas e discussões com Leonel Garcia-Marques, e também ao que aprendi com Mário Boto Ferreira, na FPUL. Dienes (2008) foi outra influência importante, sobretudo na forma de ligar filosofia da ciência e filosofia da inferência estatística à prática da Psicologia. A perspectiva de error statistics de Deborah Mayo é identificada separadamente acima porque influencia de forma substantiva a posição adoptada neste capítulo. A organização, exemplos e síntese desta página são meus e não pretendem reproduzir as posições de nenhuma destas fontes.
Não é preciso saber R para seguir esta página. A ideia é começar pelas perguntas e interpretações; a mecânica de amostragem, erro-padrão, t e áreas de cauda vem depois em Fundamentos da Inferência.
1 Antes das Tradições
Para Que Serve a Estatística?
Podemos usar estatística para várias tarefas diferentes:
- descrever dados;
- explorar padrões;
- estimar quantidades desconhecidas;
- prever novos casos;
- testar afirmações;
- comparar modelos;
- apoiar decisões sob incerteza.
Estas tarefas não são sinónimas. Um método bom para previsão pode não responder a uma pergunta causal. Um procedimento que controla uma taxa de erro pode não atribuir uma probabilidade à hipótese. Uma análise que estima um parâmetro pode ser informativa mesmo sem produzir uma decisão binária.
Um exemplo simples ajuda. Suponham que queremos estudar se dormir mais melhora a atenção. Podemos resumir os dados, estimar uma diferença, testar a compatibilidade com um modelo nulo, perguntar que diferenças o estudo teria capacidade para detectar, construir uma distribuição posterior, prever novos casos ou tomar uma decisão. São perguntas relacionadas, mas não são a mesma pergunta.
DicaUm Princípio Para Guardar
Antes de escolher uma técnica, escrevam em linguagem corrente: o que quero aprender com estes dados? Depois perguntem que procedimento responde a essa pergunta e que erros continua a permitir.
Descrever Não É Inferir
A estatística descritiva resume os dados que temos. Uma média, um desvio- padrão ou um gráfico podem condensar centenas de observações. Essa compressão é útil, mas perde informação.
A inferência estatística tenta ir além da descrição dos casos observados. Pode procurar aprender sobre uma população, uma discrepância, um parâmetro, um modelo ou uma previsão futura. É nesse salto para além dos dados imediatos que entram pressupostos, probabilidades de erro e diferentes interpretações da probabilidade.
Prever Não É Explicar
Um modelo pode prever sem identificar um mecanismo causal. Uma associação entre consumo de gelados e afogamentos pode ter utilidade preditiva em certas épocas do ano sem implicar que os gelados causem afogamentos. Temperatura e exposição a praias ou piscinas são explicações alternativas plausíveis.
Estatística Não Repara Maus Estudos
Nenhuma análise transforma uma amostra enviesada numa amostra representativa, uma medida fraca numa boa medida ou um delineamento confundido num experimento causal. Isto liga directamente esta página a Filosofia da Ciência: um teste estatístico é apenas uma parte de um pacote maior de hipóteses, medições, auxiliares e escolhas de delineamento.
Vocabulário Mínimo
DicaTermos Que Vamos Usar
- População: conjunto mais amplo sobre o qual queremos aprender.
- Amostra: casos efectivamente observados.
- Parâmetro: quantidade que descreve a população ou um modelo.
- Estimativa: valor calculado a partir da amostra para aprender sobre um parâmetro.
- Erro-padrão: medida da variabilidade esperada de uma estimativa entre amostras repetidas sob um modelo.
- Hipótese nula (\(H_0\)): modelo de referência usado num teste.
- Hipótese alternativa (\(H_1\)): hipótese ou família de alternativas que contrasta com \(H_0\); o seu papel formal é especialmente importante em Neyman–Pearson.
- Valor-p: probabilidade, calculada sob \(H_0\) e o procedimento definido, de obter uma estatística pelo menos tão extrema como a observada.
- \(\alpha\): taxa de erro de Tipo I especificada para uma regra de decisão.
- \(\beta\): probabilidade de não rejeitar \(H_0\) quando uma alternativa específica é verdadeira.
- Poder (\(1-\beta\)): probabilidade de rejeitar \(H_0\) quando essa alternativa é verdadeira.
- Sensibilidade: capacidade do procedimento para revelar discrepâncias de determinada magnitude.
- Prior: distribuição usada para representar informação, compromisso ou incerteza antes dos dados numa análise bayesiana.
- Verosimilhança (likelihood): função que compara quão bem diferentes valores de parâmetros tornam os dados observados compatíveis com o modelo.
- Posterior: distribuição resultante da combinação do prior com o modelo para os dados.
- Factor de Bayes (Bayes factor): razão entre probabilidades marginais dos dados sob dois modelos.
Provavelmente Isto É Complicado
As pessoas mostram padrões previsíveis de erro em alguns problemas de probabilidade (Tversky & Kahneman, 1974), mas estes efeitos dependem muito da tarefa e da forma como a informação é apresentada (Gigerenzer & Hoffrage, 1995; McDowell & Jacobs, 2017; Szollosi & Newell, 2020).
NotaUm Exemplo Para Levar Connosco
Imaginem 1000 pessoas. Dez têm uma doença. Um teste identifica 9 dessas 10, mas também dá positivo em 50 pessoas sem a doença. Entre as 59 pessoas com teste positivo, apenas 9 têm a doença.
A pergunta «qual é a probabilidade de um teste positivo se a pessoa estiver doente?» não é a mesma que «qual é a probabilidade de doença se o teste for positivo?». Qual é o grupo em que estamos a condicionar?
Um Pequeno Catálogo de Intuições Perigosas
Trocar a condicional. As pessoas confundem por vezes \(P(A\mid B)\) com \(P(B\mid A)\); a prosecutor’s fallacy é um exemplo aplicado deste erro (Thompson & Schumann, 1987). Mais à frente veremos a mesma confusão quando um valor-p é lido como \(P(H_0\mid D)\).
Subvalorizar taxas de base. Este padrão aparece repetidamente (Tversky & Kahneman, 1974), mas o formato importa: frequências naturais melhoram substancialmente o raciocínio bayesiano (Gigerenzer & Hoffrage, 1995; McDowell & Jacobs, 2017), e há bastante heterogeneidade entre pessoas e problemas (Stengård et al., 2022).
Julgar uma conjunção mais provável do que uma das suas partes. Isto viola \(P(A\cap B)\leq P(A)\) e foi observado no conhecido problema de Linda (Tversky & Kahneman, 1983), embora a magnitude e a generalidade do efeito dependam da formulação e da tarefa (Mellers et al., 2001; Chandrashekar et al., 2021).
Esperar demasiado de amostras pequenas. As pessoas podem esperar que amostras pequenas reproduzam demasiado fielmente a população (Tversky & Kahneman, 1971), mas esta tendência não é universal (Bar-Hillel, 1979).
Esperar que o acaso se «compense». Depois de uma sequência, muitas pessoas tendem a prever o resultado oposto (Farmer et al., 2017), mas isso não implica necessariamente que atribuam probabilidades erradas ao próximo resultado (Xiang et al., 2025).
Tratar duas possibilidades como 50/50. «Ou acontece ou não acontece» não implica probabilidades iguais. Esta dificuldade aparece em estudos de concepções de probabilidade (Morsanyi et al., 2009).
Confundir independência com exclusão mútua. É uma dificuldade conceptual frequente entre estudantes (D’Amelio, 2009).
Confundir facilidade de recordação com frequência. A disponibilidade de exemplos pode influenciar julgamentos (Tversky & Kahneman, 1973), mas a dimensão do efeito depende do paradigma e de vários moderadores (Weingarten & Hutchinson, 2018).
Estranhar a lei dos grandes números. As proporções podem convergir mesmo quando a diferença absoluta entre resultados cresce (Falk, 2015). Aqui trata-se sobretudo de uma consequência matemática contra-intuitiva, não de um «viés» psicológico.
O importante não é decorar nomes de vieses. É perguntar qual é exactamente a probabilidade em causa, em que informação estamos a condicionar e até que ponto a formulação do problema altera o raciocínio.
Interpretações de Probabilidade
Há ainda uma dificuldade mais funda: mesmo depois de concordarmos com as regras matemáticas do cálculo de probabilidades, podemos discordar sobre o que uma probabilidade significa.
A axiomatização moderna, associada a Kolmogorov, diz-nos como uma medida de probabilidade se deve comportar matematicamente. Isso não resolve, por si só, a questão filosófica «o que é a probabilidade?». Entre as interpretações mais importantes encontramos:
- a clássica, associada a casos favoráveis sobre casos possíveis quando as possibilidades são tratadas como equiprováveis;
- interpretações lógicas ou evidenciais, que procuram representar relações de suporte entre evidência e proposições;
- interpretações frequentistas, que ligam probabilidade a frequências em repetições relevantes;
- interpretações de propensão, que tratam a probabilidade como uma tendência ou disposição física de um processo;
- interpretações subjectivas ou personalistas, centrais em parte da tradição bayesiana, que representam graus de crença ou confiança coerentes.
As fronteiras não são perfeitas, e «Bayesianismo» também não é sinónimo de uma única interpretação subjectivista. A Wikipedia tem um mapa introdutório útil destas interpretações, e a Stanford Encyclopedia of Philosophy desenvolve as diferenças com muito mais profundidade.
Se o navegador impedir a incorporação, abra directamente Probability interpretations — Wikipedia.
Para o nosso percurso não precisamos de resolver a filosofia da probabilidade antes de continuar. Precisamos apenas de reconhecer que a mesma notação \(P(\cdot)\) pode receber interpretações filosóficas diferentes.
Esta ordem é pedagógica, não uma cronologia da estatística. Bayes e Laplace são anteriores a Fisher, Neyman e Pearson. Vamos, porém, começar pela tradição clássica de testes porque ela permite perceber por que razão Fisher e Neyman–Pearson, embora hoje apareçam frequentemente misturados, não estavam a propor a mesma coisa. Só depois voltamos ao Bayesianismo como alternativa inferencial completa.
O Que Pergunta um Valor-p?
Antes de sabermos calcular um valor-p, já podemos perceber a pergunta que ele faz. Escolhemos uma estatística que mede uma discrepância relevante e perguntamos:
$ p=P(H_0, ). $
A direcção da condicional é a parte filosófica essencial. O valor-p não é \(P(H_0\mid D)\): não é a probabilidade de a hipótese nula ser verdadeira depois de vermos os dados. Também não é, por si só, a probabilidade de o resultado «ter acontecido por acaso».
Em Fisher, valores-p pequenos podem funcionar como indicação de incompatibilidade entre os dados e um modelo de referência. Em Neyman–Pearson, a lógica central é antes o comportamento de uma regra de decisão ao longo de repetições, com taxas de erro definidas antes dos dados. A estatística que hoje se ensina como «NHST» mistura frequentemente estas duas tradições.
Só depois desta distinção vale a pena abrir a caixa matemática. Em Fundamentos da Inferência veremos de onde vem a área de cauda: variabilidade amostral → erro-padrão → estatística t → distribuição nula → valor-p.
2 Tradições da Inferência
Fisher, Neyman, Pearson e o Erro
Esta é a parte em que muitos manuais comprimem demasiado a história. «Fisher» e «Neyman–Pearson» não são apenas dois nomes para duas versões da mesma receita, mas também não são blocos eternamente incompatíveis em todos os pontos.
Fisher: Significância Como Evidência
Fisher popularizou testes de significância para investigadores experimentais em Statistical Methods for Research Workers (Fisher, 1925). O valor \(P\) permitia perguntar quão surpreendente seria um resultado pelo menos tão discrepante como o observado se o modelo nulo fosse adequado.
Há aqui uma ideia extremamente económica. Muitas vezes é difícil especificar, com detalhe suficiente para gerar uma distribuição de dados, como seria o mundo se a nossa explicação substantiva estivesse certa. Em contraste, pode ser muito mais fácil especificar uma fonte de variação aleatória e perguntar: como seriam os dados se houvesse apenas esse processo de referência?
É esse o trabalho de \(H_0\). Não precisa de ser uma descrição completa do mundo. Funciona como um modelo deliberadamente restrito contra o qual conseguimos deduzir uma distribuição de resultados possíveis. Fisher sublinhava precisamente a importância de conhecer a distribuição amostral das estatísticas sob uma especificação hipotética e usar essa distribuição para testar se os dados estão em harmonia com ela (Fisher, 1925, cap. I).
ImportanteA Economia da Ideia de Fisher
Para testar uma explicação não precisamos sempre de conseguir modelar, de imediato, tudo o que esperamos ver se estivermos certos. Podemos começar por uma pergunta mais austera:
Se só estivesse a operar este modelo de referência, quão estranho seria o que observámos?
Isso transforma um problema científico potencialmente muito rico numa pergunta probabilística que conseguimos calcular. O preço é igualmente importante: rejeitar \(H_0\) diz que o modelo de referência não chega para explicar o resultado; não identifica automaticamente qual das muitas alternativas é a explicação correcta.
De Onde Vieram .05 e .01?
Os valores \(.05\) e \(.01\) não apareceram por uma única razão. Tornaram-se convencionais por uma sequência de escolhas históricas que se reforçaram umas às outras. Há também uma distinção de linguagem importante: Fisher discutia valores \(P\) e níveis de significância; \(\alpha\) como taxa de erro escolhida antes dos dados pertence à teoria de Neyman–Pearson. Por isso, quando hoje falamos informalmente da história de «\(\alpha=.05\)», estamos a juntar tradições que originalmente não eram idênticas.
Os principais passos foram estes:
- Já existia uma regra aproximada antes de Fisher. No início do século XX, resultados eram avaliados através de múltiplos do chamado erro provável. A tradição de tratar desvios próximos de dois desvios-padrão como especialmente notáveis antecede Statistical Methods for Research Workers (Cowles & Davis, 1982).
- Fisher deu a 5% uma formulação explícita e muito influente. Em 1925 observou que \(P=.05\) corresponde a cerca de 1.96 desvios-padrão e apresentou esse ponto como um limite conveniente para julgar significância (Fisher, 1925, cap. III). Noutro capítulo descreveu a regra de duas vezes o erro-padrão, aproximadamente equivalente a \(P=.05\), como uma convenção prática (Fisher, 1925, cap. V).
- O próprio Fisher admitia outros níveis. Em 1926 referiu explicitamente 2% e 1% como alternativas mais exigentes, embora dissesse preferir 5% como padrão baixo de significância (Fisher, 1926). Isto ajuda a explicar por que \(.05\) e \(.01\) ficaram associados como referências de exigência diferente, em vez de 5% surgir como uma constante científica especial.
- As tabelas favoreceram um pequeno conjunto de valores fáceis de consultar. Na tabela de \(\chi^2\), Fisher escolheu valores específicos de \(P\) e imprimiu os valores críticos correspondentes, em vez de tentar tabular todas as probabilidades possíveis (Fisher, 1925, cap. IV). Para a distribuição de \(z\), a primeira edição oferece uma pequena tabela para \(P=.05\) e observa que acrescentar \(P=.01\) provavelmente cobriria as necessidades correntes (Fisher, 1925, cap. I). Quando calcular probabilidades exactas à mão era trabalhoso, consultar valores críticos impressos tornava estes pontos especialmente fáceis de reutilizar.
- Neyman e Egon S. Pearson deram aos níveis escolhidos um papel diferente. Na sua teoria de testes, uma taxa \(\alpha\) é fixada antes dos dados como probabilidade de erro de Tipo I da regra de decisão. Isso ajudou a transformar níveis de significância familiares em limiares operacionais para procedimentos repetidos (Neyman & Pearson, 1933a).
- A repetição consolidou a convenção. Tabelas, manuais, ensino e prática aplicada difundiram os mesmos poucos níveis por várias disciplinas. Kennedy-Shaffer (2019) mostra como esta história de refinamento, difusão e combinação de tradições contribuiu para que \(p<.05\) acabasse tratado como padrão geral, muitas vezes sem a justificação histórica que lhe deu origem (Kennedy-Shaffer, 2019).
Assim, \(.05\) e \(.01\) tornaram-se padrões por continuidade com convenções anteriores, preferência e divulgação por Fisher, conveniência de tabulação, formalização posterior de regras com \(\alpha\) e repetição institucional. Esta genealogia explica por que estes números ficaram tão comuns; não fornece, por si só, uma justificação para os escolher num estudo novo.
O Que as Tabelas Faziam na Prática
Uma tabela de valores críticos podia localizar um resultado num intervalo sem obrigar a calcular a probabilidade exacta. No capítulo de \(\chi^2\), por exemplo, Fisher explica que, para uso prático, a primeira necessidade era perceber se o resultado merecia suspeita e destaca vários pontos de referência, incluindo \(.05\) (Fisher, 1925, cap. IV). Isso é compatível com tratar valores \(P\) menores como discrepâncias mais fortes: a tabela podia dizer, por exemplo, que \(.02<P<.05\), mesmo sem produzir imediatamente um valor exacto.
Para a mecânica do valor-p — incluindo um exemplo binomial exacto, a área sob uma distribuição t e o papel histórico das tabelas — vejam Fundamentos da Inferência.
Fisher também não tratou 5% como um nível universal para toda a investigação. Na obra posterior insistiu que o investigador devia considerar cada caso à luz da evidência e do problema científico, e criticou a transformação dos testes de significância em regras automáticas de aceitação ou rejeição (Fisher, 1955; Kennedy-Shaffer, 2019).
NotaFisher Era ‘Quase Bayesiano’?
Algumas partes da obra tardia de Fisher, sobretudo a inferência fiducial, podem produzir distribuições que se parecem com posteriors. Mas isso não transforma o valor-p numa probabilidade posterior nem faz de Fisher um bayesiano encoberto. A fiducial foi proposta precisamente como alternativa a introduzir um prior. É melhor dizer que algumas construções fiduciais são formalmente parecidas com construções bayesianas do que reinterpretar a obra de Fisher retrospectivamente.
Neyman–Pearson: \(H_1\), Erro e Poder
Jerzy Neyman e Egon Sharpe Pearson desenvolveram em colaboração uma teoria diferente de testes estatísticos. Os artigos de 1928 já desenvolvem o papel de alternativas e critérios de teste (Neyman & Pearson, 1928a; 1928b). O artigo clássico de 1933 formaliza o problema de escolher testes eficientes quando \(H_0\) compete com alternativas e torna centrais as probabilidades de erro (Neyman & Pearson, 1933a).
A mudança conceptual é importante:
- em Fisher, \(H_0\) funciona sobretudo como modelo de referência contra o qual avaliamos a discrepância observada;
- em Neyman–Pearson, precisamos de alternativas para avaliar que testes distinguem melhor situações relevantes;
- \(\alpha\) controla a frequência de rejeitar \(H_0\) quando \(H_0\) é verdadeira;
- \(\beta\) depende do valor verdadeiro considerado sob a alternativa;
- o poder, \(1-\beta\), também depende desse valor.
Isto corrige uma maneira muito comum de falar. Um estudo não tem simplesmente «80% de poder para detectar um efeito». O poder é uma função dos valores que poderiam ser verdadeiros:
$ () = P_( H_0). $
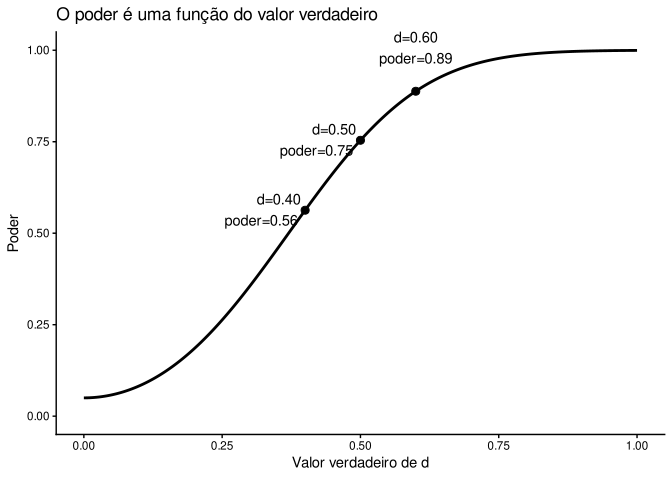
Ou seja: o poder é uma curva. Para cada valor possível de \(\theta\) existe uma probabilidade diferente de rejeitar \(H_0\). O que habitualmente aparece num artigo, numa análise de poder ou num cálculo de tamanho amostral é apenas um ponto dessa curva.
Quando dizemos «80% de poder», estamos normalmente a omitir a continuação da frase: 80% de poder se o verdadeiro parâmetro for este valor específico, mantendo também fixas as restantes suposições do cálculo. A linguagem corrente transforma assim uma função inteira num único número e pode dar a impressão errada de que «o poder» é uma propriedade fixa do estudo.
Por exemplo, dizer que planeámos um estudo para detectar um «efeito médio» não faz desaparecer esta dependência. Se «médio» significar, por convenção, \(d=0.50\), então o cálculo está a avaliar o procedimento no ponto \(d=0.50\). Se o verdadeiro efeito for \(d=0.20\), o poder é outro; se for \(d=0.80\), é outro. O rótulo pequeno/médio/grande apenas esconde temporariamente o valor numérico que entrou no cálculo.
Mesmo perto do ponto convencional \(d=.50\), a diferença pode ser substantiva. A figura seguinte usa apenas um exemplo ilustrativo: teste t bilateral de uma amostra, \(N=30\), \(\alpha=.05\). A faixa \(d=.40\)–\(.60\) não é uma definição formal de «médio»; serve apenas para mostrar que uma etiqueta de T-shirt pode esconder valores com poderes bastante diferentes.
Neste desenho fixo, o poder passa aproximadamente de 0.56 em \(d=.40\) para 0.89 em \(d=.60\). A mensagem necessária aqui é apenas esta: «80% de poder» é um ponto numa curva, não uma propriedade única do estudo.
Neyman–Pearson estudam tanto alternativas simples como problemas mais gerais com alternativas compostas. Por isso, é mais rigoroso dizer que o poder é avaliado ponto a ponto ao longo de \(H_1\) do que dizer que \(H_1\) tem necessariamente de ser uma hipótese pontual. Mas qualquer número de poder isolado corresponde sempre a algum ponto — ou conjunto de pressupostos muito específico — dessa função.
NotaPorque o Poder É Mais Exigente
Sob \(H_0\), muitas vezes conseguimos especificar um modelo de referência simples: por exemplo, diferença zero mais variabilidade aleatória. Para calcular poder, temos de perguntar também como seria a distribuição dos dados se um valor alternativo concreto fosse verdadeiro.
É aqui que a teoria de Neyman–Pearson mostra a dificuldade que Fisher podia evitar num teste de significância puro. Não basta modelar o ruído sob o nulo. Precisamos de especificar uma alternativa, a dimensão do efeito, o tamanho amostral, a variabilidade e as restantes condições relevantes. Só então podemos calcular a probabilidade de a regra rejeitar \(H_0\) nesse mundo alternativo.
A contribuição de Pearson não deve desaparecer dentro da abreviatura «Neyman». A teoria nasceu de uma colaboração intelectual documentada nos artigos conjuntos e na reconstrução histórica de Lehmann (2011). Neyman e Pearson (1933b) discutiram até a relação dos seus testes com probabilidades a priori, o que por si só mostra como a história é mais rica do que slogans posteriores.
A Guerra Não Foi Só Intelectual
Fisher e Neyman tinham desacordos metodológicos reais. Mas a história também é uma história de pessoas. Lehmann (2011) descreve uma relação que se tornou profundamente hostil. A própria história institucional da UCL regista que a animosidade entre Fisher e Neyman criava fricção entre departamentos instalados no mesmo edifício.
A ruptura agravou-se em torno da controvérsia de 1935 sobre delineamentos experimentais. Sabbaghi e Rubin (2014) mostram que o episódio envolvia questões técnicas reais, erros e mal-entendidos. Mayo usa esta história para argumentar que parte da imagem de duas filosofias absolutamente incompatíveis foi amplificada pelo conflito pessoal e pela retórica da disputa (Mayo, 2018, Tour III).
Isto não prova que as diferenças eram apenas pessoais. O ponto é mais modesto: devemos distinguir diferenças técnicas reais da forma particularmente adversarial como foram apresentadas.
O Desacordo de 1955–1956
Fisher (1955) critica «repeated sampling», erros de segundo tipo e «inductive behaviour». E. S. Pearson (1955) responde a Fisher. Neyman (1956) defende a necessidade de considerar alternativas e os dois tipos de erro.
Esta sequência é pedagogicamente valiosa porque mostra que «Fisher versus Neyman–Pearson» não foi uma distinção inventada retrospectivamente. Eles discordaram de facto, mas discutiram problemas comuns com objectivos e vocabulários parcialmente diferentes.
NHST Como Quimera?
Uma crítica influente diz que a prática moderna de NHST junta o valor-p evidencial de Fisher ao \(\alpha\) e à regra de decisão de Neyman–Pearson apesar de estes conceitos nascerem em programas diferentes (Hubbard & Bayarri, 2003). Perezgonzalez (2014) apresenta uma reconstrução semelhante.
A crítica é útil quando impede confusões: valor-p observado e \(\alpha\) não são a mesma coisa. Mas dizer apenas «é uma quimera incoerente» também pode ocultar demasiado. Berger (2003) mostra zonas de aproximação entre escolas. Mais à frente veremos uma tentativa particularmente interessante de reorganizar elementos das duas tradições: a abordagem de error statistics de Deborah Mayo.
A lição, por enquanto, não é «misturem tudo». É: saibam que conceito estão a usar, em que momento e para responder a que pergunta.
NotaPara Ler / Explorar a História
- Student (1908), The Probable Error of a Mean.
- Fisher (1925), Statistical Methods for Research Workers.
- Fisher (1926), The Arrangement of Field Experiments.
- Cowles & Davis (1982), On the Origins of the .05 Level of Statistical Significance.
- Kennedy-Shaffer (2019), Before p < 0.05 to Beyond p < 0.05.
- Neyman & Pearson (1928a) e 1928b.
- Neyman & Pearson (1933a), On the Problem of the Most Efficient Tests of Statistical Hypotheses.
- Neyman & Pearson (1933b), probabilidades a priori.
- Fisher (1955), Pearson (1955) e Neyman (1956).
- Lehmann (2011), Fisher, Neyman, and the Creation of Classical Statistics.
- Sabbaghi & Rubin (2014).
- Mayo (2018), Deconstructing the N-P versus Fisher Debates.
Bayesianismo, Priors e Factores de Bayes
Temos agora condições para perceber por que razão o Bayesianismo não é apenas «outra maneira de calcular significância». Parte de uma interpretação diferente daquilo que uma probabilidade pode representar e permite formular directamente perguntas que Fisher ou Neyman–Pearson não formulam da mesma maneira.
Numa análise bayesiana, combinamos um modelo para os dados com um prior para obter uma distribuição posterior:
\[ P(H \mid E)=\frac{P(E\mid H)P(H)}{P(E)}. \]
O teorema é matemática. O debate filosófico começa quando interpretamos \(P(H)\) e \(P(H\mid E)\) como probabilidades de uma hipótese ou de um valor de um parâmetro.
Porque Não a Usamos
A nossa objecção não é ao teorema de Bayes. É à passagem filosófica que permite interpretar uma distribuição posterior como probabilidade de hipóteses ou valores de parâmetros e, sobretudo, à ideia de que essa probabilidade responde por si só à pergunta evidencial que nos interessa.
Na perspectiva de error statistics de Mayo, evidência forte exige error probing: uma afirmação ganha suporte quando passa um teste que teria boa capacidade para revelar maneiras relevantes de ela estar errada. Uma probabilidade posterior elevada, ou um factor de Bayes favorável, não garante por si só essa propriedade; depende do modelo e dos priors considerados e responde a uma pergunta inferencial diferente (Mayo, 2018).
Para este curso, esta linguagem de erros, sensibilidade, poder e severidade também liga mais directamente a inferência ao delineamento experimental que acabámos de estudar. Por isso vamos compreender a lógica bayesiana e algumas das suas vantagens e dificuldades, mas as análises que aprendemos a executar serão frequentistas.
Aprender Com Dados Não É Só Bayes
A linguagem bayesiana de «actualizar crenças» é intuitiva: começamos com um prior, observamos dados e obtemos uma distribuição posterior. Mas não devemos concluir daí que só Bayes «aprende com os dados». A estatística frequentista também procura aprender com dados; simplesmente fundamenta as inferências de outra forma, através do comportamento de procedimentos, incompatibilidade com modelos, sensibilidade a discrepâncias e capacidade de detectar erros.
A divergência é filosófica: é legítimo representar directamente a incerteza sobre uma hipótese ou parâmetro através de uma probabilidade? Bayesianos dizem que sim, sob diferentes interpretações. Frequentistas podem recusar essa passagem sem negar que os dados permitam aprender.
Nem Todos os Priors São Iguais
Uma motivação subjectivista é simples: investigadores já têm expectativas e conhecimento prévio, portanto é preferível torná-los explícitos e actualizá-los coerentemente com os dados. Mas Bayesianismo não é sinónimo de subjectivismo. Há tradições de Bayesianismo objectivo ou de referência que procuram construir priors através de regras formais (Bernardo, 1979; Berger, 2006).
Podemos distinguir, de forma aproximada:
- priors informativos, que codificam conhecimento substantivo;
- priors fracamente informativos, que regularizam e excluem valores implausivelmente extremos sem dominar a análise (Gelman et al., 2008);
- priors ditos objectivos, de referência ou construídos por regras formais (Bernardo, 1979; Berger, 2006);
- priors muito vagos ou «não informativos», uma expressão que deve ser usada com cautela: ser difuso numa parametrização não significa ser neutro em todas as parametrizações ou para todas as perguntas.
Por isso, «o bayesiano escolhe um prior subjectivo» é uma caricatura tão pobre como «o frequentista só pensa em repetições infinitas». O debate não é simplesmente «dados versus opinião»; há desacordo também dentro do Bayesianismo sobre subjectividade, objectividade, regularização e regras de referência.
O Prior Desaparece?
Em muitos modelos regulares e bem identificados, à medida que os dados se tornam mais informativos, a influência de diferentes priors razoáveis pode diminuir e as respectivas distribuições posteriores podem aproximar-se. A literatura sobre consistência e resultados assintóticos bayesianos formaliza situações em que esta intuição funciona; Gelman e Shalizi (2013) discutem essa tradição e também os limites de tratar a convergência assintótica como uma justificação suficiente da prática.
Mas isto não é uma lei universal. Com dados fracos, parâmetros pouco identificados, modelos complexos ou priors que excluem regiões relevantes, a influência do prior pode permanecer importante. Uma verificação de robustez a diferentes priors continua, portanto, a ser necessária. A ideia pedagógica a reter é condicional: com informação suficiente e condições adequadas, desacordos iniciais podem diminuir; não há garantia de que todos os priors acabem por concordar em todos os problemas.
Factores de Bayes ≠ Valores-p
Um factor de Bayes (Bayes factor) compara a capacidade preditiva marginal de dois modelos, integrando sobre os seus parâmetros e priors. Um valor-p pergunta quão extremo é o resultado relativamente a uma distribuição de referência sob \(H_0\). Não respondem à mesma pergunta inferencial.
Isso não significa que os dois números sejam sempre matematicamente independentes. García-Pérez (2017) mostra, por simulação, que em alguns testes comuns — incluindo versões do teste t e de testes de correlação — fixados o tamanho da amostra e a especificação do prior, determinados factores de Bayes por defeito têm uma relação um-para-um com o valor-p. Nesse contexto, ambos são funções da mesma estatística de teste e das mesmas quantidades já fixadas. Esta é provavelmente a origem da intuição de que seria possível «converter» directamente um no outro.
Mas a curva muda quando mudam o tamanho da amostra, o prior, o modelo ou o factor de Bayes escolhido. Portanto, não existe uma identidade geral como \(BF=\log(p)\), nem uma função universal de \(p\) sozinho que produza qualquer factor de Bayes. Há relações condicionais a uma análise especificada.
Outra linha de trabalho procura precisamente calibrar valores-p em termos de evidência bayesiana sem os declarar equivalentes. Sellke et al. (2001) obtêm, sob condições específicas, limites que relacionam um valor-p com o factor de Bayes mínimo a favor de \(H_0\); para \(p<1/e\), uma forma conhecida é
\[ BF_{01} \geq -e\,p\log(p). \]
Isto é uma calibração sob pressupostos, não uma tradução universal de um valor-p em factor de Bayes.
Há ainda situações em que valor-p e factor de Bayes podem apontar em direcções aparentemente muito diferentes à medida que a amostra cresce, fenómeno associado ao paradoxo de Jeffreys–Lindley. O ponto não é que um dos números esteja «a calcular mal». Eles incorporam perguntas e estruturas inferenciais diferentes (Berger & Sellke, 1987).
NotaPara Ler / Explorar
- Gelman & Shalizi (2013), Philosophy and the Practice of Bayesian Statistics.
- Berger (2006), The Case for Objective Bayesian Analysis.
- García-Pérez (2017) — relação entre p e factores de Bayes em testes especificados e crítica de inferências automáticas.
- Sellke et al. (2001), Calibration of p Values for Testing Precise Null Hypotheses.
- Berger & Sellke (1987), The Irreconcilability of P Values and Evidence.
- van Doorn et al. (2021), orientações JASP.
Mayo e o Teste Severo
Depois de vermos Fisher, Neyman–Pearson e uma alternativa bayesiana, podemos perceber melhor o que Deborah Mayo está a tentar fazer. A sua abordagem de error statistics não é uma declaração de que Fisher e Neyman–Pearson afinal diziam a mesma coisa. É uma tentativa de reorganizar elementos úteis das duas tradições em torno de uma pergunta comum: quão bem pusemos uma afirmação à prova?
A pergunta central é:
Se esta afirmação estivesse errada de uma maneira importante, o teste teria tido uma boa oportunidade de mostrar isso?
Mayo e Spanos (2006) distinguem propriedades do procedimento avaliadas antes dos dados de uma avaliação inferencial feita depois dos dados para uma afirmação e um resultado concretos.
Antes dos dados, podemos estudar taxas de erro, poder e sensibilidade. Depois dos dados, perguntamos se uma afirmação específica passou um teste que teria tendência para produzir um resultado menos favorável caso essa afirmação estivesse errada de uma forma relevante.
Uma Ponte Entre Fisher e Neyman–Pearson
É aqui que Mayo aproxima ideias que a narrativa «Fisher contra Neyman–Pearson» costuma separar: de Fisher retém a preocupação com evidência num resultado concreto; de Neyman–Pearson usa o desempenho do procedimento sob alternativas para avaliar quão capaz era o teste de descobrir um erro. A severidade não elimina diferenças históricas entre as escolas. Propõe uma maneira de usar probabilidades de erro para avaliar a força probatória de uma inferência concreta (Mayo, 2018).
É tentador apresentar esta proposta como se «resolvesse» as guerras da estatística. Seria exagerado. A abordagem de error statistics é uma posição filosófica substantiva, discutida e contestável. O seu interesse, para esta página, é que mostra como podemos aproveitar partes de Fisher e de Neyman–Pearson sem fingir que os seus projectos originais eram idênticos.
DicaPré-Dados e Pós-Dados
- Pré-dados: que erros este procedimento controla? Que efeitos consegue detectar?
- Pós-dados: dado o resultado que obtivemos, que afirmações passaram um teste capaz de as pôr realmente em risco?
Confundir estas perguntas é uma fonte importante de mal-entendidos.
A Crítica de Error Statistics
A posição de Mayo torna-se mais clara quando a comparamos com o Bayesianismo. Um bayesiano pode perguntar quão provável é um parâmetro ou modelo depois de combinar prior e dados. Mayo não considera que essa probabilidade posterior seja necessária para avaliar quão bem uma afirmação foi testada. A pergunta que privilegia é outra: o procedimento teria sido capaz de revelar um erro relevante, caso esse erro existisse?
Mayo (2013), comentando Gelman e Shalizi (2013), aceita muito do valor prático de verificação de modelos mas questiona se a filosofia bayesiana fornece as propriedades de detecção de erro que considera necessárias para justificar afirmações científicas. É uma boa leitura precisamente porque o desacordo não é «Bayes funciona / não funciona». É sobre o que conta como garantia probatória.
Isto também ajuda a perceber por que a abordagem de error statistics não é apenas um compromisso diplomático entre escolas. Mayo aproxima Fisher e Neyman–Pearson, mas mantém um desacordo filosófico real com interpretações bayesianas da inferência.
NotaPara Ler / Explorar
- Mayo & Spanos (2006), Severe Testing as a Basic Concept in a Neyman–Pearson Philosophy of Induction.
- Mayo (1991), Novel Evidence and Severe Tests.
- Mayo (1997), Error Statistics and Learning from Error.
- Mayo (2013), comentário de error statistics a Gelman & Shalizi.
- Mayo (2018), Statistical Inference as Severe Testing.
3 Planeamento e Interpretação
Planeamento: Equivalência, Sensibilidade e \(\alpha\)
A discussão anterior tem consequências práticas. Se queremos saber quão bem uma afirmação foi testada, não basta olhar para o resultado depois de o obter. Precisamos de pensar antecipadamente que diferenças seriam importantes e que erros o estudo teria capacidade para revelar.
Não Significativo ≠ Ausência
Se um teste não rejeita \(H_0\), isso pode acontecer porque o efeito é pequeno, porque os dados são imprecisos ou porque o estudo tem pouca sensibilidade. Para apoiar a afirmação de que não existe um efeito grande o suficiente para ser cientificamente relevante, precisamos de uma pergunta mais específica.
Os testes de equivalência definem limites para o menor efeito que valeria a pena distinguir de zero (Lakens, 2017; Lakens et al., 2018). Isto não «prova o nulo» em sentido absoluto: permite rejeitar uma classe de efeitos considerados grandes o suficiente para interessar.
Sensibilidade e Tamanho da Amostra
Se o tamanho da amostra já está fixado, uma análise de sensibilidade de poder pergunta que magnitude de efeito teria uma probabilidade especificada de ser detectada. Lakens (2022) descreve ainda várias formas de justificar tamanho amostral para além de uma única receita de poder.
Justificar \(\alpha\)
O limiar \(\alpha=.05\) é uma convenção histórica, não uma constante da natureza. A história de \(.05\) e \(.01\) mostra ainda por que não devemos transformar retrospectivamente o \(P\) fisheriano no \(\alpha\) de Neyman–Pearson: as convenções influenciaram-se, mas os conceitos não são idênticos. Lakens et al. (2018) defendem que escolhas como \(\alpha\) devem ser transparentes e justificadas. Maier e Lakens (2022) apresentam abordagens práticas.
ImportanteEvitar um Novo Ritual
«Justificar \(\alpha\)» não deve transformar-se noutra caixa para assinalar. A pergunta é que erros importam, que custos têm, que efeito queremos detectar e quão informativo será o estudo.
Intervalos e «Novas Estatísticas»
Intervalos de confiança são extremamente úteis. Mostram a escala de valores que o procedimento não exclui ao nível correspondente e ajudam a comunicar magnitude e precisão. O problema começa quando se apresenta «usar intervalos» como se fosse, por si só, uma filosofia inferencial completamente diferente de «usar testes».
Testes e Intervalos Frequentistas São Duais
Para muitos testes frequentistas usuais, o intervalo de confiança correspondente pode ser construído invertendo o teste: os valores do parâmetro que não seriam rejeitados ao nível escolhido formam o intervalo. Perezgonzalez (2015) enfatiza precisamente que testes e intervalos podem ser dois lados da mesma pergunta.
Isso não torna intervalos inúteis. Pelo contrário: muitas vezes são uma forma muito melhor de mostrar magnitude e precisão do que uma decisão binária. Mas significa que trocar um valor-p por um IC não apaga automaticamente os pressupostos frequentistas nem transforma o intervalo numa distribuição posterior.
A Proposta das «Novas Estatísticas»
Cumming (2014) defende uma mudança de ênfase para tamanhos de efeito, intervalos de confiança, meta-análise, replicação e acumulação quantitativa. Há muito de valioso aqui: comunicar magnitudes, mostrar incerteza e acumular evidência é preferível a publicar apenas «significativo / não significativo».
O próprio Cumming reconhece que, nos casos correspondentes, ICs e valores-p assentam na mesma teoria estatística e é possível passar de um para o outro. O argumento a favor dos intervalos é sobretudo que tornam magnitude e precisão mais visíveis ao leitor, não que pertençam a uma filosofia probabilística totalmente diferente (Cumming, 2014). Perezgonzalez (2015) aprofunda este ponto, distinguindo a história fisheriana dos valores-p da origem Neyman–Pearson dos intervalos e mostrando a dualidade matemática entre testes e intervalos correspondentes.
Por isso, quando a proposta das «novas estatísticas» é entendida como se a simples substituição de NHST por intervalos resolvesse os problemas inferenciais, é preciso ser mais cauteloso. García-Pérez (2017) argumenta que muitas críticas ao NHST atacam interpretações que o procedimento nunca justificou e que alternativas, incluindo ICs, tamanhos de efeito e métodos bayesianos, também podem ser mal interpretadas ou usadas mecanicamente.
Mayo levantou a mesma questão em discussão directa com Cumming: como os intervalos correspondentes são duais aos testes, que erro inferencial é realmente corrigido pela simples troca de formato? A discussão está reunida em Do CIs Avoid Fallacies of Tests? Reforming the Reformers e na resposta de Cumming.
Os Intervalos Também São Mal Interpretados
Hoekstra et al. (2014) relataram interpretações incorrectas persistentes de ICs em estudantes e investigadores. A leitura desse questionário foi depois contestada por Miller e Ulrich (2016), sobretudo quanto ao que as respostas permitem concluir sobre compreensão dos ICs. Morey et al. (2016) desenvolvem a questão conceptual: várias afirmações intuitivas sobre um IC observado não se seguem da teoria frequentista que o gerou.
Um IC frequentista de 95% não significa que, depois de calculado, há 95% de probabilidade de o parâmetro fixo estar dentro daquele intervalo específico. A garantia refere-se ao procedimento de construção de intervalos sob o modelo.
ImportanteO Problema Não É Mostrar Incerteza
Intervalos de confiança podem comunicar incerteza muito melhor do que um asterisco de significância. O ponto é outro: mudar a visualização ou o resumo não substitui compreender a inferência. Um IC interpretado como distribuição posterior é tão enganador como um valor-p interpretado como \(P(H_0\mid D)\).
NotaPara Ler / Explorar
- Cumming (2014), The New Statistics: Why and How.
- García-Pérez (2017), Thou Shalt Not Bear False Witness Against Null Hypothesis Significance Testing.
- Perezgonzalez (2015), Confidence Intervals and Tests Are Two Sides of the Same Research Question.
- Hoekstra et al. (2014), Robust Misinterpretation of Confidence Intervals.
- Morey et al. (2016), The Fallacy of Placing Confidence in Confidence Intervals.
- Mayo (1981), In Defense of the Neyman-Pearson Theory of Confidence Intervals.
4 Prática Científica
Estatística Ritual: A Forma Sem Compreensão
Stark e Saltelli (2018) usam a expressão cargo-cult statistics para descrever a aplicação mecânica de procedimentos: seguimos a forma reconhecível da análise sem compreender suficientemente o que cada passo faz, que pergunta responde ou que pressupostos exige.
A crítica é importante. Nesta página preferimos estatística ritual: a expressão diz directamente aquilo que nos interessa sem depender da metáfora antropológica.
NotaPorque evitamos a expressão cargo cult
Feynman (1974) popularizou cargo cult science a partir de relatos então correntes sobre movimentos da Melanésia. A literatura antropológica posterior questionou tanto a coerência da categoria como a genealogia colonial de algumas das suas representações (McDowell, 1988; Lindstrom, 1993; Hermann, 2004).
Isso não implica que exista uma posição antropológica única sobre abandonar a expressão: Otto (2009) defende que ainda pode ter valor comparativo quando usada com cuidado. Para o nosso objectivo, porém, não é necessário repetir uma metáfora com esta bagagem histórica para criticar práticas científicas ritualizadas. Gelman e Higgs (2025) fazem precisamente esse argumento e propõem ritual science como alternativa.
Um exemplo simples é transformar «\(p<.05\)» numa rotina automática: correr o teste, procurar o asterisco e escrever «há efeito» ou «não há efeito» sem pensar na magnitude, precisão, sensibilidade, multiplicidade ou no delineamento.
Mas o problema não pertence ao NHST. Também podemos escolher um prior por defeito, copiar um factor de Bayes, desenhar um intervalo de confiança ou reportar um tamanho de efeito sem compreender o que cada número permite afirmar. Substituir uma ferramenta por outra não elimina o ritual.
García-Pérez (2017) é útil precisamente por mostrar que várias falhas atribuídas ao NHST são falhas de interpretação ou de delineamento que podem reaparecer com outras ferramentas.
A salvaguarda é reconstruir a cadeia de raciocínio: o que queremos saber, que dados podem responder, que erro seria relevante, que modelo estamos a usar, que alternativas o procedimento consegue distinguir e que conclusão o resultado permite?
5 Síntese
Um Mapa de Perguntas
- Descrição: o que aconteceu nesta amostra?
- Estimação: que valores para o parâmetro são compatíveis com estes dados e este modelo?
- Fisher: quão incompatíveis são os dados com \(H_0\)?
- Neyman–Pearson: como se comporta esta regra sob \(H_0\) e alternativas relevantes?
- Poder/sensibilidade: que discrepâncias conseguiríamos detectar?
- Bayes: como muda a incerteza depois de combinar prior e dados?
- Mayo: se esta afirmação estivesse errada desta maneira, o teste teria boa oportunidade de mostrar isso?
- Equivalência: podemos excluir efeitos suficientemente grandes para serem relevantes?
- Intervalos: que valores não são excluídos pelo procedimento no nível escolhido e com que precisão estamos a estimar?
- Decisão: que acção escolher, dados os custos dos erros?
O Que Reter e Onde Continuar
A estatística não nos dá uma licença para substituir perguntas científicas por regras automáticas. Um resultado é informativo quando conseguimos dizer:
- que pergunta o procedimento responde;
- que pressupostos foram necessários;
- que erros ou discrepâncias podia revelar;
- quanta incerteza permanece;
- que conclusões não são justificadas pelos dados.
Para trabalhar com estas ideias em modelos concretos, sigam A Abordagem de Comparação de Modelos. Para pressupostos, robustez e triangulação, vejam Diagnóstico e Pressupostos. Para a base filosófica sobre testes e erro, regressem a Filosofia da Ciência.
6 Exercícios
Reflexão Conceptual
- Condicionais: explique por que \(P(A\mid B)\) e \(P(B\mid A)\) não são, em geral, a mesma quantidade. Dê um exemplo em que a troca produz uma conclusão enganadora.
- Intuição probabilística: escolha dois itens do pequeno catálogo acima e explique por que a resposta intuitiva é sedutora e por que falha.
- Fisher versus Neyman–Pearson: explique por que um valor-p observado e \(\alpha\) não são a mesma coisa. Que pergunta cada um responde?
- História de .05: explique por que são compatíveis estas duas afirmações: Fisher ajudou a popularizar 5% como referência e Fisher não defendia um nível universal para toda a investigação. Que papel tiveram as tabelas?
- História: leia Fisher (1955), Pearson (1955) e Neyman (1956). Identifique uma discordância genuína e um ponto em que a retórica parece maior do que a distância prática.
- Bayes: explique por que «Bayes permite aprender com os dados e frequentismo não» é uma descrição errada do desacordo.
- Priors: compare um prior informativo, um fracamente informativo e um de referência. Que objectivo diferente pode justificar cada um?
- Teste severo: imagine um resultado favorável obtido por um procedimento pouco sensível. Porque pode falhar em fornecer evidência forte no sentido de Mayo?
Análise Crítica
- Factor de Bayes e valor-p: explique por que não existe uma tradução geral de \(p\) para qualquer factor de Bayes e, ao mesmo tempo, como García-Pérez (2017) pode encontrar uma relação um-para-um quando \(n\) e o prior estão fixados.
- Intervalos de confiança: explique por que um IC de 95% não é uma posterior de 95%. Depois explique porque, apesar disso, pode comunicar melhor magnitude e precisão do que um resultado apenas significativo/não significativo.
- Equivalência: um estudo produz \(p=.42\). Explique porque isso não basta para concluir «não há efeito».
- Sensibilidade: uma amostra já está fixada. Que pergunta responde uma análise de sensibilidade de poder?
- Estatística ritual: explique por que esta página prefere a expressão «estatística ritual» a cargo-cult statistics. Separe a crítica ao uso mecânico de métodos da história antropológica da metáfora.
Aplicação Prática
- Planeamento: para uma hipótese da sua área, especifique a menor discrepância cientificamente relevante, justifique a amostra e explique que erros o estudo terá facilidade ou dificuldade em detectar.
- Justificar \(\alpha\): proponha uma justificação para \(\alpha\) que não seja apenas «é o valor habitual».
- Escolher uma abordagem: para uma pergunta concreta, diga se quer sobretudo testar discrepâncias, estimar magnitude, actualizar uma distribuição, comparar modelos ou tomar uma decisão. Só depois escolha o procedimento.
7 Referências
Bar-Hillel, M. (1979). The role of sample size in sample evaluation. Organizational Behavior and Human Performance, 24(2), 245–257. https://doi.org/10.1016/0030-5073(79)90028-X
Berger, J. O. (2003). Could Fisher, Jeffreys and Neyman have agreed on testing? Statistical Science, 18(1), 1–32. https://doi.org/10.1214/ss/1056397485
Berger, J. O. (2006). The case for objective Bayesian analysis. Bayesian Analysis, 1(3), 385–402. https://doi.org/10.1214/06-BA115
Berger, J. O., & Sellke, T. (1987). Testing a point null hypothesis: The irreconcilability of P values and evidence. Journal of the American Statistical Association, 82(397), 112–122. https://doi.org/10.1080/01621459.1987.10478397
Bernardo, J. M. (1979). Reference posterior distributions for Bayesian inference. Journal of the Royal Statistical Society: Series B, 41(2), 113–147. https://doi.org/10.1111/j.2517-6161.1979.tb01066.x
Chandrashekar, S. P., Cheng, Y. H., Fong, C. L., Leung, Y. C., Wong, Y. T., Cheng, B. L., & Feldman, G. (2021). Frequency estimation and semantic ambiguity do not eliminate conjunction bias, when it occurs: Replication and extension of Mellers, Hertwig, and Kahneman (2001). Meta-Psychology, 5. https://doi.org/10.15626/MP.2020.2474
Cowles, M., & Davis, C. (1982). On the origins of the .05 level of statistical significance. American Psychologist, 37(5), 553–558. https://doi.org/10.1037/0003-066X.37.5.553
Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
Dienes, Z. (2008). Understanding psychology as a science: An introduction to scientific and statistical inference. Palgrave Macmillan. https://www.bloomsbury.com/us/understanding-psychology-as-a-science-9780230542310/
D’Amelio, A. (2009). Undergraduate student difficulties with independent and mutually exclusive events concepts. The Mathematics Enthusiast, 6(1), 47–56. https://doi.org/10.54870/1551-3440.1133
Falk, R. (2015). Numbers defy the law of large numbers. Teaching Statistics, 37(2), 54–60. https://doi.org/10.1111/test.12031
Farmer, G. D., Warren, P. A., & Hahn, U. (2017). Who “believes” in the gambler’s fallacy and why? Journal of Experimental Psychology: General, 146(1), 63–76. https://doi.org/10.1037/xge0000245
Feynman, R. P. (1974). Cargo cult science. Engineering and Science, 37(7), 10–13. https://resolver.caltech.edu/CaltechES:37.7.CargoCult
Fisher, R. A. (1925). Statistical methods for research workers. Oliver & Boyd. https://psychclassics.yorku.ca/Fisher/Methods/
Fisher, R. A. (1926). The arrangement of field experiments. Journal of the Ministry of Agriculture of Great Britain, 33, 503–513. https://digital.library.adelaide.edu.au/dspace/handle/2440/15191
Fisher, R. A. (1955). Statistical methods and scientific induction. Journal of the Royal Statistical Society: Series B, 17(1), 69–78. https://doi.org/10.1111/j.2517-6161.1955.tb00180.x
García-Pérez, M. A. (2017). Thou shalt not bear false witness against null hypothesis significance testing. Educational and Psychological Measurement, 77(4), 631–662. https://doi.org/10.1177/0013164416668232
Gelman, A., & Higgs, M. (2025). Interrogating the “cargo cult science” metaphor. Theory and Society. https://doi.org/10.1007/s11186-025-09614-6
Gelman, A., Jakulin, A., Pittau, M. G., & Su, Y.-S. (2008). A weakly informative default prior distribution for logistic and other regression models. The Annals of Applied Statistics, 2(4), 1360–1383. https://doi.org/10.1214/08-AOAS191
Gelman, A., & Shalizi, C. R. (2013). Philosophy and the practice of Bayesian statistics. British Journal of Mathematical and Statistical Psychology, 66(1), 8–38. https://doi.org/10.1111/j.2044-8317.2011.02037.x
Gigerenzer, G., & Hoffrage, U. (1995). How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704. https://doi.org/10.1037/0033-295X.102.4.684
Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
Hermann, E. (2004). Dissolving the self-other dichotomy in Western “cargo cult” constructions. In H. Jebens (Ed.), Cargo, cult, and culture critique (pp. 36–58). University of Hawai’i Press. https://doi.org/10.1515/9780824840440-004
Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3
Hubbard, R., & Bayarri, M. J. (2003). Confusion over measures of evidence (\(p\)’s) versus errors (\(\alpha\)’s) in classical statistical testing. The American Statistician, 57(3), 171–178. https://doi.org/10.1198/0003130031856
Kennedy-Shaffer, L. (2019). Before \(p<0.05\) to beyond \(p<0.05\): Using history to contextualize p-values and significance testing. The American Statistician, 73(sup1), 82–90. https://doi.org/10.1080/00031305.2018.1537891
Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. https://doi.org/10.1525/collabra.33267
Lakens, D., Adolfi, F. G., Albers, C. J., et al. (2018). Justify your alpha. Nature Human Behaviour, 2, 168–171. https://doi.org/10.1038/s41562-018-0311-x
Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
Lehmann, E. L. (2011). Fisher, Neyman, and the creation of classical statistics. Springer. https://doi.org/10.1007/978-1-4419-9500-1
Lindstrom, L. (1993). Cargo cult culture: Toward a genealogy of Melanesian kastom. Anthropological Forum, 6(4), 495–513. https://doi.org/10.1080/00664677.1993.9967429
Maier, M., & Lakens, D. (2022). Justify your alpha: A primer on two practical approaches. Advances in Methods and Practices in Psychological Science, 5(2). https://doi.org/10.1177/25152459221080396
Mayo, D. G. (1981). In defense of the Neyman-Pearson theory of confidence intervals. Philosophy of Science, 48(2), 269–280. https://doi.org/10.1086/288996
Mayo, D. G. (1991). Novel evidence and severe tests. Philosophy of Science, 58(4), 523–552. https://doi.org/10.1086/289639
Mayo, D. G. (1997). Error statistics and learning from error: Making a virtue of necessity. Philosophy of Science, 64, S195–S212. https://doi.org/10.1086/392600
Mayo, D. G. (2013). The error-statistical philosophy and the practice of Bayesian statistics: Comments on Gelman and Shalizi. British Journal of Mathematical and Statistical Psychology, 66(1), 57–64. https://doi.org/10.1111/j.2044-8317.2012.02064.x
Mayo, D. G. (2018). Statistical inference as severe testing: How to get beyond the statistics wars. Cambridge University Press. https://doi.org/10.1017/9781107286184
Mayo, D. G., & Spanos, A. (2006). Severe testing as a basic concept in a Neyman–Pearson philosophy of induction. The British Journal for the Philosophy of Science, 57(2), 323–357. https://doi.org/10.1093/bjps/axl003
McDowell, M., & Jacobs, P. (2017). Meta-analysis of the effect of natural frequencies on Bayesian reasoning. Psychological Bulletin, 143(12), 1273–1312. https://doi.org/10.1037/bul0000126
McDowell, N. (1988). A note on cargo cults and cultural constructions of change. Pacific Studies, 11(2), 121–134. https://digitalcollections.byuh.edu/pacific-studies-journal/vol11/iss2/9/
Mellers, B., Hertwig, R., & Kahneman, D. (2001). Do frequency representations eliminate conjunction effects? An exercise in adversarial collaboration. Psychological Science, 12(4), 269–275. https://doi.org/10.1111/1467-9280.00350
Miller, J., & Ulrich, R. (2016). Interpreting confidence intervals: A comment on Hoekstra, Morey, Rouder, and Wagenmakers (2014). Psychonomic Bulletin & Review, 23(1), 124–130. https://doi.org/10.3758/s13423-015-0859-7
Morey, R. D., Hoekstra, R., Rouder, J. N., Lee, M. D., & Wagenmakers, E.-J. (2016). The fallacy of placing confidence in confidence intervals. Psychonomic Bulletin & Review, 23(1), 103–123. https://doi.org/10.3758/s13423-015-0947-8
Morsanyi, K., Primi, C., Chiesi, F., & Handley, S. (2009). The effects and side-effects of statistics education: Psychology students’ (mis-)conceptions of probability. Contemporary Educational Psychology, 34(3), 210–220. https://doi.org/10.1016/j.cedpsych.2009.05.001
Neyman, J. (1956). Note on an article by Sir Ronald Fisher. Journal of the Royal Statistical Society: Series B, 18(2), 288–294. https://doi.org/10.1111/j.2517-6161.1956.tb00236.x
Neyman, J., & Pearson, E. S. (1928a). On the use and interpretation of certain test criteria for purposes of statistical inference: Part I. Biometrika, 20A(1/2), 175–240. https://doi.org/10.1093/biomet/20A.1-2.175
Neyman, J., & Pearson, E. S. (1928b). On the use and interpretation of certain test criteria for purposes of statistical inference: Part II. Biometrika, 20A(3/4), 263–294. https://doi.org/10.1093/biomet/20A.3-4.263
Neyman, J., & Pearson, E. S. (1933a). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
Neyman, J., & Pearson, E. S. (1933b). The testing of statistical hypotheses in relation to probabilities a priori. Proceedings of the Cambridge Philosophical Society, 29(4), 492–510. https://doi.org/10.1017/S030500410001152X
Otto, T. (2009). What happened to cargo cults? Material religions in Melanesia and the West. Social Analysis, 53(1), 82–102. https://doi.org/10.3167/sa.2009.530106
Pearson, E. S. (1955). Statistical concepts in their relation to reality. Journal of the Royal Statistical Society: Series B, 17(2), 204–207. https://doi.org/10.1111/j.2517-6161.1955.tb00194.x
Perezgonzalez, J. D. (2014). A reconceptualization of significance testing. Theory & Psychology, 24(6), 852–859. https://doi.org/10.1177/0959354314546157
Perezgonzalez, J. D. (2015). Confidence intervals and tests are two sides of the same research question. Frontiers in Psychology, 6, 34. https://doi.org/10.3389/fpsyg.2015.00034
Sabbaghi, A., & Rubin, D. B. (2014). Comments on the Neyman–Fisher controversy and its consequences. Statistical Science, 29(2), 267–284. https://doi.org/10.1214/13-STS454
Sellke, T., Bayarri, M. J., & Berger, J. O. (2001). Calibration of p values for testing precise null hypotheses. The American Statistician, 55(1), 62–71. https://doi.org/10.1198/000313001300339950
Stark, P. B., & Saltelli, A. (2018). Cargo-cult statistics and scientific crisis. Significance, 15(4), 40–43. https://doi.org/10.1111/j.1740-9713.2018.01174.x
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Stengård, E., Juslin, P., Hahn, U., & van den Berg, R. (2022). On the generality and cognitive basis of base-rate neglect. Cognition, 226, 105160. https://doi.org/10.1016/j.cognition.2022.105160
Szollosi, A., & Newell, B. R. (2020). People as intuitive scientists: Reconsidering statistical explanations of decision making. Trends in Cognitive Sciences, 24(12), 1008–1018. https://doi.org/10.1016/j.tics.2020.09.005
Thompson, W. C., & Schumann, E. L. (1987). Interpretation of statistical evidence in criminal trials: The prosecutor’s fallacy and the defense attorney’s fallacy. Law and Human Behavior, 11(3), 167–187. https://doi.org/10.1007/BF01044641
Tversky, A., & Kahneman, D. (1971). Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110. https://doi.org/10.1037/h0031322
Tversky, A., & Kahneman, D. (1973). Availability: A heuristic for judging frequency and probability. Cognitive Psychology, 5(2), 207–232. https://doi.org/10.1016/0010-0285(73)90033-9
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
Tversky, A., & Kahneman, D. (1983). Extensional versus intuitive reasoning: The conjunction fallacy in probability judgment. Psychological Review, 90(4), 293–315. https://doi.org/10.1037/0033-295X.90.4.293
van Doorn, J., van den Bergh, D., Böhm, U., Dablander, F., Derks, K., Draws, T., et al. (2021). The JASP guidelines for conducting and reporting a Bayesian analysis. Psychonomic Bulletin & Review, 28, 813–826. https://doi.org/10.3758/s13423-020-01798-5
Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
Weingarten, E., & Hutchinson, J. W. (2018). Does ease mediate the ease-of-retrieval effect? A meta-analysis. Psychological Bulletin, 144(3), 227–283. https://doi.org/10.1037/bul0000122
Xiang, Y., Dorst, K., & Gershman, S. J. (2025). On the robustness and provenance of the gambler’s fallacy. Psychological Science, 36(6), 451–464. https://doi.org/10.1177/09567976251344570