# Run once in the console, not in a script you execute regularly.
install.packages(c("palmerpenguins", "ggplot2", "ggrepel", "performance", "see",
"car", "nortest", "sandwich", "lmtest", "robustbase"))Pressupostos: Do Ritual ao Diagnóstico
Modelos Lineares
Pressupostos
Diagnóstico
Triangulação
Como obter, ler e usar diagnósticos de modelos no R sem transformar testes de pressupostos em semáforos.
0 Introdução
Esta página é sobretudo um tutorial de diagnóstico no R. A teoria que explica o que os resíduos representam, por que os pressupostos pertencem ao modelo e por que um teste auxiliar não escolhe automaticamente a análise está nos capítulos teóricos. Antes de trabalhar o código, leia pelo menos A Abordagem de Comparação de Modelos e, se houver agrupamento ou repetição, a secção sobre dependência e modelos mistos. Para decidir qual é a unidade de observação, volte também ao delineamento. Para perceber o que muda quando usamos trimming, Winsorização, estimadores-M, bootstrap ou jackknife, veja Estatística Robusta.
Aqui vamos fazer uma tarefa mais concreta: ajustar um modelo, pedir os gráficos de diagnóstico, torná-los legíveis, investigar um padrão e comparar uma alternativa quando isso fizer sentido.
A sequência prática é:
- confirmar o delineamento e a unidade de observação;
- ajustar o modelo que responde à pergunta;
- obter diagnósticos gráficos suficientemente grandes para os conseguir ler;
- usar testes formais apenas como informação auxiliar, quando forem úteis;
- avaliar se uma alternativa razoável muda a estimativa ou a incerteza.
ImportanteO Que Não Vamos Fazer
Não use shapiro.test(), nortest::lillie.test() ou leveneTest() como portagens: p > .05 não certifica um modelo e p < .05 não manda automaticamente transformar os dados ou trocar para um teste «não-paramétrico». Com amostras grandes, estes testes detectam desvios muito pequenos. Mais abaixo vamos simular exactamente esse caso.
1 Preparação
Vamos perguntar como a massa corporal dos pinguins varia com o comprimento da barbatana, a espécie e o sexo. Precisará dos pacotes palmerpenguins, ggplot2, performance e see. O pacote performance calcula os diagnósticos. see acrescenta métodos de plot() para os vermos separadamente. Algumas análises opcionais usam sandwich, lmtest e robustbase.
library(ggplot2)
library(palmerpenguins)
library(performance)
library(see)

vars <- c("body_mass_g", "flipper_length_mm", "species", "sex")
dados <- penguins[complete.cases(penguins[, vars]), vars]

modelo <- lm(body_mass_g ~ flipper_length_mm * species + sex,
             data = dados)
summary(modelo)
Call:
lm(formula = body_mass_g ~ flipper_length_mm * species + sex,
    data = dados)

Residuals:
    Min      1Q  Median      3Q     Max
-721.46 -194.61   -0.69  200.34  850.22

Coefficients:
                                    Estimate Std. Error t value Pr(>|t|)
(Intercept)                          -60.018    734.674  -0.082    0.935
flipper_length_mm                     18.440      3.888   4.742 3.16e-06 ***
speciesChinstrap                     927.837   1222.338   0.759    0.448
speciesGentoo                      -1066.465   1165.273  -0.915    0.361
sexmale                              521.558     38.145  13.673  < 2e-16 ***
flipper_length_mm:speciesChinstrap    -5.139      6.300  -0.816    0.415
flipper_length_mm:speciesGentoo        8.957      5.637   1.589    0.113
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 294.2 on 326 degrees of freedom
Multiple R-squared:  0.8689,    Adjusted R-squared:  0.8665
F-statistic: 360.2 on 6 and 326 DF,  p-value: < 2.2e-16
A interacção permite que o declive associado ao comprimento da barbatana varie entre espécies. Não foi acrescentada para «melhorar pressupostos»: representa uma possibilidade científica que também é visível num gráfico dos dados.
ggplot(dados,
       aes(x = flipper_length_mm, y = body_mass_g, colour = species)) +
  geom_point(alpha = 0.55) +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~ sex) +
  theme_classic() +
  labs(x = "Comprimento da barbatana (mm)",
       y = "Massa corporal (g)", colour = "Espécie")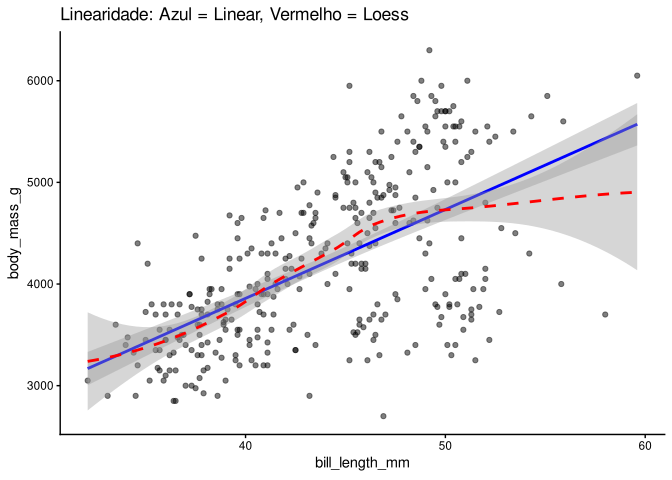
Antes de inspeccionar resíduos, confirme a proveniência das linhas: cada linha é um pinguim observado uma vez? Há colónias, anos ou locais que deviam ser modelados? O conjunto inclui a ilha, mas este exemplo não contém toda a informação de amostragem necessária para garantir independência. O diagnóstico estatístico não preenche metadados ausentes.
2 Pedir os Diagnósticos
A forma mais rápida de começar é performance::check_model(). Como a função junta vários painéis, não deixe o Quarto usar uma figura pequena: num tutorial web, os rótulos e os pontos ficam rapidamente ilegíveis.
check_model(modelo)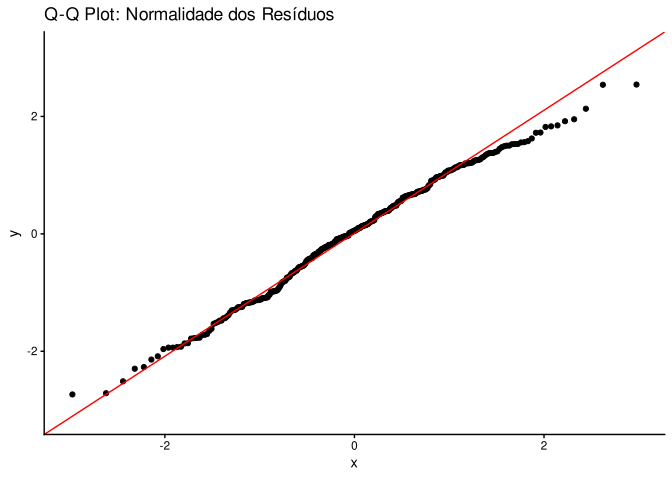
Se estiver a adaptar este código para outro documento, copie também fig-width e fig-height. Aumentar apenas a largura mostrada no HTML não resolve uma figura que foi originalmente desenhada num dispositivo demasiado pequeno.
Leia o painel como um mapa para decidir onde olhar de seguida. Não conte quantos gráficos «passaram». Resíduos contra ajustados ajudam a ver forma e dispersão. O Q–Q plot ajuda a localizar desvios nas caudas. Medidas de influência mostram casos que podem dominar o ajuste.
Ver Cada Diagnóstico Separadamente
O check_model() é o ponto de partida. Depois, em vez de reconstruir cada diagnóstico à mão, podemos usar as funções check_* do performance. Muitas devolvem simultaneamente um resultado numérico e um objecto que o pacote see sabe desenhar com plot().
A lógica prática é sempre semelhante:
diagnostico <- modelo |>
  check_alguma_coisa()

diagnostico
diagnostico |> plot()
Comece por passar o próprio objecto do modelo. Isto funciona directamente para lm(), glm() e muitos modelos mistos. Com alguns objectos criados por afex::mixed(), uma função pode precisar do modelo ajustado guardado dentro do objecto:
# Tente primeiro:
m_misto |>
  check_model()

# Se a função não reconhecer o wrapper de afex:
m_misto$full_model |>
  check_model()
Não extraia $full_model por rotina quando não é necessário: é apenas uma forma de chegar ao modelo subjacente quando uma função não tem método para o objecto exterior.
Normalidade dos Resíduos
normalidade <- modelo |>
  check_normality()

normalidade
OK: residuals appear as normally distributed (p = 0.760).normalidade |>
plot(type = "qq")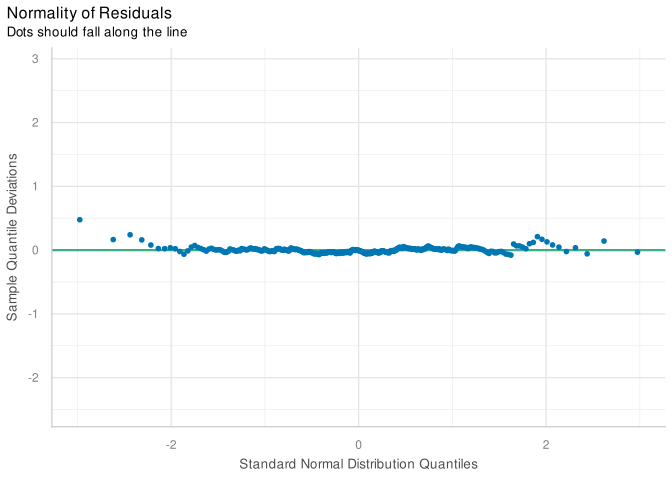
Para modelos Gaussianos, check_normality() aplica um teste de Shapiro–Wilk aos resíduos padronizados. O próprio performance recomenda cautela: com amostras grandes, o teste encontra facilmente desvios pequenos e a inspecção visual do Q–Q plot costuma ser mais informativa.
Variância Constante
Quando a preocupação é heterocedasticidade ao longo dos valores previstos:
heterocedasticidade <- modelo |>
  check_heteroscedasticity()

heterocedasticidade
OK: Error variance appears to be homoscedastic (p = 0.859).heterocedasticidade |>
plot()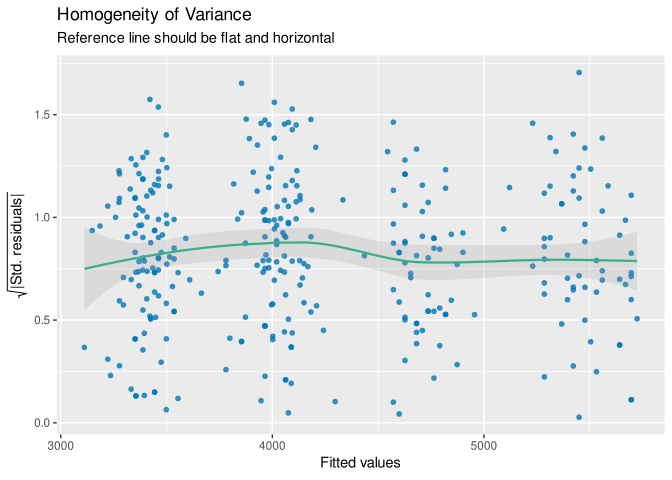
Num modelo linear, check_heteroscedasticity() usa um teste Breusch–Pagan. O gráfico ajuda a perceber como a variância muda, em vez de nos deixar apenas com um valor-p.
Quando a pergunta é especificamente se grupos têm variâncias diferentes, performance também disponibiliza check_homogeneity(). Por exemplo, num modelo simples por espécie:
modelo_especies <- dados |>
  lm(body_mass_g ~ species, data = _)

homogeneidade <- modelo_especies |>
  check_homogeneity(method = "levene")

homogeneidade
Warning: Variances differ between groups (Levene's Test, p = 0.006).homogeneidade |>
plot()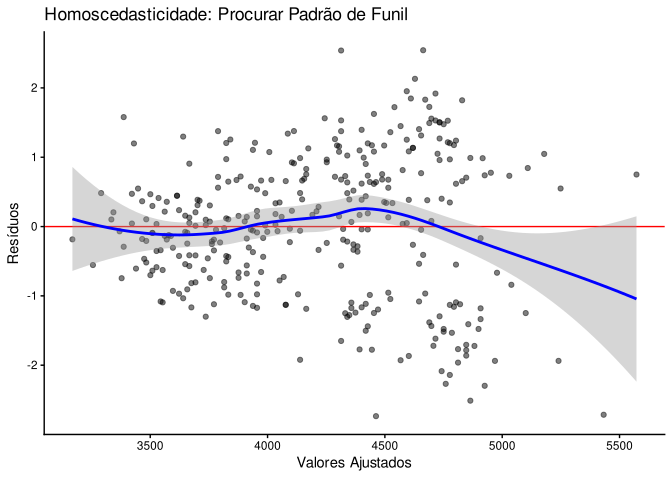
Aqui pedimos explicitamente Levene. Também existem Bartlett e Fligner–Killeen. Escolher entre eles é uma decisão sobre a pergunta e as condições do teste, não uma corrida para encontrar o maior valor-p.
Colinearidade
colinearidade <- modelo |>
  check_collinearity()

colinearidade| Term | VIF | VIF_CI_low | VIF_CI_high | SE_factor | Tolerance | Tolerance_CI_low | Tolerance_CI_high |
|---|---|---|---|---|---|---|---|
| flipper_length_mm | 1.139311e+01 | 9.351064e+00 | 1.393448e+01 | 3.375368 | 0.0877724 | 0.0717644 | 0.1069397 |
| species | 8.270843e+05 | 6.712849e+05 | 1.019043e+06 | 30.156952 | 0.0000012 | 0.0000010 | 0.0000015 |
| sex | 1.399566e+00 | 1.249758e+00 | 1.639232e+00 | 1.183033 | 0.7145070 | 0.6100418 | 0.8001549 |
| flipper_length_mm:species | 9.042724e+05 | 7.339330e+05 | 1.114146e+06 | 950.932366 | 0.0000011 | 0.0000009 | 0.0000014 |
colinearidade |>
  plot()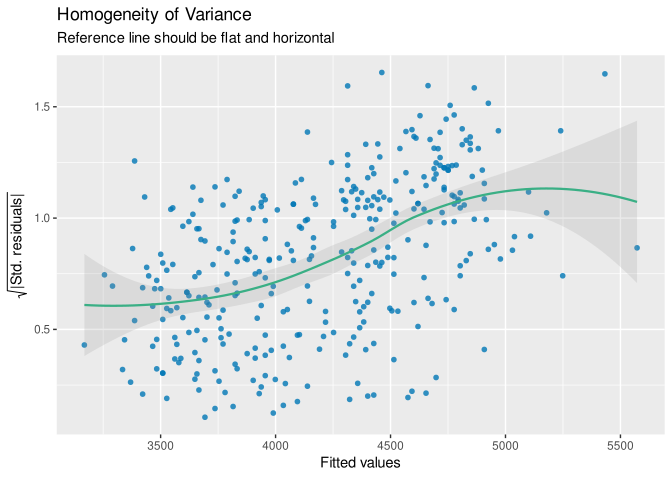
check_collinearity() resume VIF, tolerância e respectivos intervalos. Não há um limiar universal que transforme automaticamente um VIF em «modelo válido» ou «modelo inválido».
Independência Quando Há Uma Ordem Real
performance::check_autocorrelation() implementa um teste de Durbin–Watson. Mas a ordem das observações tem de ter significado científico: tempo, sequência, posição espacial ordenada, etc. Não o execute sobre linhas arbitrariamente ordenadas e depois interprete o valor-p como um teste geral de «independência».
# Só quando a ordem das observações representa uma sequência relevante:
modelo_temporal |>
  check_autocorrelation()
Para agrupamento por pessoa, escola, tanque, local ou estímulo, a solução principal continua a ser representar essa dependência no delineamento e no modelo, frequentemente com efeitos aleatórios ou outra estrutura apropriada.
O Que check_model() Já Faz
Não precisamos de escolher entre «painel» e «funções individuais». check_model() chama a mesma família de diagnósticos e permite seleccionar apenas alguns:
modelo |>
  check_model(check = c("qq", "linearity", "outliers"), panel = FALSE)
Use o painel para triagem e as funções individuais quando precisar do resultado numérico, de um gráfico maior ou de investigar uma hipótese diagnóstica específica.
3 Testes Clássicos: Saber Usá-los
Os testes formais continuam a aparecer em artigos, manuais e software. Convém saber pedi-los no R, mesmo quando não os usamos como interruptores.
Shapiro–Wilk e Lilliefors
Para os resíduos do modelo:
shapiro.test(resid(modelo))
    Shapiro-Wilk normality test

data:  resid(modelo)
W = 0.99679, p-value = 0.7501nortest::lillie.test(resid(modelo))
    Lilliefors (Kolmogorov-Smirnov) normality test

data:  resid(modelo)
D = 0.02572, p-value = 0.855
O primeiro comando usa Shapiro–Wilk. O segundo usa o teste de Kolmogorov–Smirnov com a correcção de Lilliefors, através de nortest::lillie.test(). Esta é a variante apropriada quando queremos testar normalidade mas a média e a variância da normal de referência são estimadas nos próprios dados. Por isso, não usamos aqui ks.test() contra uma normal com parâmetros estimados na mesma amostra.
Levene/Brown–Forsythe
Se a pergunta for se a dispersão residual difere entre grupos conhecidos, podemos pedir a variante de Levene centrada na mediana, frequentemente chamada Brown–Forsythe:
teste_variancias <- data.frame(
  residuo = resid(modelo),
  species = dados$species
)

car::leveneTest(
  residuo ~ species,
  data = teste_variancias,
  center = median
)| Df | F value | Pr(>F) | |
|---|---|---|---|
| group | 2 | 0.8781715 | 0.4165108 |
| 330 | NA | NA |
Isto testa uma pergunta específica sobre dispersão entre estes grupos. Não substitui o gráfico de resíduos contra valores ajustados, não testa independência e não detecta todas as formas possíveis de heterocedasticidade.
4 Quando uma Amostra Grande Encontra Tudo
O efeito do tamanho amostral vê-se melhor do que se explica. Vamos criar 5 000 valores com uma assimetria pequena. O Q–Q plot fica visualmente muito próximo de uma linha recta, mas a distribuição não é exactamente normal.
set.seed(2026)

n <- 5000
z <- rnorm(n)
quase_normal <- z + 0.06 * (z^2 - 1)

sim_normal <- data.frame(valor = quase_normal)

ggplot(sim_normal, aes(sample = valor)) +
  stat_qq(alpha = 0.45) +
  stat_qq_line() +
  theme_classic() +
  labs(x = "Quantis normais teóricos",
       y = "Quantis simulados")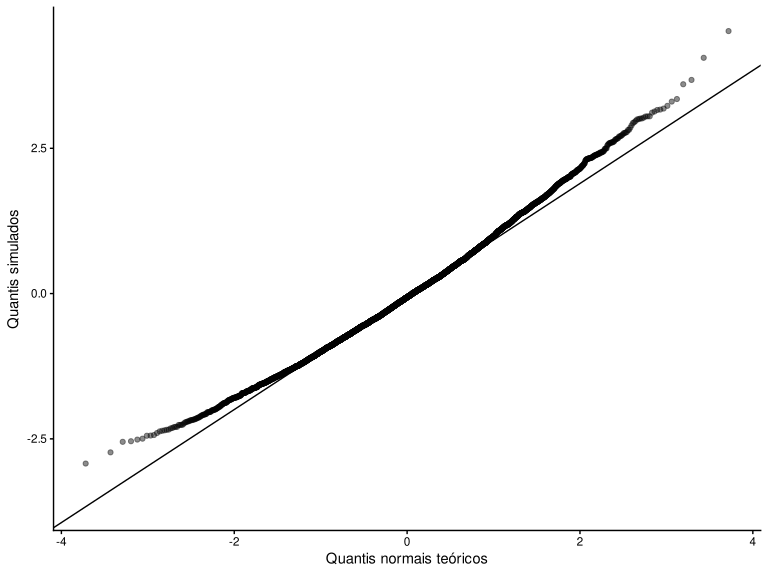
Agora peça os testes:
shapiro.test(quase_normal)
    Shapiro-Wilk normality test

data:  quase_normal
W = 0.99235, p-value = 8.954e-16nortest::lillie.test(quase_normal)
    Lilliefors (Kolmogorov-Smirnov) normality test

data:  quase_normal
D = 0.028624, p-value = 5.074e-10
Os dois testes avaliam normalidade, mas o segundo é a versão Kolmogorov–Smirnov com correcção de Lilliefors. Note também uma limitação prática: shapiro.test() no R aceita no máximo 5 000 observações.
O ponto não é que os testes estejam «errados». Estão a fazer o seu trabalho: com muita informação conseguem detectar uma discrepância pequena. A pergunta seguinte é se essa discrepância é suficientemente grande para pôr em risco a inferência que queremos fazer.
Podemos repetir a ideia com variâncias. Os dois grupos seguintes diferem apenas moderadamente na dispersão, mas cada um tem 5 000 observações:
| grupo | y |
|---|---|
| A | 0.9927717 |
| B | 1.0908368 |
ggplot(sim_var, aes(x = grupo, y = y)) +
  geom_boxplot(width = 0.5, outlier.alpha = 0.15) +
  theme_classic() +
  labs(x = "Grupo", y = "Valor")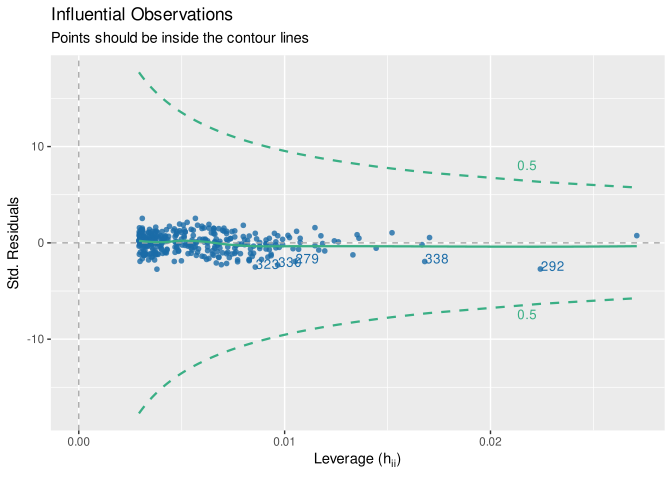
car::leveneTest(y ~ grupo, data = sim_var, center = median)| Df | F value | Pr(>F) | |
|---|---|---|---|
| group | 1 | 33.36999 | 0 |
| 9998 | NA | NA |
Uma diferença pequena pode ser detectável e ainda assim exigir uma pergunta adicional: quanto muda o erro-padrão, o intervalo ou a conclusão substantiva? É por isso que os testes auxiliares vêm depois da pergunta e dos gráficos, não antes deles.
5 Da Evidência ao Próximo Modelo
Forma da Relação
Delineamento/pergunta. Esperamos uma relação aproximadamente linear dentro de cada espécie, ou há um mecanismo que sugira curvatura, patamar ou limiar?
Consequência possível. Se a média condicional estiver mal especificada, os resíduos guardam um padrão sistemático e o declive resume mal a relação.
Evidência diagnóstica. No gráfico de resíduos contra valores ajustados, procuramos curvatura. No gráfico bruto, comparamos essa indicação com a estrutura por grupo. Uma curva loess é uma ajuda visual, não a verdadeira forma da natureza.
diagnostico <- data.frame(
  ajustado = fitted(modelo),
  residuo = rstandard(modelo)
)

ggplot(diagnostico, aes(x = ajustado, y = residuo)) +
  geom_point(alpha = 0.55) +
  geom_hline(yintercept = 0, linetype = "dashed") +
  geom_smooth(method = "loess", se = FALSE, colour = "firebrick") +
  theme_classic() +
  labs(x = "Valor ajustado", y = "Resíduo padronizado")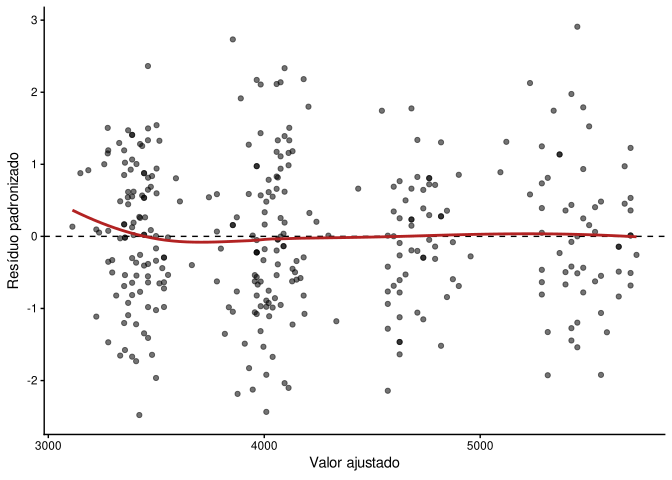
Triangulação. Se houver curvatura sustentada pelo mecanismo e pelos dados, modele-a. Por exemplo, um termo quadrático é uma hipótese específica, não decoração:
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 326 | 28212325 | NA | NA | NA | NA |
| 323 | 27993690 | 3 | 218635 | 0.840893 | 0.4722696 |
Compare previsões e incerteza, não apenas o valor-p da comparação. Se a resposta for uma contagem ou proporção, uma família e uma função de ligação adequadas podem ser mais naturais do que curvar uma regressão Gaussiana; veja o tutorial seguinte.
Variância Não Constante
Delineamento/pergunta. Grupos ou níveis de previsão podem ter dispersões diferentes por razões reais: animais maiores podem variar mais em gramas, por exemplo.
Consequência possível. Sob heterocedasticidade, os erros-padrão OLS usuais podem não representar bem a incerteza, mesmo quando os coeficientes descrevem uma relação média útil.
Evidência diagnóstica. Comece pelo gráfico de escala–localização abaixo: procure um funil ou diferenças sistemáticas de dispersão. Se a questão for especificamente a igualdade de variâncias entre grupos, o exemplo Levene/Brown–Forsythe acima mostra como pedir o teste formal. O teste responde apenas à comparação de grupos que lhe damos. Não é um diagnóstico geral do modelo.
ggplot(diagnostico, aes(x = ajustado, y = sqrt(abs(residuo)))) +
  geom_point(alpha = 0.55) +
  geom_smooth(method = "loess", se = FALSE, colour = "firebrick") +
  theme_classic() +
  labs(x = "Valor ajustado", y = expression(sqrt("|resíduo padronizado|")))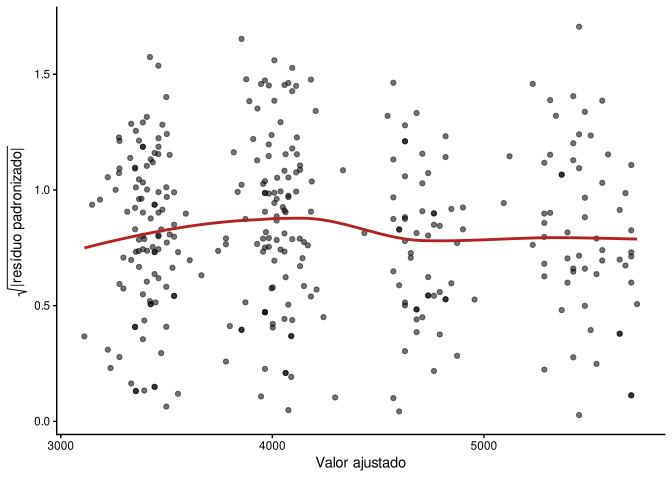
Triangulação. Se a relação média continuar plausível, podemos manter os coeficientes OLS e calcular uma matriz de covariância consistente com heterocedasticidade. O exemplo usa HC3 explicitamente. Long e Ervin (2000) mostram por simulação por que esta variante é preferível a HC0 em amostras pequenas e, sobretudo, por que a decisão de usar erros-padrão robustos não deve depender de um teste preliminar de heterocedasticidade.
t test of coefficients:

                                     Estimate Std. Error t value  Pr(>|t|)
(Intercept)                          -60.0183   687.8985 -0.0872   0.93053
flipper_length_mm                     18.4395     3.6465  5.0568 7.127e-07 ***
speciesChinstrap                     927.8374  1276.8213  0.7267   0.46794
speciesGentoo                      -1066.4650  1071.6534 -0.9952   0.32040
sexmale                              521.5581    39.3707 13.2474 < 2.2e-16 ***
flipper_length_mm:speciesChinstrap    -5.1393     6.5602 -0.7834   0.43396
flipper_length_mm:speciesGentoo        8.9573     5.1972  1.7235   0.08575 .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Isto altera a estimativa da incerteza, não corrige dependência, curvatura ou uma distribuição de resposta mal escolhida. A ideia de matrizes de covariância consistentes com heterocedasticidade tem uma referência clássica em White (1980).
Num delineamento de um factor entre grupos, a ANOVA de Welch (oneway.test(y ~ grupo, var.equal = FALSE)) é outra alternativa conhecida para variâncias desiguais. Não é uma solução geral para interacções, covariáveis ou medidas repetidas.
Forma dos Resíduos
Delineamento/modelo. A normalidade relevante num modelo Gaussiano é a dos erros condicionais, não a de cada variável bruta.
Consequência possível. Assimetria forte, caudas pesadas e poucos casos podem tornar intervalos e testes baseados na aproximação normal/t inadequados. Um desvio do Q–Q plot não demonstra, sozinho, que o coeficiente está enviesado.
Evidência diagnóstica. O Q–Q plot mostra onde os quantis residuais se afastam dos quantis normais.
ggplot(diagnostico, aes(sample = residuo)) +
  stat_qq() +
  stat_qq_line(colour = "firebrick") +
  theme_classic() +
  labs(x = "Quantis teóricos", y = "Quantis dos resíduos")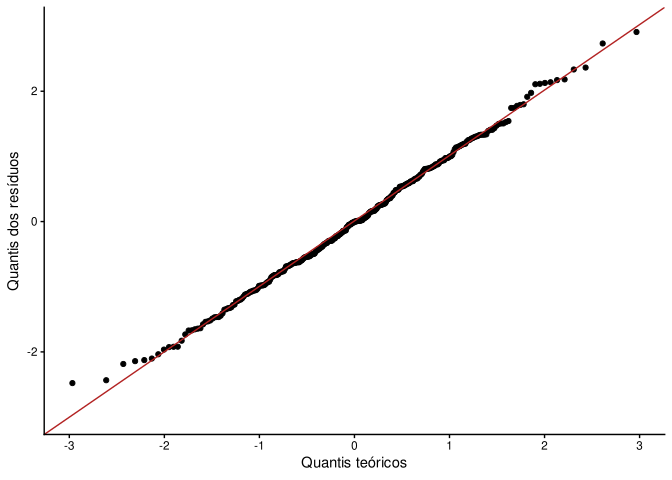
Para a sintaxe de Shapiro–Wilk e Lilliefors e para a demonstração do efeito de uma amostra grande, volte a Testes Clássicos: Saber Usá-los.
Triangulação. Podemos usar intervalos por bootstrap que respeitem o delineamento, um modelo para outra distribuição, ou um estimador robusto adequado ao tipo de contaminação. Cada opção acrescenta pressupostos. Nenhuma é «sem pressupostos».
Outliers e Observações Influentes
Um outlier não é uma única coisa. Uma observação pode ser extrema numa variável, invulgar apenas quando várias variáveis são consideradas em conjunto, ou especialmente influente para um modelo concreto. Estas definições podem assinalar linhas diferentes.
ImportanteLeitura Fortemente Recomendada
A vignette oficial Checking outliers with performance é uma das melhores introduções práticas a este problema. Discute métodos univariados, multivariados e baseados no modelo, alternativas robustas, limiares, visualização, triangulação e o que fazer depois de encontrar uma observação invulgar.
Não memorize apenas um limiar de Cook ou um z-score: leia a discussão antes de definir uma regra de exclusão para um estudo real.
Outlier Univariado
Se a pergunta é simplesmente «há valores excepcionalmente afastados nesta variável?», podemos usar um método univariado robusto. O z-score robusto do performance usa mediana e MAD em vez de média e desvio-padrão:
out_uni <- dados$body_mass_g |>
  check_outliers(method = "zscore_robust")

out_uni
OK: No outliers detected.
- Based on the following method and threshold: zscore_robust (3.291).
- For variable: dados$body_mass_gout_uni |> plot()$threshold_outliers
integer(0)
$threshold
[1] 3.290527
$elbow_outliers
[1] 164
$elbow_threshold
[1] 0.2810378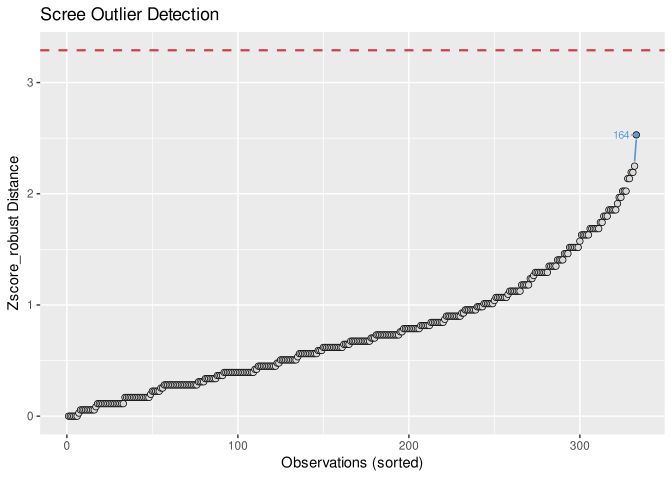
Isto diz-nos algo sobre massa corporal, não sobre influência no modelo.
Outlier Multivariado
Uma observação pode não ser extrema em nenhuma variável isoladamente e, ainda assim, ser invulgar na combinação entre variáveis. Para duas variáveis quantitativas do exemplo:
dados_quant <- dados[c("body_mass_g", "flipper_length_mm")]

out_multi <- dados_quant |>
  check_outliers(method = "mcd")

out_multi
1 outlier detected: case 35.
- Based on the following method and threshold: mcd (13.816).
- For variables: body_mass_g, flipper_length_mm.out_multi |> plot()$threshold_outliers
[1] 35
$threshold
[1] 13.81551
$elbow_outliers
[1] 35
$elbow_threshold
[1] 3.029446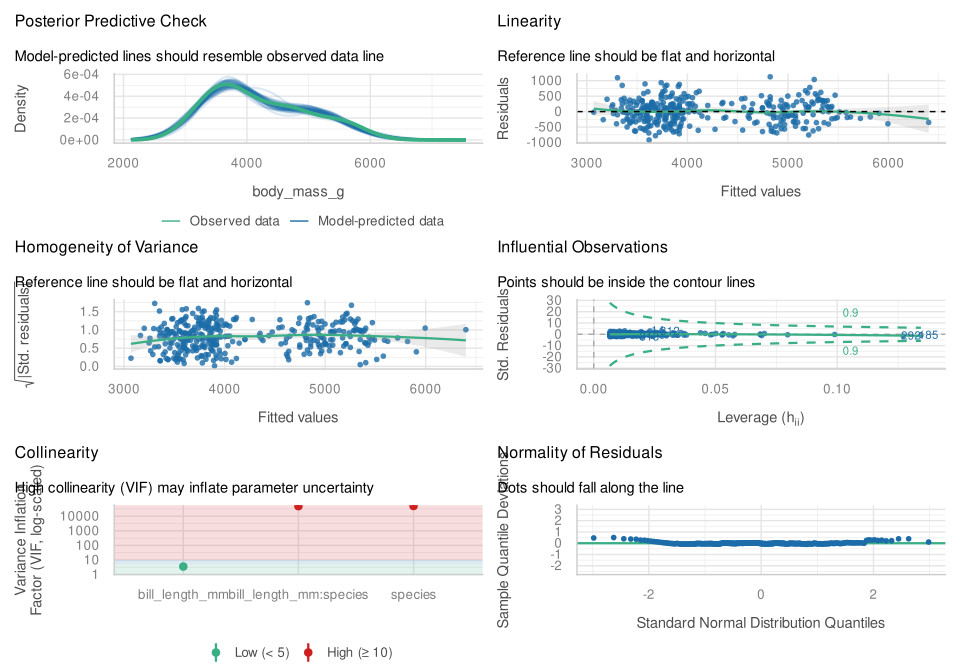
method = "mcd" usa Minimum Covariance Determinant, uma alternativa robusta à distância de Mahalanobis clássica. Em problemas multidimensionais, esta distinção importa porque a própria média e a matriz de covariância podem ser puxadas pelas observações que tentamos detectar.
Influência no Modelo
Para uma regressão, muitas vezes interessa mais saber se uma observação muda substancialmente o ajuste do que saber se ela parece extrema marginalmente:
out_modelo <- modelo |>
  check_outliers(method = "cook")

out_modelo
OK: No outliers detected.
- Based on the following method and threshold: cook (0.7).
- For variable: (Whole model)out_modelo |> plot()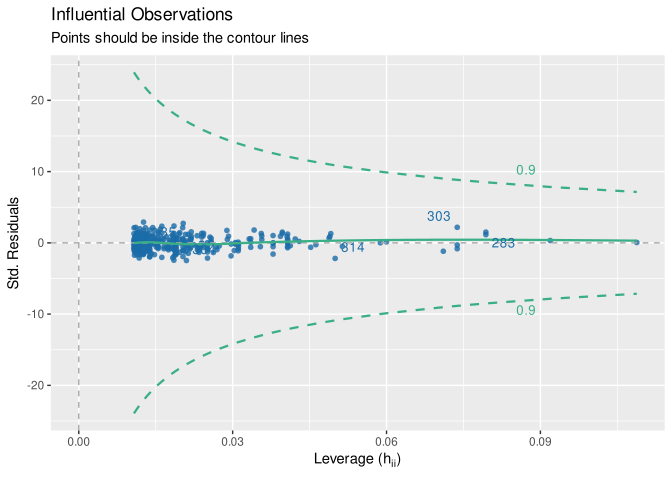
A distância de Cook é dependente do modelo. Um animal muito grande pode ser extremo numa variável e ainda seguir perfeitamente a relação prevista. Outro valor menos espectacular pode ter muita influência porque combina alavancagem elevada com um resíduo grande.
Triangular em Vez de Apagar
Métodos diferentes respondem a perguntas diferentes. Antes de excluir uma linha, compare pelo menos:
- a proveniência da observação — erro verificável ou caso genuíno?;
- uma definição univariada ou multivariada apropriada ao problema;
- a influência no modelo que responde à pergunta científica;
- o gráfico e os valores originais;
- uma triangulação que não dependa da mesma decisão de exclusão.
Podemos ver rapidamente se os métodos estão a apontar para as mesmas linhas:
Não esperamos necessariamente listas idênticas. A discordância é informação sobre que sentido de «invulgar» cada método está a detectar.
Se quisermos saber quanto os casos influentes afectam a conclusão, podemos triangular a conclusão sem transformar a exclusão numa regra automática:
indices_cook <- which(out_modelo)
dados_modelo <- model.frame(modelo)

if (length(indices_cook) > 0) {
  modelo_sem_cook <- dados_modelo[-indices_cook, , drop = FALSE] |>
    lm(body_mass_g ~ flipper_length_mm * species + sex, data = _)

  coef(modelo_sem_cook)
}
E podemos comparar com um modelo robusto:
library(robustbase)

modelo_robusto <- dados |>
  lmrob(body_mass_g ~ flipper_length_mm * species + sex, data = _)

coef(modelo_robusto)
(Intercept) flipper_length_mm
-73.685743 18.508421
speciesChinstrap speciesGentoo
1298.964173 -1032.932530
sexmale flipper_length_mm:speciesChinstrap
511.466756 -6.977337
flipper_length_mm:speciesGentoo
8.798078 Métodos robustos não funcionam todos da mesma forma. Em lmrob(), observações com grande influência podem receber menos peso no ajuste. Outros métodos usam trimming: ordenam os valores e excluem uma proporção definida de cada cauda do cálculo da média aparada. Nesse caso, as observações extremas deixam mesmo de contribuir para essa estimativa de localização.
Isso não significa que essas linhas tenham sido diagnosticadas como «erros» ou apagadas do conjunto de dados. A exclusão das caudas faz parte da definição do estimando robusto. Por isso, é útil distinguir detectar observações invulgares de usar um estimador que reduz ou elimina a contribuição das caudas.
Se OLS, uma análise sem casos muito influentes, um estimador robusto e, quando apropriado, uma análise baseada em médias aparadas contam a mesma história substantiva, ganhamos confiança por triangulação. Se divergirem, a divergência merece investigação e relato.
Preditores que Contam Quase a Mesma História
Delineamento/pergunta. Em dados observacionais, ansiedade e confiança, ou tamanho e idade, podem conter informação muito sobreposta. Num delineamento experimental equilibrado isto pode ser controlado, mas não é automaticamente «garantido» por qualquer experiência.
Consequência possível. O modelo pode prever razoavelmente enquanto os coeficientes parciais ficam imprecisos, mudam de sinal ou variam muito quando se acrescenta outro preditor. Isto é um problema da informação disponível, não uma falha moral das variáveis.
Evidência diagnóstica. Examine correlações, o delineamento e a incerteza dos coeficientes. check_collinearity() apresenta diagnósticos baseados em VIF. Limiares universais como «VIF < 5 = aprovado» escondem o contexto.
check_collinearity(modelo)| Term | VIF | VIF_CI_low | VIF_CI_high | SE_factor | Tolerance | Tolerance_CI_low | Tolerance_CI_high |
|---|---|---|---|---|---|---|---|
| flipper_length_mm | 1.139311e+01 | 9.351064e+00 | 1.393448e+01 | 3.375368 | 0.0877724 | 0.0717644 | 0.1069397 |
| species | 8.270843e+05 | 6.712849e+05 | 1.019043e+06 | 30.156952 | 0.0000012 | 0.0000010 | 0.0000015 |
| sex | 1.399566e+00 | 1.249758e+00 | 1.639232e+00 | 1.183033 | 0.7145070 | 0.6100418 | 0.8001549 |
| flipper_length_mm:species | 9.042724e+05 | 7.339330e+05 | 1.114146e+06 | 950.932366 | 0.0000011 | 0.0000009 | 0.0000014 |
Triangulação. Recolha dados que separem os preditores, pré-especifique o contraste relevante, combine medidas apenas com justificação teórica ou use regularização se o objectivo for previsão. Retirar automaticamente a variável com maior VIF pode mudar a pergunta e introduzir viés por omissão.
6 Esfericidade: Um Caso Específico
A esfericidade pertence à ANOVA clássica com factores intra-sujeitos com mais de dois níveis. Não é um requisito genérico de todos os modelos lineares nem de todos os modelos mistos. A secção teórica sobre esfericidade explica que a hipótese diz respeito às relações entre diferenças repetidas. A correcção de Greenhouse–Geisser ajusta os graus de liberdade da ANOVA. Não torna independentes observações que foram tratadas como pessoas diferentes.
O afex pode apresentar ANOVAs de medidas repetidas com correcções de esfericidade. A identificação da pessoa e a especificação do que se repete continuam a vir primeiro. Siga o fluxo de medidas repetidas.
7 Transformações e «Não-Paramétricos»: Nomes a Reconhecer
Transformações
Encontrará transformação logarítmica, raiz quadrada, recíproca e Box–Cox como respostas clássicas à assimetria ou a relações entre média e variância. Podem ser escolhas sensatas quando:
- a escala transformada corresponde ao mecanismo (por exemplo, efeitos multiplicativos);
- melhora uma forma funcional específica;
- o alvo científico pode ser interpretado nessa escala.
Mas log(Y) não é um detergente para qualquer Q–Q plot. Muda a pergunta e a interpretação: diferenças na escala logarítmica correspondem a razões após a retrotransformação. Zeros e valores negativos exigem ainda atenção. Somar uma constante arbitrária também altera o significado.
Antes de transformar por reflexo, pergunte se uma distribuição apropriada para \(Y\) — binomial para sucessos em tentativas, Poisson ou binomial negativa para certas contagens — descreve melhor o processo.
Testes Não-Paramétricos
Também encontrará estes nomes convencionais:
- Mann–Whitney/Wilcoxon rank-sum para dois grupos independentes;
- Wilcoxon signed-rank para dados emparelhados;
- Kruskal–Wallis para mais de dois grupos independentes;
- Friedman para blocos ou medidas repetidas.
«Não-paramétrico» não significa «sem pressupostos», nem estes testes são versões de emergência de uma ANOVA para qualquer delineamento. Testes baseados em postos respondem a hipóteses sobre distribuições/postos. Interpretações simples como diferenças de localização requerem condições adicionais. Também não resolvem dependência ignorada, confundimento, interacções ou uma unidade de análise errada.
Testes de permutação são outra família: a permutação tem de respeitar a permutabilidade criada pelo delineamento. Num estudo emparelhado não baralhamos observações como se todos os participantes fossem independentes.
NotaAlternativas Robustas com
WRS2
Se uma conclusão parecer demasiado dependente de caudas ou observações extremas, compare-a com uma alternativa robusta pré-especificada:
WRS2::yuen(y ~ grupo, data = dados)      # dois grupos independentes
WRS2::yuenbt(y ~ grupo, data = dados)    # versão bootstrap
WRS2::t1way(y ~ grupo, data = dados)     # um factor
WRS2::t2way(y ~ A * B, data = dados)     # factorial
WRS2::bwtrim(y ~ entre * intra,
             id = participante,
             data = dados)               # entre × intra
Estas funções não são simplesmente versões «mais seguras» dos testes clássicos: podem mudar o estimador e a forma de calcular a incerteza. A teoria está em Estatística Robusta. Aqui interessa sobretudo saber qual alternativa executar e comparar.
8 Triangular a Conclusão
Para este exemplo, podemos colocar lado a lado três perguntas:
- OLS: quais são os coeficientes da relação média sob o modelo linear?
- HC3: a conclusão inferencial muda se permitirmos heterocedasticidade na matriz de covariância?
- Regressão robusta: os coeficientes mudam quando limitamos a influência de observações extremas?
resultado_ols <- coef(summary(modelo))[, c("Estimate", "Std. Error")]
resultado_hc3 <- coeftest(modelo, vcov. = vcovHC(modelo, type = "HC3"))[
  , c("Estimate", "Std. Error")
]
resultado_robusto <- coef(summary(modelo_robusto))[
  , c("Estimate", "Std. Error")
]

comparacao <- data.frame(
  termo = rownames(resultado_ols),
  estimativa_ols = resultado_ols[, "Estimate"],
  ep_ols = resultado_ols[, "Std. Error"],
  ep_hc3 = resultado_hc3[, "Std. Error"],
  estimativa_robusta = resultado_robusto[, "Estimate"],
  ep_robusto = resultado_robusto[, "Std. Error"],
  row.names = NULL
)
comparacao| termo | estimativa_ols | ep_ols | ep_hc3 | estimativa_robusta | ep_robusto |
|---|---|---|---|---|---|
| (Intercept) | -60.018250 | 734.674405 | 687.898543 | -73.685743 | 678.436898 |
| flipper_length_mm | 18.439522 | 3.888176 | 3.646473 | 18.508421 | 3.595754 |
| speciesChinstrap | 927.837401 | 1222.337807 | 1276.821349 | 1298.964174 | 1250.238739 |
| speciesGentoo | -1066.464981 | 1165.273198 | 1071.653397 | -1032.932530 | 1087.075198 |
| sexmale | 521.558116 | 38.144585 | 39.370666 | 511.466756 | 41.152186 |
| flipper_length_mm:speciesChinstrap | -5.139332 | 6.300005 | 6.560205 | -6.977337 | 6.420916 |
| flipper_length_mm:speciesGentoo | 8.957347 | 5.637485 | 5.197186 | 8.798078 | 5.258496 |
Não resuma esta tabela a «significativo/não significativo». Procure mudanças na direcção e magnitude das estimativas, na incerteza e nas previsões relevantes. Se as respostas divergem, investigue porquê e reporte a divergência. Não escolha retrospectivamente a versão com o valor-p mais simpático.
DicaO Relatório Curto que Gostaríamos de Ler
Descreva (1) a unidade de observação e dependências consideradas, (2) o modelo principal e a razão para a sua forma, (3) o padrão diagnóstico relevante e (4) o que mudou — ou não — numa alternativa justificada. Mostre gráficos ou estimativas suficientes para que o leitor não tenha de confiar na frase «todos os pressupostos foram cumpridos».
9 Mapa de Decisão
| Delineamento ou padrão | Consequência a avaliar | Evidência | Próximo passo possível |
|---|---|---|---|
| repetições/agrupamento | incerteza e unidade de análise erradas | protocolo, IDs, estrutura temporal/espacial | modelo misto, GEE, séries temporais ou agregação justificada |
| resposta limitada, contagem ou proporção | média/variância incompatíveis com Gaussiano | suporte de \(Y\), gráfico e mecanismo | GLM com família e ligação adequadas |
| curvatura residual | relação média mal especificada | dados brutos + resíduos | termo não-linear ou modelo mecanístico |
| variância residual desigual | EP e intervalos OLS inadequados | resíduos vs. ajustados/grupo | HC3, modelo da variância, Welch no caso simples |
| caudas/pontos influentes | estimativas ou inferência instáveis | Q–Q, Cook, proveniência do caso | corrigir erro; bootstrap; modelo robusto; triangulação |
| preditores sobrepostos | efeitos parciais imprecisos | delineamento, correlações, VIF e intervalos | novo delineamento, contraste teórico, regularização para previsão |
Nenhuma linha é uma receita automática. É um convite a explicitar a cadeia problema → consequência → evidência → comparação.
10 Exercícios
Ajuste
lm(body_mass_g ~ flipper_length_mm + species + sex, data = dados). Compare os gráficos de diagnóstico com os do modelo com interacção. Que padrão muda e por que isso é relevante para a pergunta?Escolha uma observação com distância de Cook relativamente alta. Consulte os valores originais e escreva três explicações possíveis: erro, caso genuíno ou população diferente. Que informação externa permitiria decidir?
Compare OLS, HC3 e
lmrob()para um coeficiente escolhido antes de ver os resultados. Comente magnitude e incerteza, não apenas valores-p.Explique por que
log(body_mass_g)mudaria a interpretação do declive. Em que pergunta científica essa transformação poderia fazer sentido?Um investigador mediu dez peixes em cada um de quatro aquários e aplicou Kruskal–Wallis aos 40 peixes. Identifique o problema de delineamento e explique por que a troca de ANOVA por um teste não-paramétrico não o resolve.
Solução 1: Comparar a Forma dos Dois Modelos
No modelo aditivo, todas as espécies são forçadas a partilhar o mesmo declive para flipper_length_mm. Compare sobretudo resíduos contra ajustados e o padrão por espécie nos dados brutos: se a relação variar entre espécies, essa restrição pode deixar estrutura sistemática nos resíduos. A interacção é relevante porque representa uma pergunta sobre a relação média, não uma simples manobra para melhorar um diagnóstico.
Solução 2: Investigar um Caso com Cook Alto
out_modelo <- modelo |>
  check_outliers(method = "cook")

indice_cook <- which.max(cooks.distance(modelo))
dados_modelo <- model.frame(modelo)

dados_modelo[indice_cook, , drop = FALSE]
cooks.distance(modelo)[indice_cook]
A linha pode resultar de um erro de transcrição, de uma observação genuína ou de uma população/processo diferente do que o modelo pretende representar. Para decidir entre estas hipóteses, seria preciso consultar, respectivamente, os registos originais e controlo de qualidade, a documentação da medição e o protocolo/metadados sobre proveniência, local, tempo ou identificação do pinguim. A distância de Cook não decide qual explicação é verdadeira.
Solução 3: OLS, HC3 e Regressão Robusta
Escolhemos flipper_length_mm antes de olhar para os resultados e extraímos a mesma estimativa e incerteza das três análises:
termo <- "flipper_length_mm"

ols <- coef(summary(modelo))[termo, c("Estimate", "Std. Error")]
hc3 <- coeftest(modelo, vcov. = vcovHC(modelo, type = "HC3"))[
  termo, c("Estimate", "Std. Error")
]
robusto <- coef(summary(modelo_robusto))[termo, c("Estimate", "Std. Error")]

rbind(OLS = ols, HC3 = hc3, Robusta = robusto)
Compare a magnitude e a direcção da estimativa OLS com a robusta. Compare o erro-padrão OLS com HC3 para ver o efeito de permitir heterocedasticidade na inferência. Se a história mudar materialmente, investigue os padrões e os casos que produzem a divergência em vez de escolher a versão mais conveniente.
Solução 4: O Que Muda com log(body_mass_g)
Neste modelo, o declive descreve uma mudança aditiva no logaritmo da massa e, na escala original, uma mudança multiplicativa aproximada na massa esperada por milímetro. Poderia fazer sentido se a pergunta e o mecanismo fossem sobre razões ou crescimento proporcional, por exemplo se uma diferença relativa de 10% tivesse o mesmo significado em massas pequenas e grandes. Não é uma transformação automática para obter um Q–Q plot mais recto.
Solução 5: Peixes Agrupados em Aquários
Os 40 peixes não são necessariamente 40 réplicas independentes do tratamento: os peixes do mesmo aquário partilham água, manejo e a condição aplicada ao recipiente. Se o tratamento foi aplicado ao aquário, este é a unidade experimental e os peixes são subamostras. Kruskal–Wallis muda a forma do teste, mas continua a tratar as observações como independentes; por isso não resolve a pseudorreplicação. A análise tem de representar o aquário como agrupamento ou resumir justificadamente ao nível do aquário, lembrando que há apenas quatro unidades experimentais no total.
11 Recursos e Referências
- A documentação oficial de
performancedescreve a famíliacheck_*()e os diagnósticos disponíveis para diferentes modelos. - A vignette Checking model assumption - linear models explica em detalhe os painéis de
check_model()e como interpretar cada um. - A vignette Checking outliers with performance é leitura recomendada para distinguir outliers univariados, multivariados e baseados no modelo e para decidir como os investigar.
- A vignette do
seeparaperformancemostra como desenhar separadamente os objectos devolvidos pelas funçõescheck_*(). - A documentação oficial de
sandwichapresenta estimadores de matrizes de covariância robustas, incluindovcovHC(). - A documentação oficial de
robustbasedocumentalmrob()e os respectivos controlos. - Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18.
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B, 26(2), 211–243.
- Fay, M. P., & Proschan, M. A. (2010). Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules. Statistics Surveys, 4, 1–39.
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38.
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224.
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4).
- Winkler, A. M., Ridgway, G. R., Webster, M. A., Smith, S. M., & Nichols, T. E. (2014). Permutation inference for the general linear model. NeuroImage, 92, 381–397.
12 Conclusão
Pode ter aprendido que primeiro se testam pressupostos e depois se escolhe o teste. Aqui preferimos começar pelo delineamento, perguntar que consequência um desvio teria e confrontar a conclusão com alternativas justificadas.
Diagnósticos não são burocracia, mas também não são um concurso de valores-p. São evidência sobre onde o modelo simplifica demasiado — e, por vezes, sobre algo cientificamente interessante que o ritual teria tentado varrer para debaixo da transformação.