# Run once in the console, not in an analysis script.
install.packages(c("ggplot2", "car", "emmeans", "performance"))GLMs no R: Proporções e Contagens na Prática
Modelos Lineares
GLM
Logística
Poisson
emmeans
Diagnósticos
Fluxos práticos no R para respostas binárias, proporções, contagens e taxas.
0 Preparação
Este é o tutorial prático. A explicação de família, função de ligação, logit, deviance, sobredispersão e offsets está em Modelos Lineares Generalizados. Leia esse capítulo quando precisar de perceber por que o modelo funciona. Aqui vamos praticar como passar dos dados para um GLM e voltar à escala da resposta.
Os exemplos seguem sempre a mesma sequência:
- olhar para a resposta e para os preditores;
- escolher a família a partir do tipo de resposta;
- ajustar o modelo que representa a pergunta;
- obter uma tabela de testes dos efeitos;
- voltar à escala da resposta com previsões e comparações;
- desenhar o padrão e verificar problemas específicos do GLM.
Se fórmulas, factores, contrastes ou interacções ainda forem pouco familiares, reveja primeiro modelos lineares.
Vamos usar dois ficheiros locais: Titanic e manatins. Para executar os exemplos num script, guarde-os numa pasta data e o script numa pasta programming ao lado dela. Use programming como directório de trabalho da consola: os caminhos ../data/... partem daí. No repositório NRB, estas pastas já existem.
1 Escolher a Família
| Resposta | Primeiro modelo | Exemplo |
|---|---|---|
| 0/1 | glm(..., family = binomial) |
sobrevivência no Titanic |
| sucessos em várias tentativas | glm(cbind(successes, failures) ~ ..., family = binomial) |
proporções por grupo |
| contagem 0, 1, 2, … | glm(..., family = poisson) |
mortes de manatins |
| contagem por exposição | Poisson + offset(log(exposure))
|
taxa por unidade de exposição |
Esta tabela é uma cábula para começar. A teoria de GLMs explica quando a relação média–variância, a função de ligação ou a dependência exigem outra escolha.
2 Binomial: Regressão Logística
Vamos modelar a probabilidade de sobrevivência (Survived) no Titanic em função da classe (Pclass) e do sexo (Sex). Comecemos por explorar os nomes e os valores no interpretador, antes de transformar as colunas. No script, guardamos as escolhas de preparação e de análise, com os comentários que explicam por que as fizemos. Podemos também conservar as inspecções que nos seja útil repetir.
 [1] "X"           "PassengerId" "Survived"    "Pclass"      "Name"
 [6] "Sex"         "Age"         "SibSp"       "Parch"       "Ticket"
[11] "Fare" "Cabin" "Embarked" table(ds$Survived, useNA = "ifany")
  0   1
424 290 table(ds$Pclass, ds$Sex, useNA = "ifany")
    female male
  1     85  101
  2     74   99
3 102 253Survived Pclass Sex
0 0 0 Nos nomes devem aparecer Survived, Pclass e Sex. A primeira tabela mostra quantas pessoas morreram (0) e sobreviveram (1); não devemos encontrar outros códigos. A segunda conta as pessoas de cada combinação de classe (1, 2 ou 3) e sexo (female ou male). useNA = "ifany" mostra valores em falta quando existem, e a última linha conta-os em cada coluna. Neste ficheiro, estas três contagens são zero.
Vamos tratar a classe como um factor nominal. Não usamos idade nem preço do bilhete neste modelo, pelo que valores em falta nessas colunas não são motivo para retirar pessoas da análise. Para acompanhar o efeito da selecção de casos completos, contamos as linhas antes e depois:
nrow(ds)[1] 714[1] 714'data.frame': 714 obs. of 3 variables:
$ Survived: int 0 1 1 1 0 0 0 1 1 1 ...
$ Pclass : Factor w/ 3 levels "class1","class2",..: 3 1 3 1 3 1 3 3 2 3 ...
$ Sex : Factor w/ 2 levels "female","male": 2 1 1 1 2 2 2 1 1 1 ...head(ds)| X | PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 1 | 0 | class3 | Braund, Mr. Owen Harris | male | 22 | 1 | 0 | A/5 21171 | 7.2500 | S | |
| 2 | 2 | 1 | class1 | Cumings, Mrs. John Bradley (Florence Briggs Thayer) | female | 38 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 3 | 3 | 1 | class3 | Heikkinen, Miss. Laina | female | 26 | 0 | 0 | STON/O2. 3101282 | 7.9250 | S | |
| 4 | 4 | 1 | class1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35 | 1 | 0 | 113803 | 53.1000 | C123 | S |
| 5 | 5 | 0 | class3 | Allen, Mr. William Henry | male | 35 | 0 | 0 | 373450 | 8.0500 | S | |
| 7 | 7 | 0 | class1 | McCarthy, Mr. Timothy J | male | 54 | 0 | 0 | 17463 | 51.8625 | E46 | S |
Aqui não perdemos linhas. Na estrutura, Pclass e Sex devem aparecer como factores, enquanto Survived conserva a codificação numérica 0/1.
Ver os Dados
Como Survived está codificado 0/1, a média em cada célula é a proporção observada de sobreviventes.
observed_survival <- aggregate(
  Survived ~ Pclass + Sex,
  data = ds,
  FUN = mean
)

observed_survival| Pclass | Sex | Survived |
|---|---|---|
| class1 | female | 0.9647059 |
| class2 | female | 0.9189189 |
| class3 | female | 0.4607843 |
| class1 | male | 0.3960396 |
| class2 | male | 0.1515152 |
| class3 | male | 0.1501976 |
ggplot(
  observed_survival,
  aes(x = Pclass, y = Survived, shape = Sex, group = Sex)
) +
  geom_point(size = 2.5) +
  geom_line() +
  theme_classic() +
  labs(
    x = "Class",
    y = "Observed proportion of survivors",
    shape = "Sex"
  )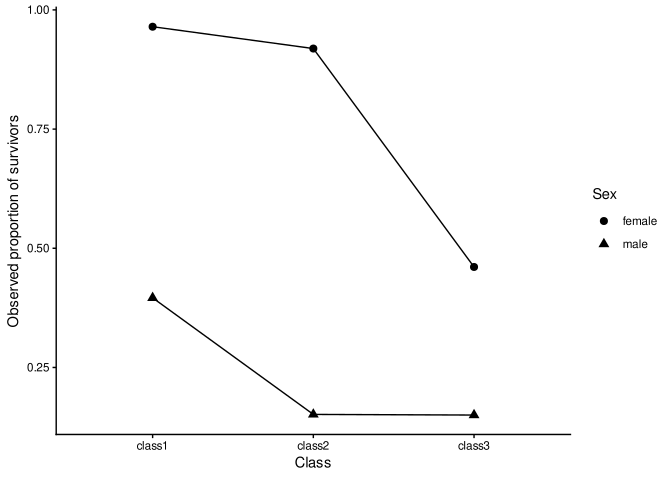
Antes de olhar para valores-p, já sabemos que o modelo tem de representar diferenças entre classes, entre sexos e a possibilidade de a diferença entre sexos mudar de classe para classe.
Ajustar o Modelo
Ajustamos directamente o modelo factorial que corresponde à pergunta. Como vamos pedir testes Tipo III, definimos contrastes de soma nos factores.
Testar Todos os Efeitos
Para um glm, car::Anova() pode produzir testes qui-quadrado de razão de verosimilhanças. Esta é a tabela que queremos no fluxo principal:
car::Anova(m_log, type = 3)| LR Chisq | Df | Pr(>Chisq) | |
|---|---|---|---|
| Pclass | 92.34621 | 2 | 0e+00 |
| Sex | 223.13415 | 1 | 0e+00 |
| Pclass:Sex | 30.15567 | 2 | 3e-07 |
A tabela testa Pclass, Sex e Pclass:Sex no mesmo modelo. Não precisamos de ajustar primeiro um modelo só com efeitos principais apenas para obter o teste da interacção.
Os contrastes importam para testes Tipo III. Aqui ficam especificados no próprio modelo, sem alterar as opções globais da sessão. A justificação conceptual para Tipo III e a relação com modelos restritos estão no capítulo teórico de comparação de modelos.
NotaQue Perguntas Correspondem aos Termos?
-
Pclass: diferenças entre classes, resumidas sobre os sexos segundo o modelo e a codificação. -
Sex: diferenças entre sexos, resumidas sobre as classes. -
Pclass:Sex: se a diferença entre sexos varia com a classe.
Se a interacção for importante, estas médias globais deixam de contar a história toda. Nesse caso interessa sobretudo comparar classes dentro de cada sexo e sexos dentro de cada classe. Para a geometria e interpretação de interacções entre factores, veja interacção entre dois factores.
NotaReconhecer Coeficientes em Log-Odds
summary(m_log) apresenta coeficientes na escala logit. Para os exponenciar:
summary(m_log)
Call:
glm(formula = Survived ~ Pclass * Sex, family = binomial(link = "logit"),
    data = ds, contrasts = list(Pclass = "contr.sum", Sex = "contr.sum"))

Coefficients:
             Estimate Std. Error z value Pr(>|z|)
(Intercept)   0.28348    0.14112   2.009   0.0446 *
Pclass1       1.15958    0.22831   5.079 3.79e-07 ***
Pclass2       0.06901    0.20390   0.338   0.7350
Sex1          1.57608    0.14112  11.169  < 2e-16 ***
Pclass1:Sex1  0.28897    0.22831   1.266   0.2056
Pclass2:Sex1  0.49918    0.20390   2.448   0.0144 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 964.52  on 713  degrees of freedom
Residual deviance: 642.28  on 708  degrees of freedom
AIC: 654.28

Number of Fisher Scoring iterations: 5 (Intercept) Pclass1 Pclass2 Sex1 Pclass1:Sex1 Pclass2:Sex1
1.327737 3.188594 1.071452 4.835963 1.335052 1.647365 Para os coeficientes dos preditores, a exponencial dá uma razão de odds por unidade adicional na respectiva coluna do modelo. Repare no que acontece com contr.sum: num factor com dois níveis +1/-1, passar de um nível ao outro é uma mudança de duas unidades. A exponencial do coeficiente não dá, portanto, a comparação completa, como explicamos na interpretação das odds. Com interacções, temos ainda de incluir os termos de interacção na comparação. Por isso, para comunicar o padrão factorial, vamos usar probabilidades previstas e comparações de emmeans.
emmeans: Probabilidades e Comparações
Para comunicar o padrão é normalmente mais fácil voltar à escala da probabilidade. emmeans(..., type = "response") apresenta as médias marginais como probabilidades previstas. Os contrastes continuam a ser calculados na escala linear do modelo. Quando também os pedimos com type = "response", numa logística aparecem como odds ratios. Assim evitamos obrigar o leitor a interpretar log-odds quando a probabilidade ou a razão de odds responde melhor à pergunta.
$`emmeans of Pclass`
 Pclass  prob     SE  df asymp.LCL asymp.UCL
 class1 0.809 0.0480 Inf     0.697     0.886
 class2 0.587 0.0618 Inf     0.463     0.701
 class3 0.280 0.0267 Inf     0.231     0.335

Results are averaged over the levels of: Sex
Confidence level used: 0.95
Intervals are back-transformed from the logit scale

$`pairwise differences of Pclass`
 1               odds.ratio   SE  df null z.ratio p.value
 class1 / class2       2.98 1.20 Inf    1   2.713  0.0183
 class1 / class3      10.89 3.68 Inf    1   7.066 <0.0001
 class2 / class3       3.66 1.05 Inf    1   4.515 <0.0001

Results are averaged over the levels of: Sex
P value adjustment: tukey method for comparing a family of 3 estimates
Tests are performed on the log odds ratio scale

$`emmeans of Sex`
 Sex     prob     SE  df asymp.LCL asymp.UCL
 female 0.865 0.0292 Inf     0.797     0.913
 male   0.215 0.0219 Inf     0.176     0.261

Results are averaged over the levels of: Pclass
Confidence level used: 0.95
Intervals are back-transformed from the logit scale

$`emmeans of Pclass | Sex`
Sex = female:
 Pclass  prob     SE  df asymp.LCL asymp.UCL
 class1 0.965 0.0200 Inf    0.8963     0.989
 class2 0.919 0.0317 Inf    0.8310     0.963
 class3 0.461 0.0494 Inf    0.3667     0.558

Sex = male:
 Pclass  prob     SE  df asymp.LCL asymp.UCL
 class1 0.396 0.0487 Inf    0.3056     0.494
 class2 0.152 0.0360 Inf    0.0935     0.236
 class3 0.150 0.0225 Inf    0.1113     0.200

Confidence level used: 0.95
Intervals are back-transformed from the logit scale

$`pairwise differences of Pclass | Sex`
Sex = female:
 2               odds.ratio     SE  df null z.ratio p.value
 class1 / class2       2.41  1.750 Inf    1   1.213  0.4453
 class1 / class3      31.99 19.800 Inf    1   5.588 <0.0001
 class2 / class3      13.26  6.230 Inf    1   5.501 <0.0001

Sex = male:
 2               odds.ratio     SE  df null z.ratio p.value
 class1 / class2       3.67  1.270 Inf    1   3.756  0.0005
 class1 / class3       3.71  0.998 Inf    1   4.874 <0.0001
 class2 / class3       1.01  0.334 Inf    1   0.031  0.9995

P value adjustment: tukey method for comparing a family of 3 estimates
Tests are performed on the log odds ratio scale

$`emmeans of Sex | Pclass`
Pclass = class1:
 Sex     prob     SE  df asymp.LCL asymp.UCL
 female 0.965 0.0200 Inf    0.8963     0.989
 male   0.396 0.0487 Inf    0.3056     0.494

Pclass = class2:
 Sex     prob     SE  df asymp.LCL asymp.UCL
 female 0.919 0.0317 Inf    0.8310     0.963
 male   0.152 0.0360 Inf    0.0935     0.236

Pclass = class3:
 Sex     prob     SE  df asymp.LCL asymp.UCL
 female 0.461 0.0494 Inf    0.3667     0.558
 male   0.150 0.0225 Inf    0.1113     0.200

Confidence level used: 0.95
Intervals are back-transformed from the logit scale

$`pairwise differences of Sex | Pclass`
Pclass = class1:
 2             odds.ratio    SE  df null z.ratio p.value
 female / male      41.68 25.90 Inf    1   6.000 <0.0001

Pclass = class2:
 2             odds.ratio    SE  df null z.ratio p.value
 female / male      63.47 32.40 Inf    1   8.141 <0.0001

Pclass = class3:
 2             odds.ratio    SE  df null z.ratio p.value
 female / male       4.83  1.28 Inf    1   5.938 <0.0001

Tests are performed on the log odds ratio scale
Ao escrever os resultados, diga se está a comunicar probabilidades previstas, diferenças na escala logit ou odds ratios. São maneiras diferentes de olhar para o mesmo modelo, mas não são números intercambiáveis.
Ver a Interacção
emm_cells <- emmeans(m_log, ~ Pclass * Sex, type = "response")
emm_df <- as.data.frame(emm_cells)

# The probability column is usually `prob`; intervals are `asymp.LCL` and `asymp.UCL`.
ggplot(emm_df, aes(x = Pclass, y = prob, colour = Sex, group = Sex)) +
  geom_point(size = 2) +
  geom_errorbar(aes(ymin = asymp.LCL, ymax = asymp.UCL), width = 0.15) +
  geom_line() +
  theme_classic() +
  labs(x = "Class", y = "P(Survival)")
O gráfico ajuda a ver se as diferenças entre sexos parecem semelhantes entre classes e mostra a incerteza das probabilidades previstas. Para a geometria e interpretação de interacções entre factores, veja interacção entre dois factores. Não transforma, por si só, esta associação observacional numa explicação causal.
Diagnósticos
Numa regressão logística não esperamos resíduos normais. Por isso não vale a pena aplicar mecanicamente a lista de verificações do lm(). Os problemas relevantes incluem, entre outros:
- forma funcional inadequada para preditores quantitativos;
- separação completa ou quase completa;
- dispersão adicional em dados binomiais agregados;
- observações muito influentes;
- dependência que o modelo não representou.
performance::check_model(m_log)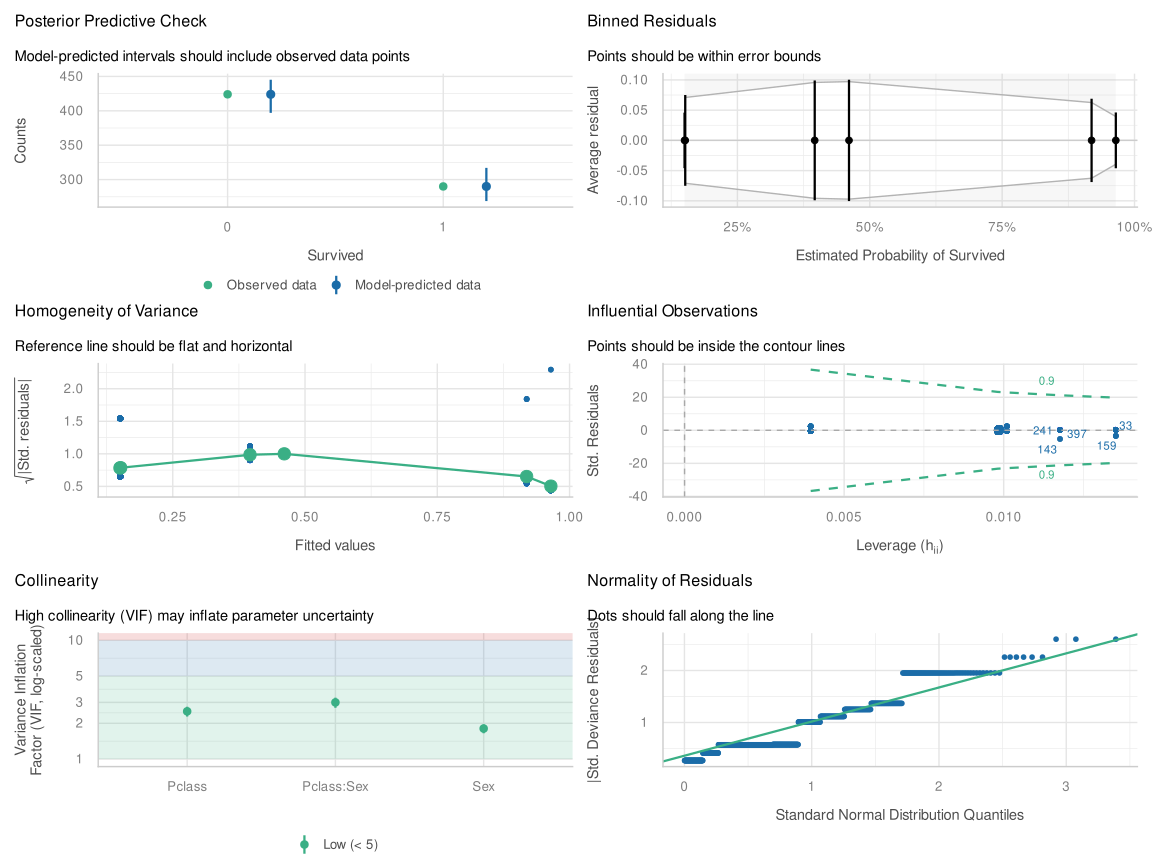
Use estes diagnósticos como pistas sobre o modelo, não como uma tabela de «passou/falhou». Veja diagnóstico em GLMs e, para retomar o papel do termo de erro na inferência, a secção teórica sobre inferência. Para dados que partilham unidades, veja dependência entre observações.
3 Binomial com Proporções
Agora cada linha resume várias tentativas. Neste exemplo hipotético, temos três grupos com 40 organismos cada e números diferentes de sucessos. Assumimos organismos independentes, com a mesma probabilidade de sucesso dentro de cada grupo. Se os 40 organismos partilhassem um único tanque por condição, não teríamos 40 réplicas independentes do tratamento. Agregar as respostas em cbind(successes, failures) não elimina essa dependência.
dat_prop <- data.frame(
  group = factor(c("A", "B", "C")),
  successes = c(12, 20, 28),
  total = c(40, 40, 40)
)

dat_prop$failures <- dat_prop$total - dat_prop$successes
dat_prop$proportion <- dat_prop$successes / dat_prop$total

dat_prop| group | successes | total | failures | proportion |
|---|---|---|---|---|
| A | 12 | 40 | 28 | 0.3 |
| B | 20 | 40 | 20 | 0.5 |
| C | 28 | 40 | 12 | 0.7 |
Ver as Proporções
ggplot(dat_prop, aes(x = group, y = proportion)) +
  geom_point(size = 3) +
  ylim(0, 1) +
  theme_classic() +
  labs(x = "Group", y = "Observed proportion of successes")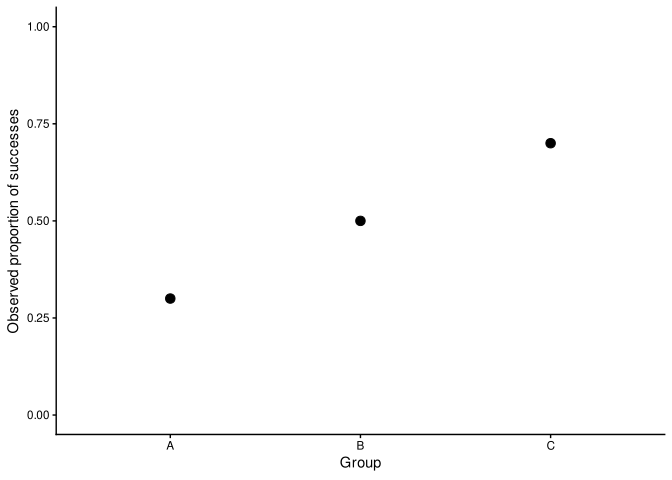
Ajustar e Testar
cbind(successes, failures) informa o modelo de quantas tentativas estão por trás de cada proporção.
| LR Chisq | Df | Pr(>Chisq) | |
|---|---|---|---|
| group | 13.16526 | 2 | 0.0013842 |
Uma proporção de .70 baseada em 7/10 e outra baseada em 700/1000 têm o mesmo valor observado, mas não a mesma precisão. É por isso que não analisamos apenas a coluna proportion.
Aqui estimamos uma probabilidade para cada uma das três linhas. O modelo é saturado, sem graus de liberdade residuais para avaliar sobredispersão. Os testes e intervalos dependem da hipótese binomial que acabámos de explicitar.
Probabilidades e Comparações
emm_prop <- emmeans(m_prop, ~ group, type = "response")
emm_prop group prob SE df asymp.LCL asymp.UCL
A 0.3 0.0725 Inf 0.179 0.457
B 0.5 0.0791 Inf 0.350 0.650
C 0.7 0.0725 Inf 0.543 0.821
Confidence level used: 0.95
Intervals are back-transformed from the logit scale | contrast | odds.ratio | SE | df | null | z.ratio | p.value |
|---|---|---|---|---|---|---|
| A / B | 0.4285714 | 0.2005822 | Inf | 1 | -1.810368 | 0.1661361 |
| A / C | 0.1836735 | 0.0896235 | Inf | 1 | -3.472888 | 0.0014938 |
| B / C | 0.4285714 | 0.2005822 | Inf | 1 | -1.810368 | 0.1661361 |
emm_prop_df <- as.data.frame(emm_prop)
ggplot(emm_prop_df, aes(x = group, y = prob)) +
geom_point(size = 2.5) +
geom_errorbar(
aes(ymin = asymp.LCL, ymax = asymp.UCL),
width = 0.12
) +
ylim(0, 1) +
theme_classic() +
labs(x = "Group", y = "Predicted probability")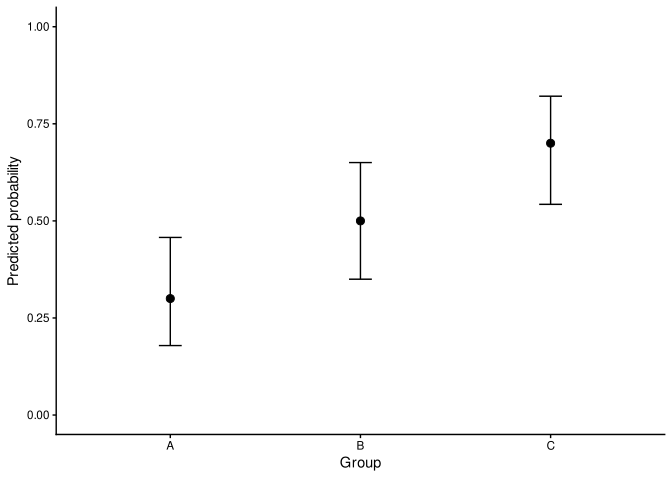
NotaE os Testes Clássicos de Proporções?
binom.test() e prop.test() continuam a responder a perguntas simples sobre proporções. O GLM torna-se especialmente útil quando queremos acrescentar covariáveis, interacções ou manter a mesma linguagem de modelação usada no resto do curso.
4 Poisson: Modelos para Contagens
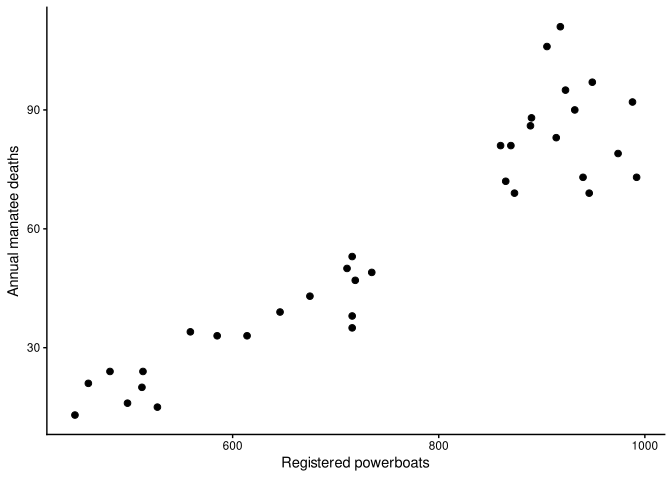
Vamos usar as mortes anuais de manatins (ManateeDeaths) e o número de barcos a motor registados (Powerboats). A pergunta é descritiva: a contagem esperada de mortes varia com o número de barcos registados? Estes dados observacionais não identificam, sozinhos, um efeito causal. Cada linha é um ano (Year), não um organismo. Como os anos estão ordenados no tempo, precisamos de investigar uma possível dependência temporal antes de confiar nos testes e intervalos deste Poisson simples.
| Year | ManateeDeaths | Powerboats |
|---|---|---|
| 1982 | 13 | 447 |
| 1983 | 21 | 460 |
| 1984 | 24 | 481 |
| 1985 | 16 | 498 |
| 1986 | 24 | 513 |
| 1987 | 20 | 512 |
Ver os Dados
ggplot(ds, aes(x = Powerboats, y = ManateeDeaths)) +
geom_point(size = 2) +
theme_classic() +
labs(
x = "Registered powerboats",
y = "Annual manatee deaths"
)
Ajustar e Testar
Call:
glm(formula = ManateeDeaths ~ Powerboats, family = poisson(link = "log"),
data = ds)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) 1.6319121 0.1278815 12.76 <2e-16 ***
Powerboats 0.0030391 0.0001503 20.22 <2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for poisson family taken to be 1)
Null deviance: 543.051 on 34 degrees of freedom
Residual deviance: 66.973 on 33 degrees of freedom
AIC: 272
Number of Fisher Scoring iterations: 4car::Anova(m_pois, type = 3)| LR Chisq | Df | Pr(>Chisq) | |
|---|---|---|---|
| Powerboats | 476.0773 | 1 | 0 |
emmeans() Sem Grupos e o Intercepto
Mergulhar Mais Fundo
Na primeira leitura, podemos seguir para Interpretar o Efeito. Para explorar as previsões e o intercepto, continue abaixo.
Como Powerboats é quantitativo, este exemplo torna mais clara a diferença entre uma estimativa sem grupos e o intercepto.
Primeiro, uma única estimativa na grelha de referência:
emmeans(m_pois, ~ 1, type = "response") 1 rate SE df asymp.LCL asymp.UCL
overall 50.9 1.29 Inf 48.4 53.5
Confidence level used: 0.95
Intervals are back-transformed from the log scale
AvisoAtenção ao
~ 1
~ 1 pede uma única média marginal estimada. Não é uma sintaxe especial para «dar o intercepto». Com covariáveis quantitativas, emmeans usa por defeito os valores da grelha de referência, normalmente as médias das covariáveis. Para obter a previsão correspondente ao intercepto, fixe explicitamente essas covariáveis em zero — ou recentre-as primeiro num zero cientificamente útil.
Por defeito, a covariável quantitativa é avaliada no seu valor médio. O resultado é, portanto, a contagem esperada de mortes no número médio de barcos observado, não a exponencial do intercepto.
Para pedir exactamente a previsão correspondente ao intercepto, fixamos Powerboats = 0:
(Intercept)
5.113643 1 rate SE df asymp.LCL asymp.UCL
overall 5.11 0.654 Inf 3.98 6.57
Confidence level used: 0.95
Intervals are back-transformed from the log scale As duas estimativas coincidem. Na escala logarítmica do modelo Poisson, o intercepto é a previsão quando Powerboats = 0. Com type = "response", emmeans aplica a exponencial e devolve a contagem esperada nessa condição.
Neste conjunto de dados, porém, Powerboats = 0 está muito fora do intervalo observado, que começa perto de 450. Essa previsão é uma extrapolação pouco útil para comunicar o resultado. Recentremos, por exemplo, em Powerboats = 700:
(Intercept)
42.9189 1 rate SE df asymp.LCL asymp.UCL
overall 42.9 1.3 Inf 40.4 45.6
Confidence level used: 0.95
Intervals are back-transformed from the log scale Agora zero significa Powerboats = 700 e a estimativa pode ser lida directamente como a contagem esperada de mortes nesse ponto. O princípio é o mesmo na regressão logística: fixar todas as covariáveis quantitativas em zero dá o intercepto na escala logit. type = "response" transforma-o numa probabilidade prevista.
Interpretar o Efeito
A tabela de car::Anova() dá o qui-quadrado do efeito de Powerboats. Neste modelo simples há apenas um preditor, mas o mesmo comando estende-se a modelos com vários termos e interacções.
A exponencial do declive põe a associação numa escala multiplicativa:
Como este modelo não tem offset, a exponencial do declive é uma razão de contagens esperadas por unidade adicional de Powerboats. Ainda não é uma razão de taxas.
Desenhar a Previsão
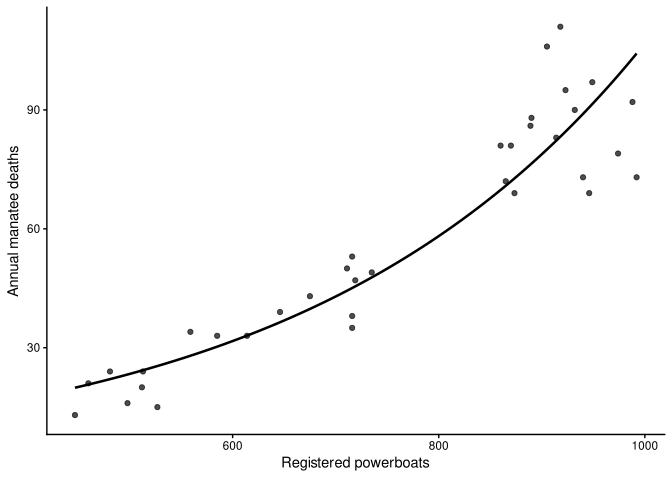
poisson_grid <- data.frame(
Powerboats = seq(
min(ds$Powerboats),
max(ds$Powerboats),
length.out = 100
)
)
poisson_grid$predicted <- predict(
m_pois,
newdata = poisson_grid,
type = "response"
)
ggplot(ds, aes(x = Powerboats, y = ManateeDeaths)) +
geom_point(alpha = 0.7) +
geom_line(
data = poisson_grid,
aes(y = predicted),
linewidth = 0.9
) +
theme_classic() +
labs(
x = "Registered powerboats",
y = "Annual manatee deaths"
)
Verificar Sobredispersão
performance::check_overdispersion(m_pois)# Overdispersion test
dispersion ratio = 1.983
Pearson's Chi-Squared = 65.429
p-value = 0.001E olhe para o painel de diagnóstico numa figura suficientemente grande:
performance::check_model(m_pois)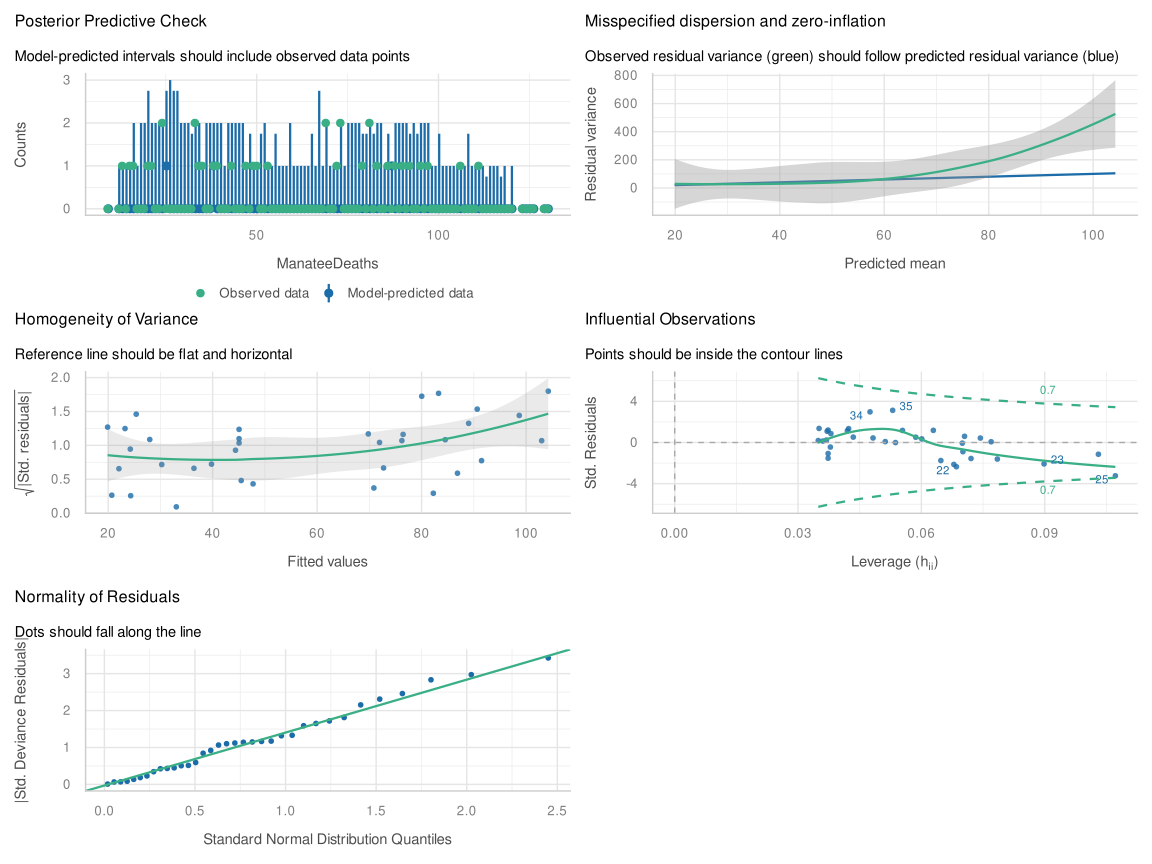
Se houver sobredispersão, não responda apenas «trocar de distribuição». Pergunte se falta estrutura ao modelo: um preditor importante, dependência entre observações, heterogeneidade entre unidades ou uma relação média–variância que Poisson não representa bem. As alternativas estão explicadas em dispersão nos GLMs.
5 Offset: Taxas em Vez de Contagens
Às vezes a pergunta não é «quantos eventos ocorreram?», mas «qual é a taxa por unidade de exposição?». A exposição pode ser tempo, população, quilómetros percorridos ou outra oportunidade de observar o evento.
Antes de usar um offset, confirme que a exposição é positiva e que a unidade tem significado substantivo. A derivação teórica do offset mostra por que log(exposure) entra com coeficiente fixo em 1. offset(log(exposure)) diz ao modelo que a contagem esperada deve crescer proporcionalmente à exposição. O offset fixa o coeficiente da exposição em 1, o que equivale a modelar a taxa em vez da contagem bruta.
# Simulate a small teaching example reproducibly.
set.seed(2)
dat_rate <- data.frame(exposure = c(10, 10, 20, 20), group = factor(c("A", "B", "A", "B")))
dat_rate| exposure | group |
|---|---|
| 10 | A |
| 10 | B |
| 20 | A |
| 20 | B |
A tabela mostra exposições de 10 e 20 unidades em ambos os grupos, todas positivas e sem valores em falta. Uma exposição de zero daria log(0) = -Inf; perante um zero, um valor negativo ou um valor em falta, teríamos de consultar os registos e perceber o que significa antes de ajustar o modelo. Neste exemplo simulado, podemos agora gerar as contagens:
| exposure | group | y |
|---|---|---|
| 10 | A | 1 |
| 10 | B | 7 |
| 20 | A | 6 |
| 20 | B | 8 |
dat_rate$observed_rate <- dat_rate$y / dat_rate$exposure
dat_rate| exposure | group | y | observed_rate |
|---|---|---|---|
| 10 | A | 1 | 0.1 |
| 10 | B | 7 | 0.7 |
| 20 | A | 6 | 0.3 |
| 20 | B | 8 | 0.4 |
Call:
glm(formula = y ~ group + offset(log(exposure)), family = poisson(link = "log"),
data = dat_rate, contrasts = list(group = "contr.sum"))
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -1.0742 0.2289 -4.694 2.68e-06 ***
group1 -0.3811 0.2289 -1.665 0.0959 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for poisson family taken to be 1)
Null deviance: 5.4383 on 3 degrees of freedom
Residual deviance: 2.4615 on 2 degrees of freedom
AIC: 19.865
Number of Fisher Scoring iterations: 4car::Anova(m_rate, type = 3)| LR Chisq | Df | Pr(>Chisq) | |
|---|---|---|---|
| group | 2.976856 | 1 | 0.0844632 |
group rate SE df asymp.LCL asymp.UCL
A 0.233 0.0882 Inf 0.111 0.489
B 0.500 0.1290 Inf 0.301 0.829
Results are averaged over the levels of: exposure
Confidence level used: 0.95
Intervals are back-transformed from the log scale | contrast | ratio | SE | df | null | z.ratio | p.value |
|---|---|---|---|---|---|---|
| A / B | 0.4666667 | 0.2136105 | Inf | 1 | -1.665018 | 0.0959091 |
offset = log(1) fixa a exposição de referência em uma unidade. As previsões podem então ser lidas como taxas esperadas por unidade de exposição. Uma comparação por pares na escala da resposta é uma razão de taxas. Se a exposição for pessoa-tempo e o evento for uma incidência, essa razão pode ser descrita como incidence-rate ratio (IRR). Diga sempre qual é a unidade: pessoa-ano, quilómetro, dia de amostragem, etc.
6 Antes de Escrever os Resultados
Antes de fechar a análise, confirme:
- se a resposta é realmente binária, uma proporção ou uma contagem;
- se as variáveis categóricas foram representadas como
factor()quando isso corresponde à pergunta; - que termos foram testados na tabela Tipo III e qual é a pergunta de cada um;
- em que escala vai comunicar as estimativas: probabilidade, odds ratio, contagem esperada ou taxa;
- no caso duma taxa, qual é a exposição e a sua unidade;
- se há sobredispersão, separação, dependência ou outro padrão que torne o modelo demasiado simples. Quando a mesma unidade contribui com várias observações, a dependência deve ser modelada. Veja medidas repetidas e modelos mistos.
Esta lista serve para recordar perguntas. Não substitui a análise dos dados, do delineamento e das estimativas.
7 Exercícios
Titanic: Acrescentar Idade
Volte a importar o Titanic: no exemplo de contagens, ds passou a conter os dados dos manatins. Prepare novamente Pclass e Sex como factores, remova as linhas com valores em falta nas variáveis usadas e ajuste:
Depois use car::Anova(..., type = 3). Que efeitos têm evidência no modelo? Faça previsões com emmeans e explique por que o teste de Age e as comparações entre classes/sexos respondem a perguntas diferentes.
Solução 1 — Titanic com Idade
Retiramos as linhas com valores em falta nas quatro variáveis usadas e ajustamos a idade como covariável quantitativa:
ds_titanic <- read.csv("../data/titanic.csv")
ds_titanic$Pclass <- factor(paste0("class", ds_titanic$Pclass))
ds_titanic$Sex <- factor(ds_titanic$Sex)
ds_age <- ds_titanic[complete.cases(
ds_titanic[, c("Survived", "Pclass", "Sex", "Age")]
), ]
m_log_age <- glm(
Survived ~ Pclass * Sex + Age,
data = ds_age,
family = binomial(link = "logit"),
contrasts = list(Pclass = "contr.sum", Sex = "contr.sum")
)
car::Anova(m_log_age, type = 3)
emmeans(m_log_age, ~ Pclass * Sex, type = "response")A tabela Tipo III testa os termos Pclass, Sex, Pclass:Sex e Age no mesmo modelo. Age testa uma associação com a sobrevivência condicionada pelos outros termos; as comparações entre classes ou sexos descrevem diferenças de probabilidade prevista calculadas para a idade de referência da grelha.
emmeans em Logística
No modelo do Titanic, peça:
Identifique quais resultados são probabilidades previstas e quais são odds ratios. Distinga efeitos globais da tabela Tipo III de comparações condicionais entre níveis.
Solução 2 — emmeans no Modelo Logístico
As linhas de médias estimadas são probabilidades previstas. As linhas de contrast, pedidas com type = "response", são razões de odds. Os resultados sem | resumem comparações sobre o outro factor; os que têm | são comparações condicionais dentro de cada sexo ou classe. A tabela Tipo III testa os efeitos globais do modelo, não substitui estas comparações específicas.
Proporções
Altere successes para c(12, 20, 22). Volte a ajustar m_prop, peça car::Anova(m_prop, type = 3) e compare o gráfico das probabilidades previstas. O que mudou na magnitude das diferenças e na evidência global para group?
Solução 3 — Proporções com o Grupo C Alterado
dat_prop$successes <- c(12, 20, 22)
dat_prop$failures <- dat_prop$total - dat_prop$successes
dat_prop$proportion <- dat_prop$successes / dat_prop$total
m_prop <- glm(
  cbind(successes, failures) ~ group,
  data = dat_prop,
  family = binomial(link = "logit"),
  contrasts = list(group = "contr.sum")
)

car::Anova(m_prop, type = 3)
emm_prop <- emmeans(m_prop, ~ group, type = "response")
emm_prop
emm_prop_df <- as.data.frame(emm_prop)
ggplot(emm_prop_df, aes(group, prob)) +
geom_point(size = 2.5) +
geom_errorbar(aes(ymin = asymp.LCL, ymax = asymp.UCL), width = 0.12) +
coord_cartesian(ylim = c(0, 1)) +
theme_classic() +
labs(x = "Group", y = "Predicted probability")A proporção de C fica mais próxima da de B do que no exemplo original. Compare as probabilidades previstas e a tabela Tipo III para descrever a mudança na magnitude das diferenças e na evidência para group, sem tratar o limiar do valor-p como a única conclusão.
Manatins
Ajuste o Poisson, obtenha car::Anova(m_pois, type = 3), desenhe as contagens previstas e corra check_overdispersion(m_pois). Escreva quatro linhas que separem: associação estimada, teste do efeito, adequação da dispersão e limites causais.
Solução 4 — Poisson para as Mortes de Manatins
m_pois <- glm(
  ManateeDeaths ~ Powerboats,
  data = ds,
  family = poisson(link = "log")
)

summary(m_pois)
car::Anova(m_pois, type = 3)
performance::check_overdispersion(m_pois)
poisson_grid <- data.frame(
Powerboats = seq(min(ds$Powerboats), max(ds$Powerboats), length.out = 100)
)
poisson_grid$predicted <- predict(m_pois, newdata = poisson_grid, type = "response")
ggplot(ds, aes(Powerboats, ManateeDeaths)) +
geom_point(alpha = 0.7) +
geom_line(data = poisson_grid, aes(y = predicted), linewidth = 0.9) +
theme_classic() +
labs(x = "Registered powerboats", y = "Annual manatee deaths")Um relato curto deve (1) indicar a direcção e a escala multiplicativa da associação estimada, usando o coeficiente ou exp(coef(m_pois)); (2) distinguir o teste do efeito na tabela Tipo III; (3) dizer o que check_overdispersion() sugere sobre a adequação da variância Poisson; e (4) lembrar que estes dados observacionais não identificam por si só um efeito causal dos barcos nas mortes.