Medidas Repetidas no R
0 A Mesma Pessoa Duas Vezes
Imagine Manuel, Rita, Tomás e Andreia a responderem a uma escala de mal-estar antes e depois de uma intervenção. Se a média mudar, essa mudança é uma diferença entre dois grupos independentes ou uma mudança dentro de cada pessoa? É a segunda: cada pessoa contribui com duas observações relacionadas.
A pergunta de entrada é simples: a pontuação mudou entre o pré e o pós nas mesmas pessoas? O factor momento é intra-participantes, também chamado intra-sujeitos (within-subjects). Se pessoas diferentes contribuíssem em cada nível, seria inter-participantes ou inter-sujeitos (between-subjects). Para outras unidades, usamos intra-unidades e inter-unidades.
Há medidas repetidas quando a mesma unidade contribui com mais de uma observação. Essa unidade pode ser uma pessoa avaliada antes e depois de uma intervenção, um briozoário medido em dois estádios ou um quadrado visitado em vários anos. O nome da unidade muda; a primeira tarefa não:
- perceber o que representa uma linha da tabela;
- identificar que linhas pertencem à mesma unidade;
- distinguir o que varia dentro da unidade do que varia entre unidades.
Vamos percorrer duas análises. Começamos com um caso pré–pós de psicologia, porque tem a estrutura mais simples. Depois fazemos uma análise mais completa de dados de briozoários, com um factor inter-unidades e outro intra-unidades. Em cada caso, tornamos o percurso visível: pergunta → gráfico → modelo → interpretação. No fim, usamos a mesma linguagem para reconhecer situações em que um modelo misto é mais adequado.
A teoria que liga esta estrutura à ANOVA e aos modelos mistos está em Medidas Repetidas e Modelos Mistos. Para unidade experimental, subamostragem e replicação, consulte também Delineamento da Investigação. Não é preciso dominar já toda a matemática desses capítulos para seguir o tutorial. Aqui interessa-nos aprender um percurso de análise que possamos repetir:
pergunta → estrutura dos dados → gráfico das unidades → modelo → estimativas e contrastes → diagnóstico → relato
1 Preparação
Usamos afex para a ANOVA, emmeans para obter estimativas e contrastes, ggplot2 para os gráficos e lme4 para o primeiro modelo misto. dplyr e tidyr ajudam-nos a organizar os dados. Para o diagnóstico pré–pós, usamos uma função de performance e os métodos gráficos de see. Se algum pacote ainda não estiver instalado, veja primeiro a secção sobre pacotes.
Depois dos pacotes, definimos a codificação dos factores para os modelos ajustados nesta sessão: contr.sum para factores não ordenados e contr.poly para factores ordenados. As diferenças pedidas com pairs() continuam a seguir a ordem dos níveis, que vamos definir explicitamente em cada exemplo.
2 Antes e Depois
Comecemos com um exemplo didáctico de psicologia. Imagine que score é uma pontuação de mal-estar recolhida antes e depois de uma intervenção. Queremos saber se a pontuação mudou entre o pré e o pós.
Este delineamento, por si só, não permite separar uma possível acção da intervenção da passagem do tempo ou de outros acontecimentos entre as duas medições. Isso é uma limitação do delineamento, não uma coisa que possamos resolver escolhendo outra função no R. Ainda assim, podemos estimar a mudança observada sem fingir que as duas medições da mesma pessoa são independentes.
Estrutura dos Dados
Antes de ajustar qualquer modelo, confirmamos que a repetição é real e que as linhas podem ser ligadas à mesma pessoa. Isto pressupõe que a identificação funciona nos dois sentidos: não queremos dar dois IDs à mesma pessoa, nem o mesmo ID a pessoas diferentes.
Passar os Dados a Formato Longo
O ficheiro começa em formato largo: cada pessoa ocupa uma linha e cada momento tem a sua coluna.
| pp | pre | post |
|---|---|---|
| pp001 | 59.47 | 44.00 |
| pp002 | 38.38 | 34.60 |
| pp003 | 55.97 | 53.99 |
| pp004 | 56.96 | 57.16 |
| pp005 | 32.34 | 28.62 |
| pp006 | 40.37 | 35.36 |
Confirmamos que há uma linha por ID e que ambos os momentos estão preenchidos:
| n | nn |
|---|---|
| 1 | 30 |
  pp  pre post
   0    0    0
Neste ficheiro, são 30 pessoas com uma linha cada e nenhum valor em falta. Os passos pré–pós abaixo pressupõem pares completos. Se encontrar IDs repetidos ou medições em falta nos seus dados, descubra o que aconteceu antes de continuar, em vez de retirar pessoas automaticamente.
Para aov_4(), queremos uma linha por observação. pivot_longer() reúne as colunas pre e post numa coluna com o momento (time) e noutra com a pontuação (score).
| pp | time | score |
|---|---|---|
| pp001 | pre | 59.47 |
| pp001 | post | 44.00 |
| pp002 | pre | 38.38 |
| pp002 | post | 34.60 |
| pp003 | pre | 55.97 |
| pp003 | post | 53.99 |
A transformação duplica o número de linhas, mas não duplica o número de pessoas. Cada pessoa deve agora aparecer duas vezes:
Neste resultado, n = 2 significa duas observações por pessoa. A última coluna diz quantas pessoas têm esse número de observações. Se aparecer outro valor, inspeccione essas pessoas antes de ajustar o modelo; não apague linhas apenas para a tabela ficar bonita.
Gráfico
Num gráfico de medidas repetidas, ligamos os pontos que pertencem à mesma unidade. Aqui, cada linha liga as duas pontuações de uma pessoa.
ggplot(paired_long, aes(time, score, group = pp)) +
  geom_line(alpha = 0.25) +
  geom_point(alpha = 0.55) +
  theme_classic() +
  labs(x = "Time", y = "Score")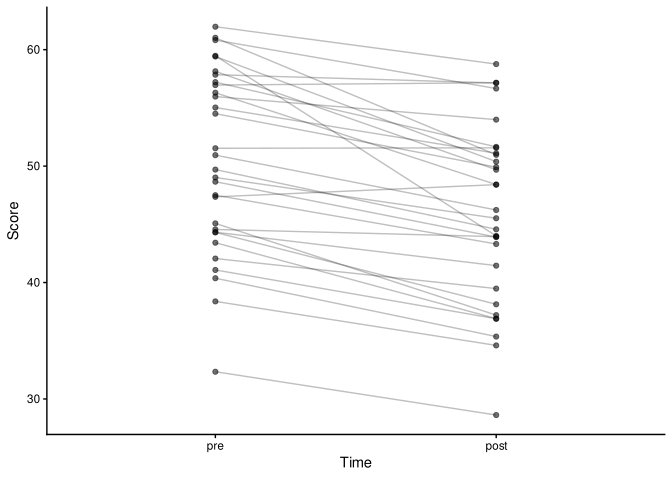
O gráfico não substitui o modelo. Faz outra coisa: ajuda-nos a perceber rapidamente se a pontuação mudou na mesma direcção e com uma magnitude semelhante para a maioria das pessoas, ou se a mudança média esconde trajectórias muito diferentes.
Modelo
Neste caso, time varia dentro de pp. Escrevemos essa estrutura directamente na fórmula:
| Effect | df | MSE | F | ges | p.value |
|---|---|---|---|---|---|
| time | 1, 29 | 5.83 | 55.50 *** | .086 | <.001 |
Leia a fórmula em duas partes:
-
score ~ timedescreve a diferença média que queremos estimar; -
(time | pp)diz aaov_4()quetimese repete dentro de cadapp.
Com dois momentos, a tabela tem um único efeito: time. Diz-nos se a mudança é grande relativamente à variação que resta. Ainda precisamos de saber a direcção e a magnitude dessa mudança.
Interpretação
Para saber em que direcção mudou a pontuação e qual foi a diferença em pontos, obtemos as médias estimadas em cada momento e uma diferença com sinal explícito:
emm_prepost <- emmeans(m_prepost, ~ time)
emm_prepost
time emmean SE df lower.CL upper.CL
pre 50.5 1.42 29 47.6 53.4
post 45.9 1.40 29 43.0 48.7
Confidence level used: 0.95 pairs() dá-nos directamente a comparação entre os dois níveis. Como definimos a ordem como pre, post, a comparação aparece como pré menos pós:
change_prepost <- pairs(emm_prepost)

change_prepost
contrast estimate SE df t.ratio p.value
pre - post 4.65 0.624 29 7.450 <0.0001confint(change_prepost)| contrast | estimate | SE | df | lower.CL | upper.CL |
|---|---|---|---|---|---|
| pre - post | 4.646 | 0.6236589 | 29 | 3.370474 | 5.921526 |
A leitura do sinal é literal: se pré − pós > 0, a pontuação era maior no pré; se for 0, as duas médias estimadas coincidem; se for < 0, a pontuação é maior no pós. Nestes dados, a estimativa é cerca de 4.65 pontos, portanto a pontuação estimada desceu do pré para o pós.
Com dois momentos e pares completos, podemos ajustar directamente uma média às diferenças pre - post, usando os dados em formato largo:
lm((pre - post) ~ 1, data = paired)
Call:
lm(formula = (pre - post) ~ 1, data = paired)

Coefficients:
(Intercept)
      4.646
Um teste t emparelhado faz a mesma comparação da média das diferenças com zero:
t.test(paired$pre, paired$post, paired = TRUE)Sob estas condições, lm((pre - post) ~ 1, data = paired) e o teste t emparelhado têm a mesma pergunta e a mesma estatística t (podem diferir apenas na forma de imprimir o resultado). A ANOVA de aov_4() testa exactamente a mesma mudança: com dois momentos, o seu teste de time tem um valor F igual ao quadrado desse t e, por isso, o mesmo valor-p. Isto é útil para reconhecer código, não uma razão para escolher entre três fluxos de trabalho. Neste tutorial, afex::aov_4() continua a ser a interface preferida porque declara a estrutura repetida e se estende melhor a mais condições e a factores adicionais. O argumento paired = TRUE é indispensável no teste t; sem ele, o R trata as colunas como amostras independentes. A ligação conceptual fica no capítulo teórico.
Diagnóstico Pré–Pós
Continuemos com as mesmas 30 pessoas. Temos dois momentos, pares completos e nenhum factor adicional, e pressupomos que as pessoas são independentes entre si. Podemos então trabalhar com uma diferença por pessoa. É a distribuição dessas 30 diferenças que interessa para a inferência sobre a mudança média. Examinar a normalidade das 60 pontuações como se fossem independentes seria ignorar o emparelhamento.
Conservamos o sinal do contraste, pre - post. Para obter os resíduos desta comparação, ajustamos uma média às diferenças:
Usamos este modelo apenas para verificar os pressupostos da comparação feita com m_prepost. O intercepto é a mesma diferença média estimada com emmeans(), e cada resíduo é a diferença de uma pessoa menos essa média.
Pedimos apenas o Q–Q plot, para procurar assimetria ou caudas afastadas da referência normal:
diagnostic_prepost <- performance::check_model(
  m_differences,
  check = "qq",
  detrend = FALSE
)
plot(diagnostic_prepost, n_columns = 1)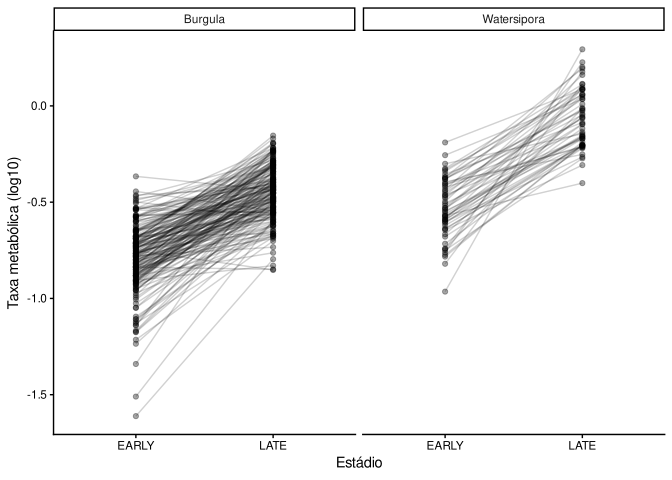
Se o see sugerir instalar qqplotr, essa mensagem refere-se a bandas de confiança opcionais. O gráfico acima funciona sem elas.
Aqui todos os valores ajustados são a mesma média. Um gráfico de resíduos contra ajustados não nos ajudaria a procurar curvatura, nem há preditores cuja colinearidade avaliar. O Q–Q plot também não verifica independência entre pessoas: essa justificação continua a vir do protocolo de recolha.
Neste gráfico, a cauda superior afasta-se da recta. Consulte os valores originais das mudanças mais extremas e volte às trajectórias: que pessoas mudaram mais do que as restantes? Se as caudas ou a influência preocuparem, o tutorial de diagnóstico explica como avaliar as consequências e comparar alternativas justificadas. Para reamostrar estes dados, precisamos de preservar cada par ou reamostrar as diferenças por pessoa.
Com mais momentos, factores inter-unidades, covariáveis, ensaios ou pares incompletos, esta simplificação já não basta. Precisamos de diagnósticos para o modelo e a estrutura que usámos.
Podemos investigar quanto cada pessoa pesa na média calculando essa média sem um par de cada vez. Para isso, subtraímos a diferença dessa pessoa à soma e dividimos pelo número de pessoas restantes:
[1] 4.646range(sensitivity_prepost$mean_without_person)[1] 4.272759 4.842414| pp | pre | post | change | mean_without_person |
|---|---|---|---|---|
| pp001 | 59.47 | 44.00 | 15.47 | 4.272759 |
| pp011 | 61.02 | 50.97 | 10.05 | 4.459655 |
| pp012 | 59.41 | 50.38 | 9.03 | 4.494828 |
| pp028 | 58.14 | 49.69 | 8.45 | 4.514828 |
| pp017 | 56.30 | 48.41 | 7.89 | 4.534138 |
| pp022 | 45.08 | 37.20 | 7.88 | 4.534483 |
Nestes dados, a média é 4.65 pontos e as médias sem uma pessoa variam entre 4.27 e 4.84. A mudança média mantém o mesmo sinal qualquer que seja o par retirado. Ficamos a saber quanto a média depende de cada par. Isso não garante que o intervalo de confiança seja adequado nem justifica excluir pessoas.
3 Briozoários
Passemos agora para uma pergunta de biologia marinha. Cada unidade adulta foi medida nos estádios EARLY e LATE, e as unidades pertencem a duas espécies. Queremos saber se a taxa metabólica muda entre estádios e se essa mudança difere entre espécies.
Antes da fórmula, escrevamos a estrutura:
- uma linha da tabela = uma medição;
- duas linhas podem pertencer à mesma unidade;
-
Stageé intra-unidades: varia na mesma unidade; -
Speciesé inter-unidades: varia entre unidades.
Esta última distinção é nova em relação ao exemplo pré–pós. Uma unidade muda de estádio, mas não muda de espécie.
Muitas unidades pertencem à mesma espécie. Isso não é, por si só, uma medida repetida nem pseudorreplicação. Species é o factor inter-unidades que queremos comparar. O que aparece mais de uma vez porque é literalmente a mesma entidade é Unit: cada unidade contribui com uma linha em EARLY e outra em LATE.
Se várias Unit viessem ainda do mesmo tanque, recife ou outro grupo relevante, teríamos mais um nível de agrupamento para considerar. O termo Species não substituiria esse nível.
Preparar os Dados
Importamos os dados e ficamos apenas com os dois estádios em que as unidades foram medidas repetidamente. Em seguida, transformamos as variáveis categóricas em factores e criamos um identificador inequívoco.
bryo <- read.csv("../data/bryozoan_wrangled.csv")
bryo <- subset(bryo, Stage %in% c("EARLY", "LATE"))

bryo$Species <- factor(bryo$Species)
bryo$Stage <- factor(bryo$Stage, levels = c("EARLY", "LATE"))
bryo$Unit <- interaction(bryo$Species, bryo$Id, drop = TRUE)

head(bryo[c("Unit", "Species", "Stage", "Log10MR")])| Unit | Species | Stage | Log10MR | |
|---|---|---|---|---|
| 173 | Watersipora.ID173 | Watersipora | EARLY | -0.4351027 |
| 174 | Watersipora.ID174 | Watersipora | EARLY | -0.6370841 |
| 175 | Watersipora.ID175 | Watersipora | EARLY | -0.7427715 |
| 176 | Watersipora.ID176 | Watersipora | EARLY | -0.4794523 |
| 177 | Watersipora.ID177 | Watersipora | EARLY | -0.3818032 |
| 178 | Watersipora.ID178 | Watersipora | EARLY | -0.3250922 |
Id só serve como identificador se apontar inequivocamente para a mesma unidade em todas as linhas. Criamos Unit com espécie e ID porque um código como ID001 pode, noutros ficheiros, voltar a ser usado dentro de cada espécie ou local. O modelo não consegue descobrir sozinho que dois ID001 são coisas diferentes.
Estrutura dos Dados
Primeiro, contamos as observações em cada combinação de espécie e estádio:
table(bryo$Species, bryo$Stage)
              EARLY LATE
  Burgula       197  197
  Watersipora    58   58
Depois contamos quantas linhas pertencem a cada unidade e resumimos essa contagem:
A saída tem de ser lida aos pares. O 2 à esquerda é o número de observações por unidade; 255 à direita é o número de unidades com essas duas observações. Se encontrar uma, três ou vinte observações por unidade, não «corrija» automaticamente. Volte aos dados e descubra o que essas linhas representam.
Gráfico
Voltamos a ligar os pontos da mesma unidade. Desta vez separamos as espécies em painéis para não transformar o gráfico num emaranhado ainda maior.
ggplot(bryo, aes(Stage, Log10MR, group = Unit)) +
geom_line(alpha = 0.18) +
geom_point(alpha = 0.35) +
facet_wrap(~ Species) +
theme_classic() +
labs(x = "Stage", y = "Metabolic rate (log10)")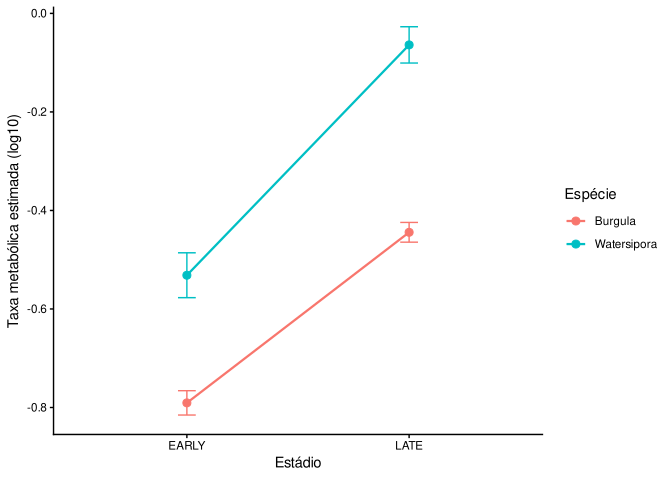
Cada traço liga duas medições da mesma unidade. Procure três coisas antes de continuar: a direcção dominante da mudança, a variação dessa mudança entre unidades e eventuais unidades que não seguem o padrão geral. Não precisamos de decidir já o resultado; estamos a aprender que pergunta o modelo terá de responder.
4 Modelo
Para este delineamento completo, com dois estádios e uma observação por unidade em cada estádio, usamos afex::aov_4():
| Effect | df | MSE | F | ges | p.value |
|---|---|---|---|---|---|
| Species | 1, 253 | 0.03 | 288.52 *** | .414 | <.001 |
| Stage | 1, 253 | 0.02 | 757.70 *** | .533 | <.001 |
| Species:Stage | 1, 253 | 0.02 | 16.84 *** | .025 | <.001 |
Também aqui lemos a fórmula em partes:
-
Log10MRé a resposta; -
Species * StageincluiSpecies,Stagee a interacção entre ambos; -
(Stage | Unit)declara queStagese repete dentro deUnit.
Na tabela aparecem três linhas. Species compara as espécies em média, Stage compara os estádios em média e Species:Stage pergunta se a mudança entre estádios é igual nas duas espécies. Esta interacção é a linha que responde mais directamente à nossa pergunta inicial.
A sintaxe entre parênteses lembra um modelo misto, mas aov_4() usa-a aqui para construir a ANOVA de medidas repetidas. Não é preciso reconstruir à mão os estratos de erro para completar esta análise; essa construção está no capítulo teórico.
5 Interpretação
A tabela ANOVA não mostra, por si só, qual espécie mudou mais nem qual é a magnitude da mudança. Para isso, estimamos as médias de cada combinação de espécie e estádio:
emm_bryo <- emmeans(m_rm, ~ Species * Stage)
emm_bryo Species Stage emmean SE df lower.CL upper.CL
Burgula EARLY -0.7906 0.0125 253 -0.815 -0.766
Watersipora EARLY -0.5315 0.0231 253 -0.577 -0.486
Burgula LATE -0.4443 0.0102 253 -0.464 -0.424
Watersipora LATE -0.0639 0.0187 253 -0.101 -0.027
Confidence level used: 0.95 Guardamos esta grelha de médias estimadas para a reutilizar nas comparações simples e na diferença entre diferenças. Assim, conseguimos acompanhar como as várias comparações partem das mesmas médias, sem voltar a chamar emmeans() em cada passo.
Agora pedimos a diferença entre EARLY e LATE dentro de cada espécie:
stage_by_species <- pairs(emm_bryo, by = "Species")
stage_by_speciesSpecies = Burgula:
contrast estimate SE df t.ratio p.value
EARLY - LATE -0.346 0.0141 253 -24.557 <0.0001
Species = Watersipora:
contrast estimate SE df t.ratio p.value
EARLY - LATE -0.468 0.0260 253 -17.993 <0.0001pairs() usa aqui a ordem dos níveis do factor e apresenta EARLY - LATE. Por isso, uma estimativa negativa corresponde a uma taxa metabólica estimada mais alta em LATE. Nos dados, a mudança tem a mesma direcção nas duas espécies, mas não a mesma magnitude.
Para testar directamente a interacção, comparamos essas duas diferenças:
Species_pairwise Stage_pairwise estimate SE df t.ratio p.value
Burgula - Watersipora EARLY - LATE 0.121 0.0296 253 4.103 <0.0001Este contraste é uma diferença entre diferenças. Não compare dois valores-p separados e conclua que há interacção porque um passou .05 e o outro não. A pergunta é se as duas mudanças diferem. O contraste deve testar essa pergunta directamente.
6 Mostrar as Estimativas
O gráfico inicial preservou cada unidade. Agora fazemos um segundo gráfico com as médias estimadas e os respectivos intervalos de confiança. Os dois gráficos têm funções diferentes. Um mostra os dados agrupados. O outro resume a pergunta inferencial.
emm_plot <- as.data.frame(emm_bryo)
ggplot(emm_plot, aes(Stage, emmean, colour = Species, group = Species)) +
geom_line(linewidth = 0.8) +
geom_point(size = 2.5) +
geom_errorbar(
aes(ymin = lower.CL, ymax = upper.CL),
width = 0.08
) +
theme_classic() +
labs(
x = "Stage",
y = "Estimated metabolic rate (log10)",
colour = "Species"
)
As linhas não são paralelas, o que corresponde à interacção. Em ambas as espécies, a taxa estimada é mais alta em LATE; o aumento é maior em Watersipora do que em Burgula.
7 Relatar a Análise
Um relato útil junta o delineamento, o modelo e o padrão estimado. Para as convenções de apresentação, consulte as páginas sobre APA e biologia/ecologia.
Há uma distinção de linguagem importante. Num delineamento repetido, podemos dizer que as mesmas unidades apresentam valores mais altos em A do que em B. Num delineamento inter-unidades, dizemos que as unidades de A apresentam valores mais altos do que as unidades de B. A segunda frase não deve soar como se cada unidade tivesse sido observada nas duas condições.
Para estes dados, uma versão curta poderia ser:
Cada unidade adulta foi medida nos estádios EARLY e LATE. Ajustámos uma ANOVA de medidas repetidas com estádio como factor intra-unidades e espécie como factor inter-unidades. A mudança entre estádios diferiu entre espécies, \(F(1, 253) = 16.84\), \(p < .001\), \(\eta_G^2 = .025\). A taxa metabólica estimada aumentou em ambas as espécies; o aumento foi maior em Watersipora (0.468 na escala log10) do que em Burgula (0.346).
Este parágrafo não precisa de listar todas as linhas produzidas pelo R. Precisa de dizer o que se repetiu dentro de quê, qual era a comparação central e que padrão encontrámos. Se o relatório exigir as médias e intervalos por célula, retire-os de emm_bryo e apresente-os numa tabela ou figura, em vez de os copiar de vários sítios do output.
O script abaixo reúne os passos da análise principal. Use-o para confirmar a ordem do trabalho, não para saltar a inspecção dos dados.
library(afex)
library(emmeans)
library(ggplot2)
options(contrasts = c("contr.sum", "contr.poly"))
bryo <- read.csv("../data/bryozoan_wrangled.csv")
bryo <- subset(bryo, Stage %in% c("EARLY", "LATE"))
bryo$Species <- factor(bryo$Species)
bryo$Stage <- factor(bryo$Stage, levels = c("EARLY", "LATE"))
bryo$Unit <- interaction(bryo$Species, bryo$Id, drop = TRUE)
# Check the repeated-measures structure
table(bryo$Species, bryo$Stage)
table(bryo$Unit) |>
  table()
# Plot one trajectory per unit
ggplot(bryo, aes(Stage, Log10MR, group = Unit)) +
geom_line(alpha = 0.18) +
geom_point(alpha = 0.35) +
facet_wrap(~ Species) +
theme_classic()
# Fit the repeated-measures ANOVA
m_rm <- aov_4(
Log10MR ~ Species * Stage + (Stage | Unit),
data = bryo
)
nice(m_rm)
# Estimate cells, simple effects, and the interaction contrast
emm_bryo <- emmeans(m_rm, ~ Species * Stage)
stage_by_species <- pairs(emm_bryo, by = "Species")
interaction_bryo <- contrast(
emm_bryo,
interaction = c("pairwise", "pairwise")
)
emm_bryo
stage_by_species
interaction_bryo
# Plot estimated marginal means
emm_plot <- as.data.frame(emm_bryo)
ggplot(emm_plot, aes(Stage, emmean, colour = Species, group = Species)) +
geom_line(linewidth = 0.8) +
geom_point(size = 2.5) +
geom_errorbar(
aes(ymin = lower.CL, ymax = upper.CL),
width = 0.08
) +
theme_classic()8 Quando Basta a ANOVA
A ANOVA de medidas repetidas é uma boa ferramenta quando o delineamento está próximo do seu caso ideal:
- poucas condições discretas;
- uma observação ou resumo por unidade × condição;
- delineamento completo ou quase completo;
- uma estrutura repetida simples.
No exemplo pré–pós, cada pessoa tem uma observação em cada momento. Nos briozoários, cada unidade tem uma observação em cada estádio. Se houver muitos ensaios por pessoa, observações em falta, tempos irregulares, vários níveis de agrupamento ou interesse explícito na variação dos efeitos entre unidades, um modelo misto pode representar melhor a estrutura.
Com três ou mais níveis de um factor repetido, terá ainda de considerar a esfericidade e as correcções apresentadas pelo afex. Como os dois exemplos principais têm apenas dois níveis, não precisamos dessa etapa aqui. Veja Esfericidade antes de analisar três ou mais momentos.
9 Primeiro Modelo Misto
Para uma segunda explicação, especialmente útil para ver os modelos nascer de simulações, vale a pena abrir Barr (2021), Learning Statistical Models Through Simulation in R. A PsyTeachR desenvolve esta ideia com muito mais simulação; aqui mantemos o foco na estrutura do delineamento e na análise dos nossos exemplos.
Podemos olhar para os dados dos briozoários com um intercepto aleatório por unidade:
Linear mixed model fit by REML. t-tests use Satterthwaite's method [
lmerModLmerTest]
Formula: Log10MR ~ Species * Stage + (1 | Unit)
Data: bryo
REML criterion at convergence: -407.6
Scaled residuals:
Min 1Q Median 3Q Max
-4.2594 -0.5085 0.0104 0.5768 2.6599
Random effects:
Groups Name Variance Std.Dev.
Unit (Intercept) 0.006087 0.07802
Residual 0.019583 0.13994
Number of obs: 510, groups: Unit, 255
Fixed effects:
Estimate Std. Error df t value Pr(>|t|)
(Intercept) -0.457571 0.009412 253.000001 -48.614 < 2e-16 ***
Species1 -0.159877 0.009412 253.000001 -16.986 < 2e-16 ***
Stage1 -0.203454 0.007391 252.999997 -27.526 < 2e-16 ***
Species1:Stage1 0.030328 0.007391 252.999997 4.103 5.5e-05 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Correlation of Fixed Effects:
(Intr) Specs1 Stage1
Species1 -0.545
Stage1 0.000 0.000
Specs1:Stg1 0.000 0.000 -0.545(1 | Unit) deixa cada unidade ter o seu próprio nível basal. As duas observações da mesma unidade partilham esse desvio; o modelo deixa portanto de as tratar como observações sem relação entre si.
Podemos pedir as mesmas médias previstas e as mudanças dentro de cada espécie. Tal como na ANOVA, calculamos a grelha uma vez e derivamos dela as comparações:
emm_lmm <- emmeans(m_lmm, ~ Species * Stage)
emm_lmm Species Stage emmean SE df lower.CL upper.CL
Burgula EARLY -0.7906 0.0114 479 -0.813 -0.7681
Watersipora EARLY -0.5315 0.0210 479 -0.573 -0.4901
Burgula LATE -0.4443 0.0114 479 -0.467 -0.4219
Watersipora LATE -0.0639 0.0210 479 -0.105 -0.0226
Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95 pairs(emm_lmm, by = "Species")Species = Burgula:
contrast estimate SE df t.ratio p.value
EARLY - LATE -0.346 0.0141 253 -24.557 <0.0001
Species = Watersipora:
contrast estimate SE df t.ratio p.value
EARLY - LATE -0.468 0.0260 253 -17.993 <0.0001
Degrees-of-freedom method: kenward-roger Não espere que todos os números da ANOVA e do modelo misto sejam idênticos. São modelos relacionados, mas fazem a inferência de maneiras diferentes. O nosso objectivo aqui é reconhecer a sintaxe e manter a pergunta substantiva visível, não escolher entre eles pelo valor-p mais pequeno.
Com apenas duas observações por unidade, não usamos este conjunto para ensinar uma estrutura aleatória rica. Estimar simultaneamente intercepto, declive de Stage e a sua covariância a partir desta estrutura pode pedir mais do que os dados dizem com clareza. A escolha de declives aleatórios e o compromisso entre complexidade e informação estão no capítulo teórico.
Agrupamento Parcial
Acabámos de permitir um nível basal por briozoário com (1 | Unit). Mas cada unidade só foi medida duas vezes. Se ambas as medições forem altas, quanto devemos atribuir a um nível habitualmente alto dessa unidade e quanto pode ser ruído das duas medições? É aqui que entra o agrupamento parcial (partial pooling).
O modelo estima as diferenças de espécie e estádio e, em simultâneo, a variância dos desvios entre unidades e a variância residual. Para estimar o desvio de uma unidade, usa as suas duas medições e a informação sobre a variação entre todas as unidades. Assim, uma unidade com valores altos pode continuar a ter um nível previsto alto, mas o seu desvio é aproximado de zero. Chamamos a essa aproximação shrinkage. Com menos informação por unidade, ou maior ruído residual relativamente à variação entre unidades, a aproximação é maior (Harrison et al., 2018, p. 6; Bates et al., 2015, §§3.1–3.2).
Podemos ver isso no modelo que já ajustámos. Primeiro retiramos a cada medição a previsão de Species * Stage, sem o desvio da unidade. A média do que sobra em cada Unit mostra quanto essa unidade se afasta das previsões de espécie e estádio antes do agrupamento parcial. Depois comparamos essa média com o desvio estimado pelo modelo misto, obtido com ranef() (Bates et al., 2015, p. 32):
bryo_deviations <- bryo |>
mutate(deviation = Log10MR - predict(m_lmm, re.form = NA)) |>
group_by(Unit) |>
summarise(observed_deviation = mean(deviation), .groups = "drop")
unit_effects <- ranef(m_lmm)$Unit
bryo_deviations$pooled_deviation <- unit_effects[
as.character(bryo_deviations$Unit), "(Intercept)"
]
ggplot(bryo_deviations, aes(observed_deviation, pooled_deviation)) +
geom_hline(yintercept = 0, colour = "grey80") +
geom_vline(xintercept = 0, colour = "grey80") +
geom_abline(slope = 1, intercept = 0, linetype = "dashed") +
geom_point(alpha = 0.5) +
coord_equal() +
theme_classic() +
labs(x = "Observed mean deviation (log10)",
y = "Partially pooled deviation (log10)")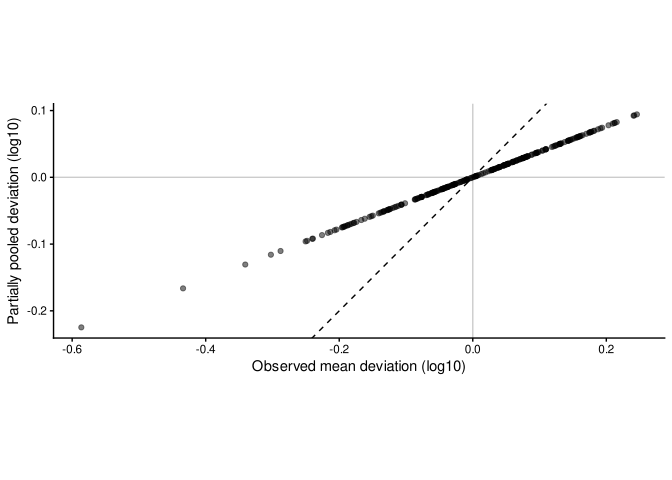
Cada ponto é agora uma unidade, não uma medição. Na diagonal tracejada, os dois desvios seriam iguais. Os pontos aproximam-se do eixo horizontal: os desvios estimados têm menor magnitude do que as médias observadas. Como todas as unidades têm duas medições neste modelo de interceptos aleatórios, o grau de aproximação é o mesmo para todas. O alvo é um desvio zero relativamente à previsão da sua espécie e estádio, não à média global que obteríamos ignorando esses dois factores.
Isto ajuda a interpretar os resultados anteriores. As médias e mudanças de emmeans(m_lmm, ...) respondem à pergunta sobre espécie e estádio. Os valores de ranef(m_lmm)$Unit descrevem os desvios basais das unidades nesse mesmo modelo; não são mudanças EARLY–LATE de cada unidade. Para permitir que a mudança varie entre unidades precisaríamos de declives aleatórios, que veremos mais adiante. A explicação conceptual das alternativas está em Agrupamento Parcial na teoria.
No exemplo seguinte, as unidades agrupadas serão tanques em vez de briozoários. O raciocínio mantém-se: estimar a comparação de interesse, representar a variação entre grupos e usar essa distribuição comum para estimar os seus desvios. Reconhecer os grupos continua a exigir replicação no nível certo.
10 Tanques
Imagine um ensaio de crescimento com seis tanques de controlo e seis tanques aquecidos, vários peixes por tanque e um valor final por peixe.
A estrutura é peixe → tanque → tratamento.
Uma linha pode representar um peixe, mas o tratamento térmico foi aplicado ao tanque.
Um modelo inicial seria:
m <- lmer(
growth ~ treatment + (1 | tank),
data = fish
)O termo (1 | tank) representa a semelhança entre peixes que partilharam o mesmo tanque. Tal como em (1 | Unit), estimamos uma variância entre grupos e desvios parcialmente agrupados. Aqui, cada desvio refere-se à previsão do respectivo tratamento: o modelo mantém a comparação controlo–aquecimento.
Aqui aparece o vocabulário técnico, mas os nomes dizem quase tudo. Observamos peixes, por isso são unidades de observação. O tratamento foi aplicado ao tanque, por isso o tanque é a unidade experimental. Vários peixes no mesmo tanque são subamostras desse tanque. Neste delineamento, são os tanques que contam como réplicas para comparar as condições.
Se houver apenas um tanque de controlo e um tanque aquecido, tratamento e tanque ficam confundidos. Acrescentar (1 | tank) reconhece agrupamento; não cria os tanques que faltam.
11 Recifes e Quadrados
Suponha vários quadrados dentro de cada recife, revisitados ao longo do tempo. Antes da fórmula, escreva a hierarquia: medição → quadrado → recife.
Se quadrat é único apenas dentro de reef, uma estrutura inicial pode ser
m <- lmer(
cover ~ impact * time + (1 | reef/quadrat),
data = data
)reef/quadrat representa variação entre recifes e entre quadrados dentro de recifes. Não use esta fórmula porque «parece ecológica»: use-a apenas se os dados foram realmente recolhidos dessa maneira.
12 Declives Aleatórios
Se cada unidade foi observada em vários valores de uma variável, podemos perguntar se o declive varia entre unidades.
Numa experiência de psicologia, cada pessoa pode responder em várias condições de dificuldade:
m_psy <- lmer(
response_time ~ difficulty + (difficulty | participant),
data = trials
)Num estudo de biologia marinha, várias colónias podem ser observadas ao longo de um gradiente de temperatura:
m_bio <- lmer(
metabolism ~ temperature + (temperature | colony),
data = measurements
)Nos dois casos, o declive fixo resume a associação média. O termo aleatório permite que essa associação seja mais forte nalgumas pessoas ou colónias e mais fraca noutras. Antes de usar esta estrutura, confirme que o preditor varia dentro das unidades e que existem observações suficientes para estimar essa variação. Uma fórmula mais complexa não cria informação.
13 Estruturas Cruzadas
Nem tudo está aninhado. Numa tarefa de reconhecimento, cada pessoa vê fotografias de gatos e de cães, e cada fotografia aparece para várias pessoas. Se houver replicação suficiente, uma estrutura candidata é:
m_psy <- lmer(
response_time ~ animal_type +
(animal_type | participant) + (1 | image),
data = trials
)animal_type varia dentro da pessoa, mas não dentro da fotografia. IDs como 1C (primeiro gato) e 1D (primeiro cão) distinguem imagens diferentes. Isso não transforma a categoria num factor intra-imagens. Veja o exemplo com participantes e fotografias.
Em ecologia, cada fotografia de um quadrado pode ser classificada por vários observadores, e cada observador pode classificar muitas fotografias:
m_bio <- lmer(
cover ~ treatment +
(1 | photograph) + (1 | observer),
data = classifications
)participant e image, tal como photograph e observer, são agrupamentos cruzados quando os estímulos são partilhados entre pessoas. Isto é diferente de observer/photograph, que representaria fotografias aninhadas em observadores.
A função afex::mixed() ajusta modelos mistos através de lme4 e devolve uma tabela de testes dos efeitos fixos. Ao contrário de lmer(), pode calcular directamente testes com aproximações de graus de liberdade ou comparações por razão de verosimilhanças. Também aceita family para modelos mistos generalizados, quando a resposta não é gaussiana.
Com um preditor quantitativo, (1 + x || unit) permite estimar intercepto e declive aleatórios sem a correlação entre ambos. Mas com factores, a notação || em lme4 não separa automaticamente todos os contrastes do factor. Em afex::mixed(), usamos expand_re = TRUE para expandir os termos aleatórios em colunas numéricas, permitindo a descorrelação dos contrastes.
Por exemplo, num delineamento com A e B repetidos dentro da pessoa:
method = "S" pede a aproximação de Satterthwaite para os testes dos efeitos fixos. Estes comandos são esquemas: data, y, A, B e person devem ser substituídos pelas variáveis do estudo. A segunda fórmula mantém os declives aleatórios para A, B e A × B, mas deixa de estimar as respectivas correlações, incluindo as correlações entre as colunas de contraste expandidas. Não é equivalente a remover os declives.
A simplificação seguinte, se necessária e justificada, poderá ser retirar primeiro declives aleatórios de interacções de ordem superior, sem eliminar automaticamente os efeitos fixos da análise. Para saber por que seguimos esta sequência, consulte a discussão teórica sobre construção de modelos mistos.
14 Verificações
Estrutura
Conte observações por unidade e condição antes do modelo:
IDs repetidos entre espécies, locais ou turmas são primeiro um problema de identificação. O modelo só consegue representar o agrupamento que os dados codificam correctamente. Veja também quem tem células em falta e se uma aparente repetição corresponde mesmo à mesma unidade.
Singularidade
Em modelos lmer, uma estrutura demasiado rica pode produzir um ajuste singular:
isSingular(m)Isto indica que os dados não contêm informação suficiente para estimar com clareza toda a estrutura de variâncias e covariâncias pedida. Volte ao delineamento, às estimativas e à pergunta antes de começar a apagar termos apenas para fazer desaparecer o aviso.
Resíduos
Depois de representar o agrupamento, examine também a forma da relação, a dispersão e observações influentes. O tutorial de diagnóstico desenvolve esse passo. Para o caso simples de dois momentos, veja o diagnóstico pré–pós acima. Um efeito aleatório não corrige, por si só, não linearidade, uma distribuição de resposta inadequada ou um erro de recolha.
15 Como Reportar
Torne a estrutura visível no texto:
- o que representava uma linha;
- que observações pertenciam à mesma unidade ou grupo;
- que efeitos variavam dentro e entre grupos;
- modelo e, quando aplicável, estrutura aleatória;
- estimativa ou contraste principal e incerteza;
- aspectos do delineamento que condicionam a conclusão.
«Usámos um modelo misto porque havia medidas repetidas» é pouco. Diga o que se repetiu dentro de quê. Da mesma forma, não acrescente uma lista genérica de «limitações» no fim: explique as que realmente mudam o alcance da conclusão.
16 Exercícios
- No conjunto pré–pós, faça primeiro o gráfico com uma linha por pessoa. Sem olhar para o modelo, conte quantas trajectórias descem e quantas sobem, e descreva duas formas pelas quais as pessoas diferem entre si.
Solução 1: Trajectórias Pré–Pós
ggplot(paired_long, aes(time, score, group = pp)) +
geom_line(alpha = 0.25) +
geom_point(alpha = 0.55) +
theme_classic() +
labs(x = "Time", y = "Score")Para tornar a descrição verificável, podemos contar as direcções directamente nos dados, sem dispensar o gráfico:
Neste conjunto, a maioria das trajectórias desce (26 descem, 4 sobem e nenhuma fica igual). O gráfico também permite ver diferenças no nível inicial e na magnitude da mudança: as linhas não começam todas no mesmo ponto e não têm necessariamente o mesmo declive. Cada linha é uma pessoa, não duas observações independentes.
- Ajuste
m_preposte interprete o sinal depre - post: o que significam valores positivos, zero e negativos? Depois escreva uma frase com a estimativa e o intervalo de confiança de 95%, sem reduzir a resposta a «significativo» ou «não significativo».
Solução 2: Sinal da Mudança Pré–Pós
Com os níveis ordenados como pre, post, o contraste é pre - post. Estimativas positivas indicam uma pontuação mais alta no pré, zero indica médias estimadas iguais e estimativas negativas indicam uma pontuação mais alta no pós. Podemos deixar o R produzir uma frase que conserva a direcção e o intervalo:
change <- as.data.frame(change_prepost)
interval <- as.data.frame(confint(change_prepost))
sprintf(
"The pre - post difference was %.2f (95%% CI %.2f to %.2f).",
change$estimate, interval$lower.CL, interval$upper.CL
)O relato deve identificar o contraste como pre - post e explicar a mudança na escala original. O valor-p pode ser acrescentado, mas não substitui a estimativa nem o intervalo.
- Nos briozoários, desenhe as trajectórias EARLY → LATE. Antes da ANOVA, escreva que padrão espera para a interacção
Species:Stagee explique como o reconheceria no gráfico.
Solução 3: Padrão Esperado nos Briozoários
ggplot(bryo, aes(Stage, Log10MR, group = Unit)) +
  geom_line(alpha = 0.18) +
  geom_point(alpha = 0.35) +
  facet_wrap(~ Species) +
  theme_classic() +
labs(x = "Stage", y = "Metabolic rate (log10)")A interacção Species:Stage corresponde a linhas não paralelas: a mudança de EARLY para LATE tem magnitude diferente entre espécies. No gráfico, devemos comparar as mudanças verticais dentro de cada painel, não apenas os níveis finais. Uma previsão adequada é, por exemplo, que ambas as espécies aumentem, mas que uma tenha uma subida maior; trajectórias individuais que não seguem o padrão dominante representam incerteza e não eliminam a pergunta sobre a média.
- Ajuste
m_rme estime EARLY − LATE por espécie. Compare direcção e magnitude e confirme a interacção com uma diferença entre diferenças. Explique por que não deve comparar apenas os dois valores-p das mudanças simples.
Solução 4: Mudanças por Espécie e Diferença Entre Diferenças
stage_by_species apresenta EARLY − LATE em cada espécie. Compare os sinais e as magnitudes dessas estimativas; neste conjunto, ambas são negativas, e a magnitude é maior em Watersipora (-0.468) do que em Burgula (-0.346). interaction_bryo testa directamente se a diferença entre essas duas mudanças é compatível com zero. Não conclua sobre a interacção comparando dois valores-p das mudanças simples: a pergunta da interacção é uma comparação entre efeitos.
- Imagine 40 peixes em quatro tanques, dois por tratamento. Desenhe primeiro peixe → tanque → tratamento; depois identifique unidade de observação, unidade experimental e subamostras.
Solução 5: Quatro Tanques
A hierarquia é peixe → tanque → tratamento. O peixe é a unidade de observação. Como o tratamento é aplicado ao tanque, o tanque é a unidade experimental e os peixes são subamostras dentro dela. Com dois tanques por tratamento, há duas réplicas experimentais por condição, não 20.
- Repita o exercício com apenas um tanque por tratamento. Explique por que o modelo pode representar agrupamento mas não separar tratamento de tanque.
Solução 6: Um Tanque por Tratamento
A hierarquia mantém-se, mas há apenas uma unidade experimental em cada condição. Tratamento e tanque ficam confundidos: uma diferença pode dever-se ao tratamento ou a qualquer particularidade do tanque. Um termo (1 | tank) representa a semelhança entre peixes do mesmo tanque; não cria replicação nem separa estas duas explicações.
- Um estudo mede cobertura em cinco quadrados dentro de cada um de dez recifes durante quatro anos. Desenhe a hierarquia antes de escrever uma fórmula.
Solução 7: Quadrados Revisitados
A hierarquia é medição → quadrado → recife: cada recife contém cinco quadrados e cada quadrado é observado em quatro anos. Uma estrutura inicial, se os identificadores forem únicos ou forem construídos dentro do recife, é:
m <- lmer(
  cover ~ time + (1 | reef/quadrat),
  data = data
)
Se time variar dentro dos quadrados e houver informação suficiente, a pergunta pode justificar uma estrutura que deixe também o declive temporal variar. Essa decisão vem depois de confirmar a estrutura e o número de observações, não apenas do número de linhas.
- Cada participante responde a 30 imagens e cada imagem é vista por muitas pessoas. Compare esta estrutura com fotografias submarinas classificadas por vários observadores. Em ambos os casos, identifique os agrupamentos cruzados.
Solução 8: Agrupamentos Cruzados
Nos dois exemplos, cada participante (ou observador) contribui para várias imagens (ou fotografias), e cada imagem ou fotografia recebe respostas de várias pessoas. Os agrupamentos são, portanto, cruzados, não aninhados. Uma estrutura inicial é:
A fórmula só é apropriada se as imagens/fotografias forem efectivamente partilhadas entre pessoas; se cada uma pertencer a um único observador, a estrutura deixa de ser cruzada.
17 Referências
Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
Harrison, X. A., Donaldson, L., Correa-Cano, M. E., Evans, J., Fisher, D. N., Goodwin, C. E. D., Robinson, B. S., Hodgson, D. J., & Inger, R. (2018). A brief introduction to mixed effects modelling and multi-model inference in ecology. PeerJ, 6, e4794. https://doi.org/10.7717/peerj.4794
18 Cábula
| Delineamento | Estrutura inicial |
|---|---|
| Pré–pós por pessoa | aov_4(y ~ time + (time | person), ...) |
| Factor repetido simples | aov_4(y ~ A + (A | unit), ...) |
| Inter-unidades × intra-unidades | aov_4(y ~ G * A + (A | unit), ...) |
| Intercepto aleatório | lmer(y ~ x + (1 | unit), ...) |
| Declive varia por unidade | lmer(y ~ x + (x | unit), ...) |
| Unidades aninhadas | (1 | group/unit) |
| Duas fontes cruzadas | (1 | source1) + (1 | source2) |
A fórmula vem no fim. Primeiro identifique o que representa uma linha da tabela, que linhas pertencem ao mesmo grupo e que preditores variam dentro ou entre unidades. Depois veja o gráfico, estime o contraste que responde à pergunta e escreva o que aprendeu com os dados.