Teoria da Detecção de Sinal
Separar sensibilidade de critério
Inferência
Como separar a capacidade de discriminar da tendência para responder «sim».
0 Acertar Não É Tudo
Imaginemos uma tarefa de reconhecimento de memória. Em cada ensaio aparece uma palavra e a pessoa responde:
«Esta palavra apareceu antes?»
O número de respostas correctas pode mudar por duas razões. Uma pessoa pode distinguir melhor palavras antigas de palavras novas. Mas pode também mudar apenas a regra que usa para responder: dizer «sim» com mais facilidade, ou exigir mais evidência antes de dizer «sim».
Em muitas experiências de psicologia guardamos simplesmente correcto = 1 / incorrecto = 0 e contamos respostas correctas. Isso responde a uma pergunta legítima sobre exactidão, mas junta coisas diferentes. Um acerto (hit) e uma rejeição correcta (correct rejection) tornam-se ambos apenas «correcto». Uma omissão e um falso alarme tornam-se ambos «incorrecto».
A Teoria da Detecção de Sinal (Signal Detection Theory, SDT) serve precisamente para recuperar essa informação e separar duas componentes:
- sensibilidade: quão bem o sinal se distingue do ruído;
- critério: quanta evidência é necessária para responder que o sinal está presente.
É por isso que a percentagem de respostas correctas, sozinha, pode esconder uma parte importante da história. Stanislaw e Todorov (1999) mostram como estas medidas podem ser calculadas em tarefas de discriminação e porque são úteis em várias áreas da psicologia.
1 As Quatro Respostas Possíveis
Numa tarefa sim/não, há duas realidades e duas respostas.
| Realidade | Resposta «sim» | Resposta «não» |
|---|---|---|
| sinal presente | acerto (hit) | omissão (miss) |
| sinal ausente | falso alarme (false alarm) | rejeição correcta (correct rejection) |
Para construir esta tabela, precisamos de guardar, em cada ensaio, se o sinal estava presente e se a pessoa respondeu «sim» ou «não», além do participante e da condição. A coluna correcto/incorrecto, sozinha, não permite recuperar as quatro contagens.
A taxa de acertos é
\[ H=\frac{\text{acertos}}{\text{acertos}+\text{omissões}}, \]
e a taxa de falsos alarmes é
\[ F=\frac{\text{falsos alarmes}} {\text{falsos alarmes}+\text{rejeições correctas}}. \]
Estas duas proporções já dizem mais do que a exactidão global. Um participante pode aumentar \(H\) simplesmente respondendo «sim» mais vezes, mas isso também tende a aumentar \(F\).
2 Acerto Não É Discriminação
Comecemos por uma tarefa equilibrada: em cada condição, temos 100 palavras antigas (alvos) e 100 novas (distractores). Antes de uma intervenção, a pessoa tem 95 acertos e 49 falsos alarmes. Depois, tem 80 acertos e apenas 20 falsos alarmes.
| Antes | Depois | |
|---|---|---|
| Acertos | 95 | 80 |
| Omissões | 5 | 20 |
| Falsos alarmes | 49 | 20 |
| Rejeições correctas | 51 | 80 |
| Respostas correctas | 146/200 = 73% | 160/200 = 80% |
| \(d'\) | ≈ 1.67 | ≈ 1.68 |
| \(c\) | ≈ -0.81 | ≈ 0 |
Se olhássemos apenas para «correcto/incorrecto», diríamos que o desempenho subiu de 73% para 80%. Mas a discriminabilidade praticamente não mudou. O que mudou foi sobretudo o critério: antes havia uma forte tendência para responder «sim»; depois, o critério ficou perto do ponto neutro.
O exemplo também pode acontecer ao contrário. Uma manipulação pode alterar \(d'\), alterar \(c\), ou alterar os dois. Uma simples percentagem de respostas correctas não nos diz qual destas histórias aconteceu.
Isto é especialmente importante quando a teoria fala em aprendizagem, memória, percepção ou capacidade de discriminar. Uma melhoria na exactidão não demonstra, por si só, que a representação, a memória ou a percepção ficou melhor. Pode ser uma mudança na regra de decisão. Herzog et al. (2019) usam precisamente esta distinção para mostrar por que a percentagem de respostas correctas mistura discriminabilidade e critério.
ImportanteA Pergunta da SDT
Quando uma experiência permite distinguir sinal presente de sinal ausente, podemos ir além de contar respostas correctas: as pessoas ficaram melhores a distinguir sinal de ruído, ou mudaram a quantidade de evidência de que precisam para responder «sim»?
3 Duas Distribuições e um Critério
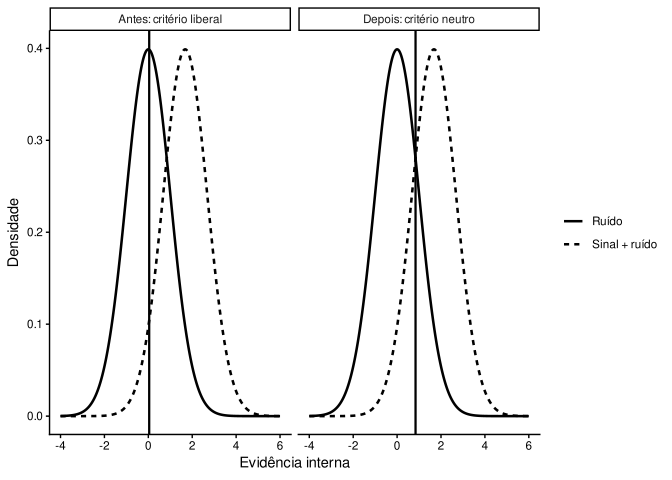
A versão clássica da SDT imagina duas distribuições de evidência interna: uma quando há apenas ruído e outra quando o sinal está presente. O participante responde «sim» quando a evidência ultrapassa um critério.
Nos dois painéis, a distância entre as distribuições é a mesma: \(d'\) não mudou. Só mudámos a linha vertical. Isso basta para alterar acertos, falsos alarmes e a percentagem de respostas correctas.
Mover as distribuições para mais longe uma da outra muda a discriminabilidade. Mover apenas o critério para a esquerda ou para a direita muda a tendência de resposta. Esta separação é a ideia central do capítulo.
4 Sensibilidade: \(d'\)
Na versão Gaussiana de variâncias iguais, a sensibilidade é
\[ d'=\Phi^{-1}(H)-\Phi^{-1}(F). \]
\(\Phi\) é a função de distribuição acumulada da normal padrão. \(\Phi^{-1}\) faz o caminho inverso: transforma uma proporção num valor-z.
No R, \(\Phi^{-1}\) é a função qnorm(). Portanto, a fórmula cabe quase inteira numa linha:
Código
[1] 1.836079Se \(d'=0\), a taxa de acertos e a taxa de falsos alarmes não mostram discriminabilidade. Quanto maior \(d'\), maior a separação entre sinal e ruído dentro deste modelo.
5 Critério: \(c\)
A medida \(c\) descreve onde está o critério relativamente ao ponto médio entre as duas distribuições:
\[ c=-\frac{1}{2} \left[ \Phi^{-1}(H)+\Phi^{-1}(F) \right]. \]
A convenção habitual é:
- \(c=0\): critério neutro;
- \(c<0\): critério liberal, com maior tendência para responder «sim»;
- \(c>0\): critério conservador, com maior tendência para responder «não».
Em R:
[1] -0.07641832Duas pessoas podem ter \(d'\) semelhantes e valores de \(c\) diferentes. Uma pode distinguir os estímulos tão bem como a outra, mas usar uma regra de decisão mais liberal.
6 Delineamento e SDT
A proporção de alvos e distractores é uma decisão importante no delineamento de uma tarefa de reconhecimento. Imaginemos um teste com 100 palavras antigas e 100 novas. Uma pessoa que respondesse sempre «sim» ou sempre «não» teria 50% de respostas correctas. Agora imaginemos que apenas 20% das palavras são antigas. Responder sempre «não» daria 80% de respostas correctas, sem que a pessoa precisasse de reconhecer uma única palavra.
Podemos evitar este problema logo no delineamento. Com o mesmo número de alvos e distractores, nenhuma das duas respostas beneficia apenas por ser a mais frequente. Se o objectivo for avaliar quantas respostas correctas uma pessoa dá nessa tarefa equilibrada, a exactidão global é uma medida perfeitamente legítima. Não precisamos de calcular \(d'\) para responder apenas a essa pergunta.
Mas nem todas as tarefas devem ter 50% de alvos. Num contexto de detecção de acontecimentos raros, por exemplo, a frequência dos alvos pode fazer parte da pergunta de investigação. Também podemos ter recolhido dados com números desiguais de alvos e distractores. Nestes casos, a SDT permite analisar os dois tipos de ensaio em separado.
Recordemos as taxas: \(H\) é a proporção de respostas «sim» entre os alvos e \(F\) é a proporção de respostas «sim» entre os distractores. Se \(p\) for a proporção de alvos, a exactidão global é:
\[ \text{Exactidão}=pH+(1-p)(1-F). \]
Quando \(p=0.5\), os acertos e as rejeições correctas têm o mesmo peso. Quando \(p\) muda, muda também a contribuição de cada tipo de ensaio. Mantendo as taxas de acertos e falsos alarmes do nosso primeiro exemplo, obtemos:
| Proporção de alvos | Antes | Depois |
|---|---|---|
| 20% | 59.8% | 80% |
| 50% | 73% | 80% |
| 80% | 86.2% | 80% |
Com 80% de alvos, até parece que a intervenção piorou o desempenho. Porém, as taxas \(H\) e \(F\) são as mesmas nos três cenários. Como \(d'\) e \(c\) são calculados a partir dessas taxas, também não mudam: \(d'\) continua perto de 1.68 nas duas condições e \(c\) passa de cerca de -0.81 para 0. É a ponderação da exactidão global que mudou.
Uma alternativa descritiva em tarefas desequilibradas é a exactidão equilibrada (balanced accuracy): a média da taxa de acertos e da taxa de rejeições correctas, \((H+1-F)/2\). No nosso exemplo, seria 73% antes e 80% depois, independentemente da proporção de alvos. Isto resolve o problema da ponderação desigual. Mas ainda junta discriminação e critério na mesma medida.
Então, um bom delineamento dispensa a SDT? Depende da pergunta. O equilíbrio facilita a interpretação da exactidão e evita uma fonte de confusão. Contudo, o primeiro exemplo do capítulo já era equilibrado: a exactidão subiu de 73% para 80% sem melhoria apreciável em \(d'\). A pessoa mudou sobretudo o seu critério de resposta. Equilibrar a tarefa não impede essa mudança. Se a pergunta for sobre capacidade de discriminar, e não apenas sobre a percentagem de decisões correctas, a distinção entre \(d'\) e \(c\) continua a ser útil.
Há ainda uma razão para estudar o critério por si mesmo. Numa tarefa equilibrada, com custos iguais para os dois tipos de erro, \(c=0\) maximiza a exactidão no modelo Gaussiano de variâncias iguais. Quando os alvos são raros, pode ser melhor adoptar um critério mais conservador. Se forem frequentes, pode ser melhor um critério mais liberal. O valor \(c=0\) significa «neutro» relativamente às distribuições, mas não significa sempre «óptimo» (Maniscalco et al., 2025).
NotaO Critério Que Maximiza a Exactidão
No modelo Gaussiano de variâncias iguais, com custos simétricos para os erros e \(d'>0\), o critério que maximiza a exactidão é:
\[ c_{\text{óptimo}}=\frac{\log[(1-p)/p]}{d'}. \]
Aqui, \(p\) é a probabilidade de aparecer um alvo e \(\log\) é o logaritmo natural. Para \(p=0.5\), obtemos \(c_{\text{óptimo}}=0\). Se \(d'\approx1.68\), um alvo com probabilidade 0.20 conduz a \(c_{\text{óptimo}}\approx0.83\); com probabilidade 0.80, o valor passa a cerca de -0.83. Se os dois tipos de erro tiverem custos diferentes, o critério óptimo também muda (Maniscalco et al., 2025).
Até aqui, mantivemos \(H\) e \(F\) constantes para isolar o efeito da proporção de alvos sobre a exactidão. Numa experiência real, as pessoas podem adaptar-se à frequência dos estímulos. Nesse caso, o próprio critério e as taxas de resposta podem mudar. Se a separação das distribuições de evidência se mantiver, \(d'\) permanece constante no modelo clássico, mas a tarefa também pode afectar a atenção ou a discriminação.
Finalmente, o desequilíbrio tem um custo prático: se houver poucos ensaios de um dos tipos, as taxas estimadas serão menos precisas e é mais provável observar proporções extremas. As correcções que veremos adiante podem alterar as estimativas. A SDT não exige um delineamento equilibrado, mas também não substitui um bom delineamento. Cada um resolve problemas diferentes.
7 Um Exemplo de Memória
Consideremos agora 50 palavras antigas e 50 palavras novas.
A participante responde:
- «antiga» a 42 das 50 palavras antigas: 42 acertos e 8 omissões;
- «antiga» a 10 das 50 palavras novas: 10 falsos alarmes e 40 rejeições correctas.
A exactidão global é 82%. Mas a SDT permite separar discriminação e critério.
Há um pequeno problema técnico: se alguém tiver \(H=1\) ou \(F=0\), qnorm() devolve infinito. Uma correcção log-linear muito usada acrescenta 0.5 às contagens e 1 ao denominador. Hautus (1995) estudou esta correcção e os seus efeitos.
Podemos escrever uma função pequena e transparente. O código fica dobrado: para seguir a ideia, basta comparar as contagens usadas e os índices obtidos.
Código
sdt_indices <- function(
  hits,
  misses,
  false_alarms,
  correct_rejections,
  adjust = TRUE
) {
  n_signal <- hits + misses
  n_noise <- false_alarms + correct_rejections

  if (adjust) {
    hit_rate <- (hits + 0.5) / (n_signal + 1)
    false_alarm_rate <- (false_alarms + 0.5) / (n_noise + 1)
  } else {
    hit_rate <- hits / n_signal
    false_alarm_rate <- false_alarms / n_noise
  }

  z_hit <- stats::qnorm(hit_rate)
  z_fa <- stats::qnorm(false_alarm_rate)

  data.frame(
    hit_rate = hit_rate,
    false_alarm_rate = false_alarm_rate,
    d_prime = z_hit - z_fa,
    c = -0.5 * (z_hit + z_fa),
    beta = exp((z_fa^2 - z_hit^2) / 2)
  )
}

sdt_indices(
  hits = 42,
  misses = 8,
  false_alarms = 10,
  correct_rejections = 40
)| hit_rate | false_alarm_rate | d_prime | c | beta |
|---|---|---|---|---|
| 0.8333333 | 0.2058824 | 1.788214 | -0.0733147 | 0.8771279 |
Com a correcção, obtemos aproximadamente \(d'=1.79\) e \(c=-0.07\). A estimativa de discriminabilidade é positiva e o critério está muito perto do ponto neutro.
CuidadoA Correcção Não É Magia
A correcção evita infinitos, mas também altera a estimativa. Isto pesa mais quando há poucos ensaios ou desempenho extremo. Não escondam esse facto atrás de uma função. Usem a mesma regra de forma consistente e, em problemas importantes, façam uma verificação de robustez. Trabalho recente mostra que as correcções podem interagir com o número de ensaios, a dificuldade e outras características do delineamento (PubMed 38961038).
8 E \(\beta\), \(A'\) e Outras Medidas?
Mergulhar Mais Fundo
Na primeira leitura, podemos seguir para Usar uma Função Pronta no R. As medidas alternativas ficam abaixo para consulta.
Outra medida paramétrica de viés é \(\beta\):
\[ \beta= \exp\left( \frac{ z(F)^2-z(H)^2 }{2} \right). \]
Um valor perto de 1 corresponde ao critério neutro sob as suposições clássicas. Valores menores e maiores do que 1 representam tendências de resposta em direcções opostas.
Também aparecem medidas não paramétricas como \(A'\) para discriminabilidade e \(B''_D\) para viés. Convém reconhecê-las, mas não precisamos de decorar todas as fórmulas para começar. Para uma primeira análise, \(d'\) e \(c\) costumam ser a dupla mais legível: uma medida de sensibilidade e uma medida de critério.
9 Usar uma Função Pronta no R
O pacote psycho inclui psycho::dprime(), que calcula \(d'\), \(\beta\), \(A'\), \(B''_D\) e \(c\), e aplica por defeito a correcção de Hautus (1995) às proporções (documentação CRAN).
A função pequena acima ajuda-nos a ver de onde vêm os números. Para trabalhar, podemos usar directamente psycho::dprime(), mantida pelo pacote e incluída nas dependências do NRB.
Código
psycho::dprime(
  n_hit = 42,
  n_fa = 10,
  n_miss = 8,
  n_cr = 40
)
$dprime
[1] 1.788214
$beta
[1] 0.8771279
$aprime
[1] 0.8904762
$bppd
[1] -0.08695652
$c
[1] -0.07331474O pacote é distribuído sob licença MIT. A documentação descreve os cálculos e a correcção aplicada (manual CRAN).
Ao procurar outras funções, há dois nomes que podem confundir: o pacote SDT do CRAN é sobre Self-Determination Theory, e o antigo sdtalt, que aparece em materiais mais velhos, foi removido do CRAN em 2012.
10 Da SDT aos GLMs
A SDT e os GLMs não são alternativas que se excluem.
A SDT clássica resume uma tarefa sim/não através de \(H\) e \(F\), separando sensibilidade e critério. Um GLM pode modelar respostas ensaio a ensaio e acrescentar preditores e interacções. Quando vários ensaios vêm do mesmo participante ou item, podemos representar a variação que partilham através de efeitos aleatórios. Passamos então à extensão dos modelos lineares generalizados mistos (GLMMs). O capítulo de modelos mistos explica esta ideia de agrupamento.
Há até uma ligação matemática natural: a SDT Gaussiana clássica usa a função normal acumulada, por isso modelos probit aparecem frequentemente em formulações de SDT. A intuição sobre famílias e ligações está no capítulo de Modelos Lineares Generalizados.
Para começar, a regra prática é simples:
- se a pergunta é «a probabilidade de uma resposta correcta muda?», um GLM binomial pode responder directamente;
- se a pergunta é «a capacidade de discriminar mudou, separadamente da tendência para responder sim?», \(d'\) e \(c\) são exactamente a separação que procuramos.
11 Participantes e Condições
Em experiências com várias pessoas, juntar todas as respostas numa única tabela 2 × 2 exige cuidado: podemos misturar participantes com sensibilidades e critérios diferentes.
Uma primeira abordagem pedagógica é calcular \(d'\) e \(c\) por participante e por condição e depois estudar essas medidas. Em projectos mais exigentes, modelos hierárquicos ou modelos de respostas ensaio a ensaio podem representar directamente a variação entre participantes.
O ponto importante é o mesmo de outros capítulos: a unidade de análise tem de corresponder à pergunta e ao delineamento.
12 Síntese
A Teoria da Detecção de Sinal parte de quatro contagens simples:
acertos · omissões · falsos alarmes · rejeições correctas
e transforma-as em duas perguntas diferentes:
\[ \text{sensibilidade}\quad d' \]
\[ \text{critério}\quad c. \]
\(d'\) pergunta quão separáveis são sinal e ruído. \(c\) pergunta onde a pessoa coloca o limiar para dizer «sim».
No R, a matemática central cabe em qnorm(). Para aprender, vale a pena escrever a função uma vez. Para trabalhar, psycho::dprime() fornece uma implementação pronta e outras medidas.
13 Exercícios
Estas respostas usam a convenção para \(d'\) e \(c\) apresentada nesta página. Vale a pena fazer as contas primeiro e interpretar o resultado depois.
- Uma pessoa tem muitos acertos e muitos falsos alarmes. O que pode estar a acontecer ao critério?
Solução 1 — Muitos «Sim»
Muitos acertos acompanhados de muitos falsos alarmes podem indicar um critério liberal: a pessoa responde «sim» com evidência relativamente fraca. Com a convenção desta página, isso tende a corresponder a um valor de \(c\) mais negativo.
Contudo, só estas contagens não permitem calcular os índices. Precisamos também de saber quantas tentativas tiveram sinal e quantas não tiveram.
- Duas pessoas têm a mesma exactidão. Explique por que podem ter valores diferentes de \(d'\) e \(c\).
Solução 2 — A Mesma Exactidão
A exactidão combina acertos e rejeições correctas numa proporção. Duas pessoas podem alcançar a mesma exactidão com taxas de acertos e de falsos alarmes diferentes.
A SDT separa duas características, sob os pressupostos do modelo: \(d'\) descreve a separabilidade das distribuições e \(c\) descreve a posição do critério. A exactidão global depende também da proporção de tentativas com sinal. Por isso, a mesma exactidão não implica o mesmo \(d'\) ou o mesmo \(c\).
- Calcule \(d'\) e \(c\) para 36 acertos, 14 omissões, 5 falsos alarmes e 45 rejeições correctas.
Solução 3 — Calcular os Índices
Há 50 tentativas com sinal e 50 sem sinal:
$ H==0.72, F==0.10. $
Sem aplicar correcção, temos \(z(H)\approx0.583\) e \(z(F)\approx-1.282\). Logo,
$ d’=z(H)-z(F), c=-. $
Há discriminação positiva e um critério ligeiramente conservador (\(c>0\)).
Se utilizarmos a correcção log-linear apresentada no capítulo, as taxas passam a \(36.5/51\) e \(5.5/51\). Nesse caso, obtemos aproximadamente \(d'=1.808\) e \(c=0.334\). Devemos indicar qual das convenções foi usada ao apresentar e comparar resultados.
- Explique por que \(H=1\) ou \(F=0\) cria um problema para
qnorm().
Solução 4 — Quantis Infinitos
A função qnorm() devolve o quantil de uma distribuição normal padrão. Quando a proporção é 1, esse quantil é \(+\infty\); quando é 0, é \(-\infty\). Por isso, \(H=1\) ou \(F=0\) pode produzir índices infinitos ou indefinidos.
A correcção log-linear de Hautus (1995) substitui as proporções extremas por valores finitos ao acrescentar 0.5 às contagens e 1 aos denominadores. É uma convenção de estimação com consequências nos resultados. Não resolve todas as limitações de uma amostra pequena.
- Numa experiência de memória, o atraso entre estudo e teste aumenta. Diga uma hipótese sobre \(d'\) e outra, diferente, sobre \(c\).
Solução 5 — Atraso e Memória
Uma hipótese é que o aumento do atraso reduza \(d'\): fica mais difícil distinguir palavras estudadas de palavras novas.
Uma hipótese diferente é que a pessoa se torne mais cautelosa ao responder «antiga», deslocando o critério no sentido conservador e aumentando \(c\). Também seria possível uma mudança no sentido oposto. Precisamos de analisar as taxas de acertos e de falsos alarmes em cada condição para separar estas possibilidades.
- Explique quando uma regressão logística sobre correcto/incorrecto responde à pergunta e quando a decomposição da SDT acrescenta algo essencial.
Solução 6 — Exactidão ou Detecção de Sinal?
A regressão logística sobre correcto/incorrecto é adequada se a pergunta for sobre a probabilidade de responder correctamente, desde que a estrutura do estudo seja bem representada.
Se queremos saber por que essa probabilidade mudou, vale a pena distinguir tentativas com e sem sinal. Uma mudança pode resultar de melhor discriminação, de um critério mais liberal ou conservador, ou de ambos. A SDT separa esses componentes sob pressupostos específicos acerca das distribuições de evidência. Também podemos modelar as respostas «sim/não» directamente com preditores que representem o estado do sinal e a condição.
- Numa tarefa de memória, 20% das palavras são antigas e uma pessoa responde sempre «nova». Um investigador decide repetir a experiência com igual número de palavras antigas e novas. O que melhora com esta decisão? E por que poderá continuar a ser útil calcular \(d'\) e \(c\)?
Solução 7 — Delineamento e Discriminação
No primeiro delineamento, a pessoa teria 80% de respostas correctas apenas por dizer sempre «nova». Com o mesmo número de alvos e distractores, essa estratégia produziria 50% de respostas correctas. O novo delineamento torna a exactidão global mais fácil de interpretar e impede que a resposta mais frequente seja favorecida pelo número de estímulos.
Ainda assim, a exactidão pode melhorar porque a pessoa discrimina melhor ou porque mudou o critério. O equilíbrio, por si só, não separa essas possibilidades. As taxas de acertos e falsos alarmes permitem calcular \(d'\) e \(c\) e estudar a discriminação e a tendência de resposta, sob os pressupostos da SDT.
Se a pergunta de investigação for apenas a percentagem de decisões correctas numa tarefa equilibrada, podemos responder com essa percentagem, sem precisar dos índices da SDT.
14 Recursos
- Stanislaw, H., & Todorov, N. (1999). Calculation of signal detection theory measures. Behavior Research Methods, Instruments, & Computers, 31(1), 137–149. https://doi.org/10.3758/BF03207704
- Hautus, M. J. (1995). Corrections for extreme proportions and their biasing effects on estimated values of d’. Behavior Research Methods, Instruments, & Computers, 27, 46–51. https://doi.org/10.3758/BF03203619
- Herzog, M. H., Francis, G., & Clarke, A. (2019). Experimental design and the basics of statistics: Signal Detection Theory (SDT). In Understanding Statistics and Experimental Design. https://doi.org/10.1007/978-3-030-03499-3_2
- Maniscalco, B., Charles, L., & Peters, M. A. K. (2025). Optimal metacognitive decision strategies in signal detection theory. Psychonomic Bulletin & Review, 32, 1041–1069. https://doi.org/10.3758/s13423-024-02510-7
- Documentação de
psycho::dprime() - Modelos Lineares Generalizados