install.packages(c("ggplot2", "dplyr", "palmerpenguins"))Gráficos no R
Programação
Gráficos
ggplot2
Visualizar
Escolher, construir e interpretar gráficos com ggplot2.
0 Gráficos: Tornar uma Pergunta Visível
Um gráfico ajuda-nos a explorar uma pergunta. Na estatística descritiva, permite ver a distribuição das observações, comparar grupos e explorar relações entre variáveis. Neste tutorial seguimos sempre o mesmo percurso:
pergunta → variáveis e delineamento → escolha gráfica → código → leitura → ajustes
Escolha o gráfico pela pergunta: quer observar uma distribuição, comparar grupos, explorar uma relação ou acompanhar mudanças na mesma unidade? O tipo de variável também importa, mas não determina sozinho qual o gráfico mais útil. Os manuais apresentam habitualmente barras para categorias, histogramas para distribuições e gráficos de dispersão para duas variáveis quantitativas. Este vocabulário é útil e vamos usá-lo; a escolha final depende do que queremos ver.
Use esta página com o R aberto. Escreva e altere os exemplos em vez de os coleccionar como receitas. Para começar, não é preciso saber ainda trabalhar com modelos: cada secção diz que pergunta o gráfico serve e o que a figura não permite concluir. Se chegou aqui depois de resumir dados, o tutorial de descritivas explica os números que estes gráficos complementam. A teoria das descritivas ajuda a decidir o que cada resumo mostra, e Delineamento da Investigação ajuda quando a unidade de observação ou a replicação não são óbvias. Para estimativas e incerteza de um modelo, siga para modelos lineares.
Wickham e colaboradores (2023) têm uma introdução extensa e interactiva à visualização. Vale a pena consultá-la depois de experimentar os exemplos daqui.
DicaPorquê olhar para os dados?
Num gráfico podemos apreender rapidamente várias características ao mesmo tempo: forma, grupos, lacunas, valores extremos e relações. Hoje, gerar estas representações faz parte do mesmo fluxo de trabalho que calcular média, mediana, desvio-padrão e outros sumários. Primeiro vemos a estrutura global; depois usamos os números para localizar e quantificar aspectos que nos interessam.
A demonstração Same Stats, Different Graphs, da Autodesk Research mostra conjuntos visualmente muito diferentes que conservam praticamente os mesmos sumários. A ideia começa no quarteto de Anscombe e é desenvolvida por Matejka e Fitzmaurice (2017) com o Datasaurus Dozen. Para a explicação estatística e as referências, veja Estatística Descritiva — A Forma nos Gráficos.
ImportanteAntes do Gráfico: O Que É uma Observação?
Uma linha pode representar um pinguim, uma pessoa, uma medição repetida ou a contagem de muitos casos. Antes de escolher geom_point(), escreva o que cada marca representa. Mais pontos não criam mais unidades independentes. Se a mesma unidade foi medida várias vezes, veja medidas repetidas.
1 Preparação
Vamos usar ggplot2, dplyr e os pinguins do pacote palmerpenguins. Instale cada pacote uma vez na consola, não dentro de um script ou documento Quarto.
tibble [344 × 5] (S3: tbl_df/tbl/data.frame)
 $ flipper_length_mm: int [1:344] 181 186 195 NA 193 190 181 195 193 190 ...
 $ body_mass_g      : int [1:344] 3750 3800 3250 NA 3450 3650 3625 4675 3475 4250 ...
 $ species          : Factor w/ 3 levels "Adelie","Chinstrap",..: 1 1 1 1 1 1 1 1 1 1 ...
 $ sex              : Factor w/ 2 levels "female","male": 2 1 1 NA 1 2 1 2 NA NA ...
$ island : Factor w/ 3 levels "Biscoe","Dream",..: 3 3 3 3 3 3 3 3 3 3 ...flipper_length_mm body_mass_g species sex
2 2 0 11
island
0 n_before <- nrow(ds)
ds <- ds[complete.cases(ds[, plot_variables]), plot_variables,
drop = FALSE]
c(before = n_before, used = nrow(ds), removed = n_before - nrow(ds)) before used removed
344 333 11 Este passo conserva 333 dos 344 pinguins e retira 11 linhas incompletas nas cinco variáveis seleccionadas. Usamos a mesma amostra nos exemplos principais para facilitar a comparação entre gráficos. palmerpenguins::penguins continua intacto. É só em ds que ficamos com estes 333 casos.
No tutorial de descritivas, cada resumo podia usar todos os valores disponíveis da sua variável. Aqui, mesmo um histograma só da massa usa os 333 casos, por isso as contagens e os resumos podem diferir entre páginas. Num gráfico próprio, não exclua automaticamente uma linha por faltar uma variável que o gráfico nem usa. Escolha os casos de acordo com as variáveis necessárias e registe as exclusões.
2 Da Pergunta ao Primeiro Gráfico
Pergunta. O comprimento da barbatana e a massa corporal variam juntos, e o padrão parece igual entre espécies e sexos?
Variáveis e delineamento. São duas medidas quantitativas por pinguim. Espécie e sexo identificam grupos observados, não tratamentos aleatoriamente atribuídos. Cada ponto deve, portanto, representar um pinguim.
No ggplot2, um gráfico é construído por camadas. Em vez de saltarmos logo para a figura final, vamos acrescentar uma decisão de cada vez. Os separadores permitem comparar o código sem empilhar quatro figuras quase iguais na página.
Começamos apenas com posição: uma medida no eixo x e outra no eixo y.
ggplot(ds, aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point()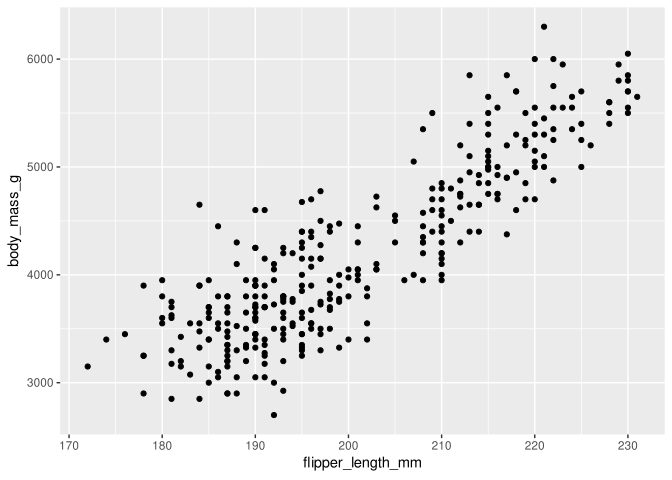
Agora mapeamos a espécie simultaneamente para cor e forma. O gráfico passa a perguntar se a relação parece semelhante entre espécies.
ggplot(ds, aes(x = flipper_length_mm, y = body_mass_g,
               colour = species, shape = species)) +
  geom_point()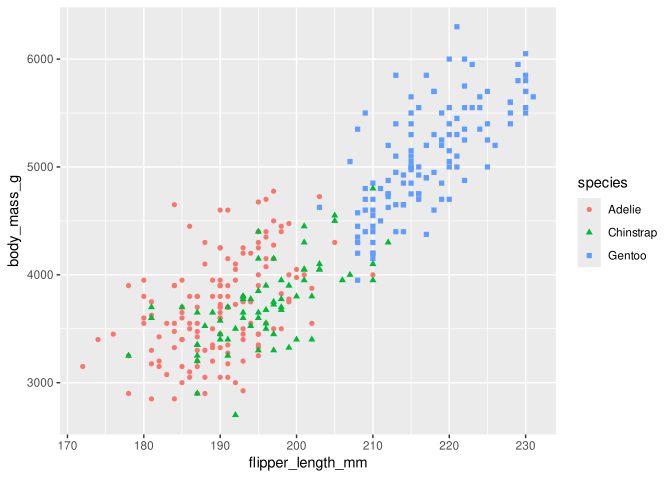
Em vez de acrescentar mais uma estética aos mesmos pontos, usamos painéis para comparar os sexos mantendo as escalas.
ggplot(ds, aes(x = flipper_length_mm, y = body_mass_g,
               colour = species, shape = species)) +
  geom_point() +
  facet_wrap(~ sex)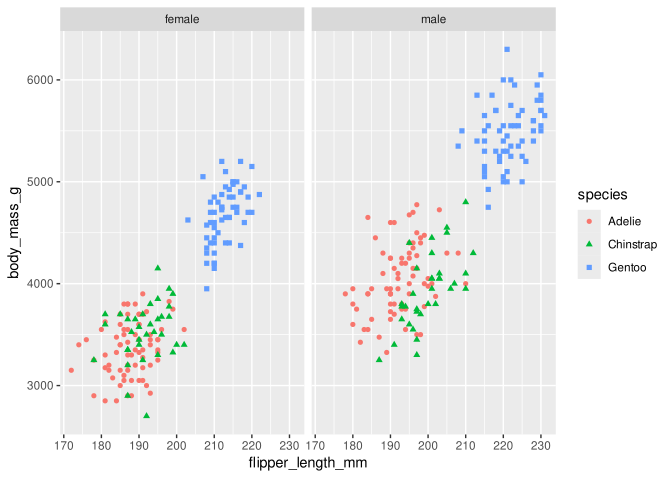
Só no fim ajustamos transparência, tamanho, tema e rótulos. Estas alterações melhoram a leitura. Não acrescentam uma nova variável.
ggplot(ds, aes(x = flipper_length_mm, y = body_mass_g,
               colour = species, shape = species)) +
  geom_point(alpha = 0.65, size = 2) +
  facet_wrap(~ sex) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species", shape = "Species")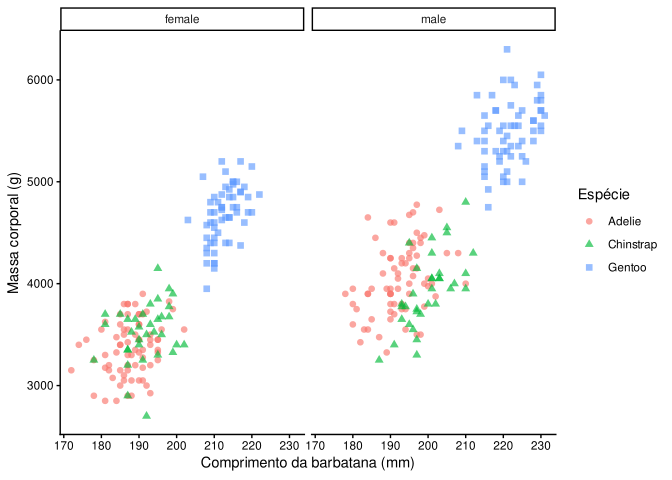
Esta sequência mostra a ideia central da gramática de gráficos: começamos pelos dados e pelos mapeamentos e acrescentamos camadas quando elas respondem a uma pergunta. Dentro de aes(), uma coluna é mapeada para uma propriedade visual e surge normalmente uma legenda. Fora de aes(), a propriedade fica fixa para todos os casos:
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(colour = "grey35", alpha = 0.65)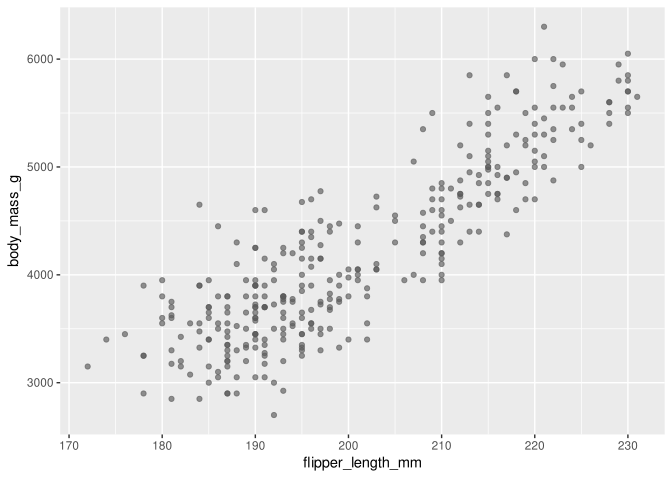
Compare com o segundo separador: colour = species mapeia informação. colour = "grey35" apenas escolhe a aparência.
O que está visível? Tendências, sobreposição, intervalos sem dados e possíveis diferenças entre grupos. O que fica escondido? A incerteza de um declive, idade, ilha, amostragem e quaisquer pinguins excluídos por valores em falta. O que é inferível? Uma associação descritiva, não o efeito causal de alterar uma barbatana.
3 Como É a Distribuição?
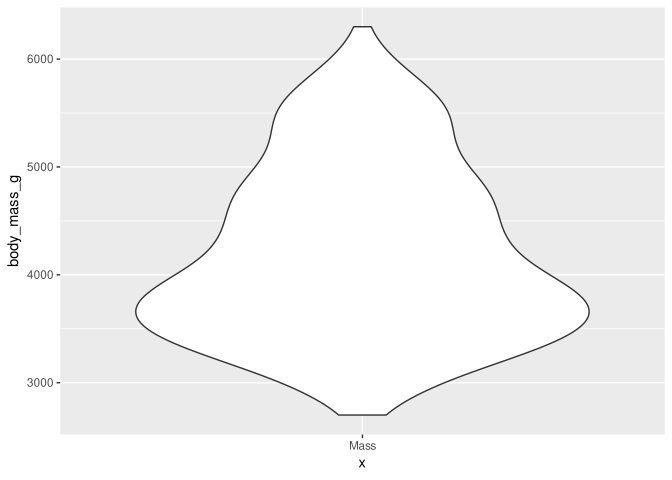
A forma de uma variável também beneficia de construção gradual. Histograma e densidade não são rivais que obrigam a escolher um vencedor: mostram a mesma distribuição com decisões diferentes de agrupamento ou suavização.
Pergunta. A massa corporal tem assimetria, lacunas, grupos ou mais de um pico?
Começamos com uma largura de classe explícita.
ggplot(ds, aes(body_mass_g)) +
  geom_histogram(
    binwidth = 250,
    boundary = 0,
    fill = "grey70",
    colour = "white"
  ) +
  theme_classic() +
  labs(x = "Body mass (g)", y = "Number of penguins")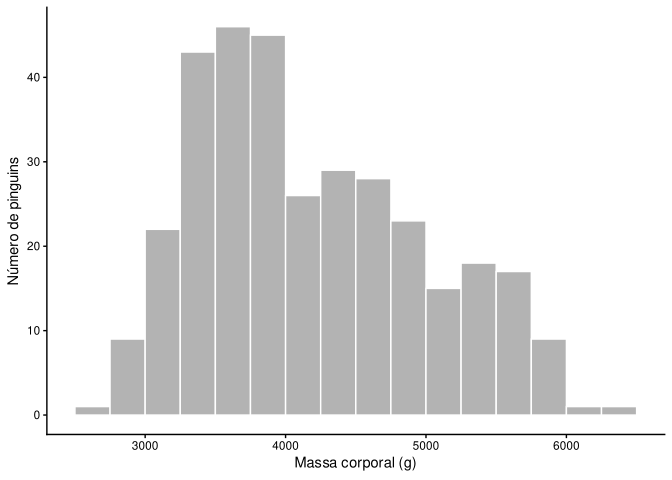
Mudamos uma única decisão. Um padrão que desaparece quando passamos de 250 para 500 g por classe merece cautela.
ggplot(ds, aes(body_mass_g)) +
  geom_histogram(
    binwidth = 500,
    boundary = 0,
    fill = "grey70",
    colour = "white"
  ) +
  theme_classic() +
  labs(x = "Body mass (g)", y = "Number of penguins")
A densidade suaviza a distribuição. É útil para ver a forma, mas a altura já não é uma contagem de observações.
ggplot(ds, aes(body_mass_g)) +
  geom_density(fill = "grey80", alpha = 0.6) +
  theme_classic() +
  labs(x = "Body mass (g)", y = "Density")
Por fim combinamos histograma e densidade e separamos espécie e sexo em painéis. A complexidade só aparece depois de sabermos o que cada camada faz.
ggplot(ds, aes(body_mass_g)) +
  geom_histogram(
    aes(y = after_stat(density)),
    binwidth = 250,
    fill = "grey75",
    colour = "white"
  ) +
  geom_density(colour = "black", linewidth = 0.7) +
  facet_grid(sex ~ species) +
  theme_classic() +
  labs(x = "Body mass (g)", y = "Density")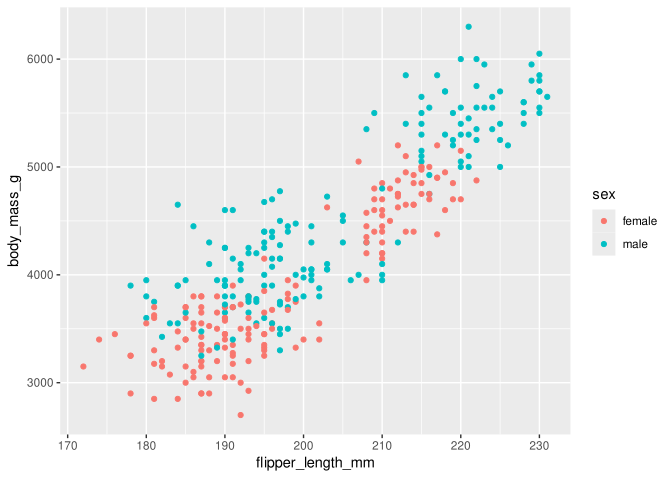
Compare os separadores. A escolha de binwidth muda detalhes do histograma. A densidade introduz suavização. Os painéis revelam que parte da forma global resulta da mistura de grupos. Nenhuma destas figuras, sozinha, diz quantas populações biológicas existem ou estabelece uma explicação causal.
DicaMostrar Também o N
Quando o tamanho dos grupos importa, conte-o ou mostre os pontos. Uma densidade normalizada pode parecer igualmente alta para grupos com números de observações muito diferentes.
4 Grupos: Diferenças, Variação e Incerteza
Uma barra é um gráfico convencional para contagens. Barras de médias são comuns, mas a sua base em zero e a ocultação dos dados individuais tornam-nas frequentemente uma escolha fraca para uma resposta contínua. Comecemos por ver distribuição e casos.
Comparar Grupos Contínuos
Pergunta. Como varia a massa entre espécies e sexos, e quanta sobreposição existe?
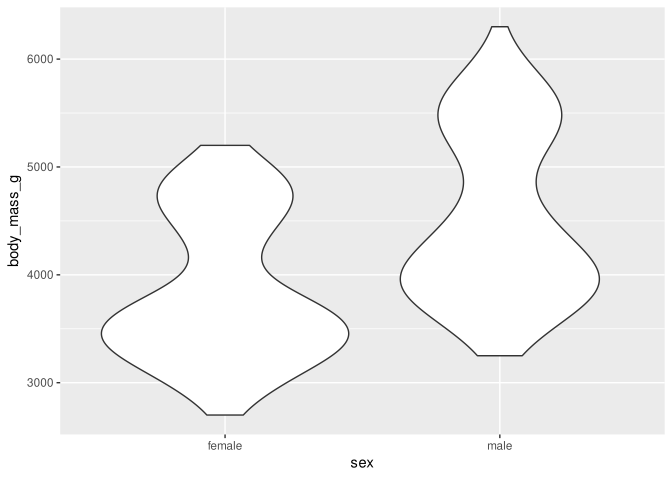
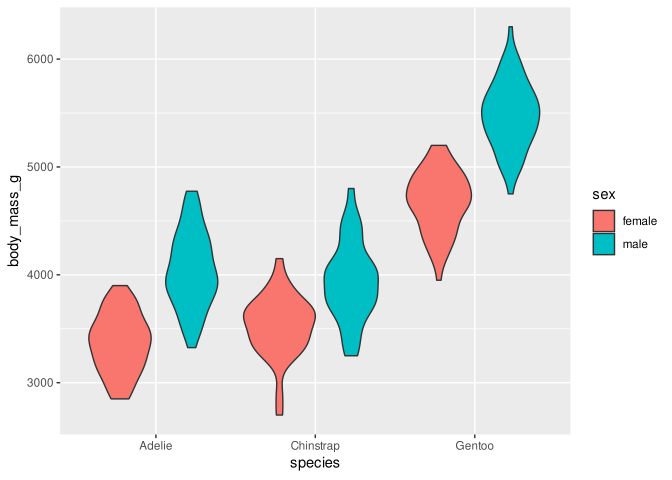
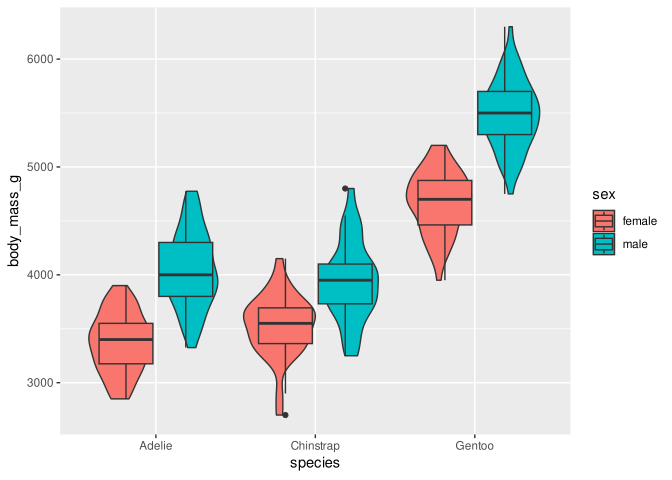
Escolha. Começamos pelos pontos, que mostram os casos. Depois podemos acrescentar uma caixa para resumir quartis e, se a forma da distribuição for importante, um violino para representar uma densidade aproximada. Os separadores mostram esta construção por camadas sem obrigar a percorrer três figuras completas na vertical.
ggplot(ds, aes(species, body_mass_g, shape = sex)) +
  geom_jitter(width = 0.12, alpha = 0.5) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)", shape = "Sex")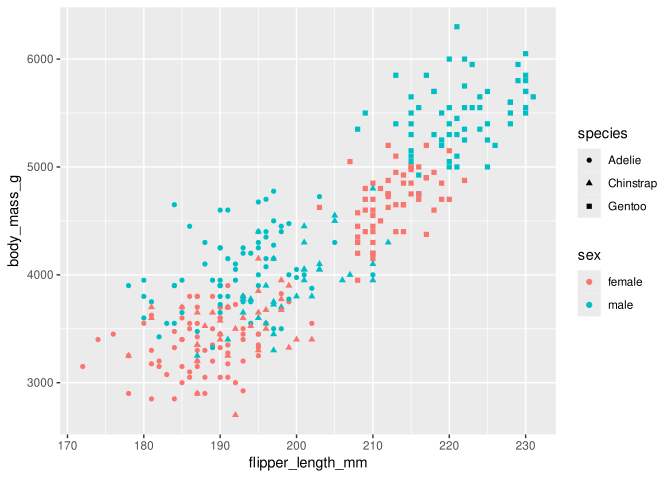
ggplot(ds, aes(species, body_mass_g, fill = sex)) +
  geom_boxplot(position = position_dodge(width = 0.8), width = 0.5,
               outlier.shape = NA, alpha = 0.55) +
  geom_point(aes(shape = sex),
             position = position_jitterdodge(jitter.width = 0.10, dodge.width = 0.8),
             alpha = 0.35, size = 1.5) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)",
       fill = "Sex", shape = "Sex")
ggplot(ds, aes(species, body_mass_g, fill = sex)) +
  geom_violin(position = position_dodge(width = 0.8), alpha = 0.55,
              colour = "grey30") +
  geom_boxplot(position = position_dodge(width = 0.8), width = 0.18,
               outlier.shape = NA, alpha = 0.85) +
  geom_point(aes(shape = sex),
             position = position_jitterdodge(jitter.width = 0.10, dodge.width = 0.8),
             alpha = 0.35, size = 1.5) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)",
       fill = "Sex", shape = "Sex")
Compare os três separadores. Em qual é mais fácil ver cada pinguim, os quartis ou a forma aproximada? Há alguma camada que não esteja a ajudar a sua leitura? Visível: conforme a versão, valores individuais, mediana, quartis, densidade aproximada e sobreposição. Escondido: incerteza sobre uma população e causas das diferenças. Inferível: diferenças descritivas nos pinguins observados. Limite: violinos são instáveis em grupos pequenos. O boxplot não decide se um valor é «mau» nem se deve ser removido.
Incerteza: Dados e Estimativa Não São a Mesma Camada
Pergunta. Qual é a média de cada espécie e quão precisa é essa estimativa?
Uma média com intervalo pode responder a uma pergunta sobre uma estimativa, mas deve dizer que estatística e que intervalo desenha. Abaixo calculamos, de forma transparente, intervalos de confiança t para a média de cada espécie, com os graus de liberdade de cada grupo. Este cálculo pressupõe observações independentes dentro de cada grupo e uma amostragem e distribuição que tornem o intervalo t apropriado. Não substitui um modelo quando o delineamento exige covariáveis ou outra estrutura de dependência.
Com group_by() separamos as espécies e com summarise() calculamos o número de casos, a média e o erro-padrão em cada grupo. Depois, mutate() acrescenta os limites do intervalo de confiança de 95%.
species_summary <- ds |>
  group_by(species) |>
  summarise(n = n(), mean = mean(body_mass_g), se = sd(body_mass_g) / sqrt(n)) |>
  # Use a t critical value separately for each group's degrees of freedom.
  mutate(t_critical = qt(.975, df = n - 1),
         lower_limit = mean - t_critical * se,
         upper_limit = mean + t_critical * se)

# Observed points in the background; estimates and intervals on top.
ggplot(ds, aes(species, body_mass_g)) +
  geom_jitter(width = 0.12, alpha = 0.25, colour = "grey35") +
  geom_errorbar(data = species_summary,
                aes(x = species, ymin = lower_limit, ymax = upper_limit),
                width = 0.12, linewidth = 0.7, inherit.aes = FALSE) +
  geom_point(data = species_summary, aes(x = species, y = mean),
             inherit.aes = FALSE, size = 2.8, shape = 21, fill = "white") +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)")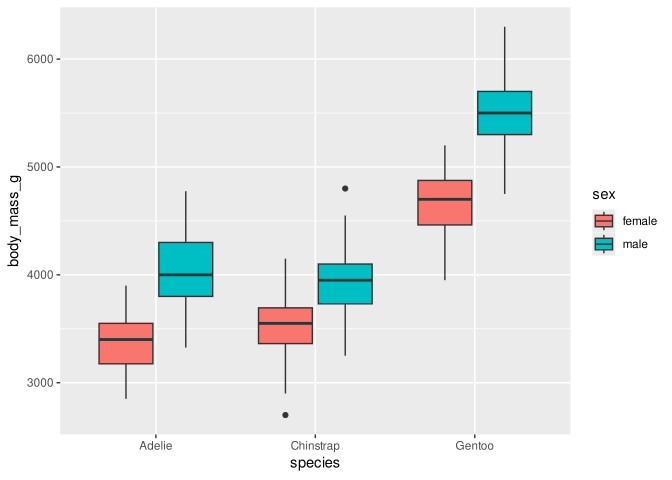
O intervalo quantifica a precisão da média sob as condições declaradas. Não é a amplitude dos valores individuais nem um intervalo de previsão para um novo pinguim. A distinção entre dispersão dos dados e incerteza da média é explicada nos Fundamentos da Inferência. Compare a largura dos intervalos: que espécie tem a média menos precisa, e que característica dos dados poderá explicá-lo?
Estes são intervalos de confiança frequentistas. Para calcular a probabilidade de a média populacional estar num dado intervalo, precisaríamos de uma abordagem bayesiana. Precisamos também de saber como os pinguins foram amostrados para decidir a que população podemos generalizar. Para médias marginais estimadas, contrastes e intervalos de um modelo, prossiga para modelos lineares.
5 Relações: Linhas, Grupos e Sobreposição
Pergunta. A associação massa–barbatana parece linear e igual entre espécies e sexos?
Uma linha ajustada é mais uma camada, portanto convém perceber o que mudou em cada passo. Os separadores seguintes recuperam a lógica incremental: dados, modelo simples, grupos e painéis.
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(alpha = 0.5) +
  theme_classic() +
  labs(
    x = "Flipper length (mm)",
    y = "Body mass (g)"
  )
Agora acrescentamos uma regressão linear global. Ela resume todos os pinguins como se uma única relação fosse suficiente.
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(alpha = 0.45) +
  geom_smooth(method = "lm", se = TRUE) +
  theme_classic() +
  labs(
    x = "Flipper length (mm)",
    y = "Body mass (g)"
  )
Mapear a espécie muda a pergunta: passamos a deixar que cada espécie tenha a sua própria linha no gráfico.
ggplot(
  ds,
  aes(
    flipper_length_mm,
    body_mass_g,
    colour = species,
    shape = species
  )
) +
  geom_point(alpha = 0.45) +
  geom_smooth(
    aes(linetype = species),
    method = "lm",
    se = TRUE,
    linewidth = 0.8,
    show.legend = FALSE
  ) +
  theme_classic() +
  labs(
    x = "Flipper length (mm)",
    y = "Body mass (g)",
    colour = "Species",
    shape = "Species",
    linetype = "Species"
  )
Finalmente separamos simultaneamente sexo e espécie. Ganhamos legibilidade dentro dos grupos, mas perdemos alguma visão da sobreposição entre eles.
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(alpha = 0.45, colour = "grey35") +
  geom_smooth(method = "lm", se = TRUE, colour = "black") +
  facet_grid(sex ~ species) +
  theme_classic() +
  labs(
    x = "Flipper length (mm)",
    y = "Body mass (g)"
  )
A primeira recta pode resumir sobretudo diferenças entre espécies, enquanto as rectas por espécie mostram associações dentro de cada grupo. É uma boa razão para não tratar uma camada de modelo como decoração. A linha é uma previsão condicional ao modelo linear, não uma trajectória percorrida por cada pinguim.
Uma estética discreta mapeada, como colour = species, habitualmente fornece o agrupamento que geom_smooth() deve usar. Precisamos de group explicitamente quando o agrupamento desejado não está representado por outra estética, como nas linhas que ligam medições repetidas pelo ID.
Visível: curvatura aparente, dispersão, diferenças de declive e zonas sem dados. Escondido: confundidores, dependência e causalidade. Inferível: hipóteses para um modelo. Limite: painéis com poucos casos e escalas livres podem criar comparações ilusórias. Mantenha escalas comuns quando a altura ou inclinação entre painéis é a comparação.
Quando Há Demasiados Pontos
Pergunta. Onde se concentram as observações quando já não conseguimos ver cada ponto?
Sobreposição (overplotting) pode transformar centenas de observações numa mancha muito convincente e pouco informativa. Transparência ajuda. geom_bin2d() conta observações em células e revela densidade sem fingir que todos os pontos são visíveis.
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_bin2d(bins = 18) +
  scale_fill_viridis_c(name = "N per cell") +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)")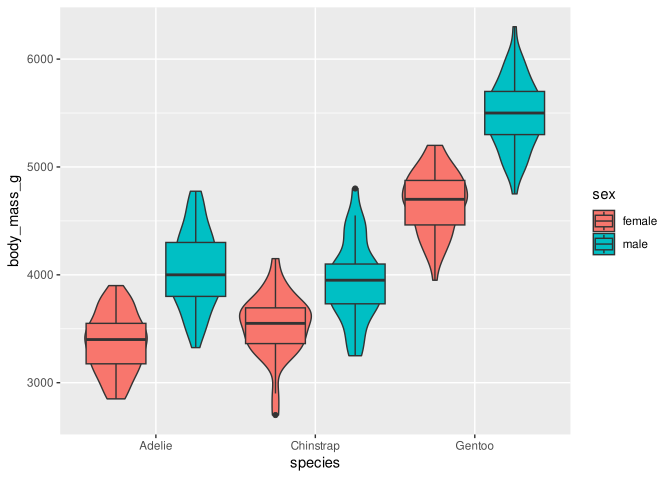
A posição e a legenda continuam a comunicar: não use a cor, por si só, para concluir onde há mais casos. Altere bins e veja se o padrão é robusto.
6 Mudança Dentro de Unidades Repetidas
Pergunta. Como mudou o resultado de cada participante entre dois momentos?
Linhas são frequentemente lidas como mudança no tempo. Essa leitura só é apropriada quando os pontos ligados pertencem à mesma unidade e a ordem de x tem significado. O exemplo seguinte é simulado, apenas para mostrar a decisão gráfica.
set.seed(2025)
repeated <- expand.grid(
  participant = factor(sprintf("P%02d", 1:18)),
  time = factor(c("pre", "post"), levels = c("pre", "post"))
)
person_effect <- rnorm(18, 50, 7)
repeated$score <- person_effect[as.integer(repeated$participant)] +
  ifelse(repeated$time == "post", 4, 0) +
  rnorm(nrow(repeated), 0, 3)

ggplot(repeated, aes(time, score, group = participant)) +
  geom_line(alpha = 0.35) +
  geom_point(alpha = 0.65) +
  theme_classic() +
  labs(x = "Time", y = "Score")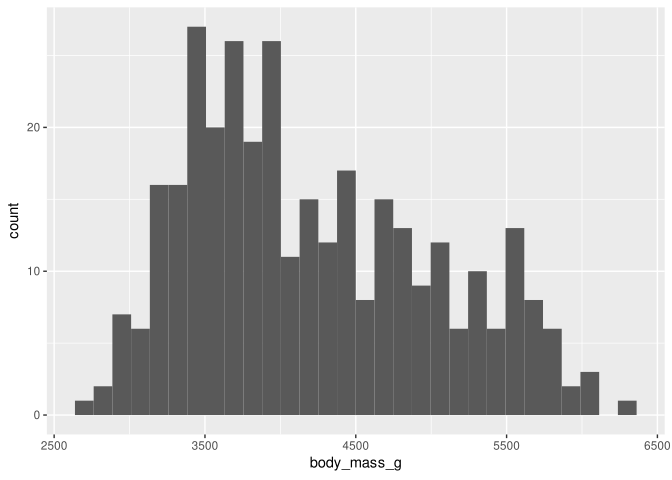
Visível: direcção e heterogeneidade das mudanças de cada participante. Escondido: uma estimativa populacional, a incerteza e se a ordem temporal é causal. Inferível: que as linhas estão emparelhadas e que um modelo deve reconhecer a dependência. Limite: ligar grupos diferentes com linhas cria uma falsa história individual. Para a análise, consulte medidas repetidas.
7 Contagens e Proporções: O Denominador Também É Informação
As barras são especialmente naturais quando a altura representa contagens ou proporções. Também aqui compensa construir a figura por etapas.
Quantos pinguins observados há por espécie?
ggplot(ds, aes(species)) +
  geom_bar(fill = "grey55") +
  theme_classic() +
  labs(x = "Species", y = "Number of penguins")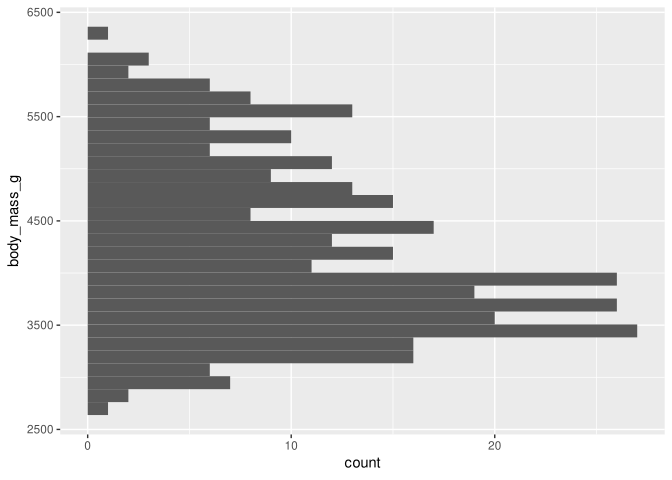
Agora queremos ver as contagens de cada sexo dentro de cada espécie. As barras lado a lado preservam o denominador em contagens.
ggplot(ds, aes(species, fill = sex)) +
  geom_bar(position = "dodge") +
  theme_classic() +
  labs(x = "Species", y = "Number of penguins", fill = "Sex")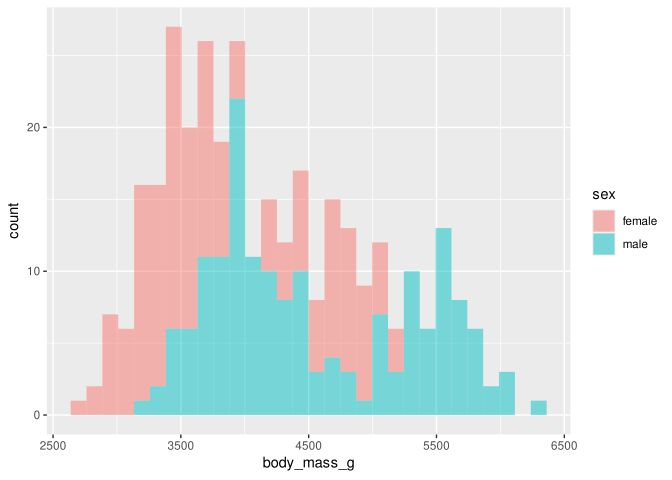
A mesma tabela pode ser normalizada para que cada espécie tenha altura 1. Agora a figura responde à composição relativa, não ao tamanho da amostra.
ggplot(ds, aes(species, fill = sex)) +
  geom_bar(position = "fill") +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  theme_classic() +
  labs(x = "Species", y = "Proportion within species", fill = "Sex")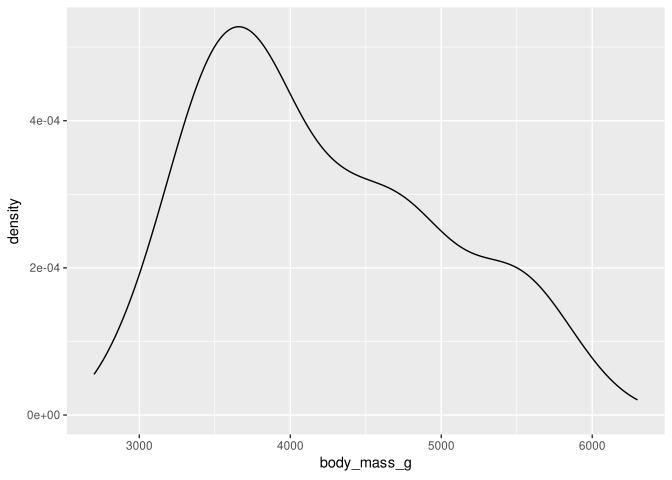
Se quisermos controlar directamente o cálculo, construímos primeiro a tabela. Isto torna visível qual é o denominador usado em cada proporção.
counts <- as.data.frame(table(ds$species, ds$sex))
names(counts) <- c("species", "sex", "n")
counts$species_total <- ave(counts$n, counts$species, FUN = sum)
counts$proportion <- counts$n / counts$species_total
counts$label <- paste0(round(100 * counts$proportion), "%")

ggplot(counts, aes(species, proportion)) +
  geom_col(fill = "grey55") +
  geom_text(aes(label = label), vjust = -0.35, size = 3.2) +
  facet_wrap(~ sex) +
  scale_y_continuous(
    labels = function(x) paste0(round(100 * x), "%"),
    expand = expansion(mult = c(0, 0.12))
  ) +
  theme_classic() +
  labs(x = "Species", y = "Proportion within species")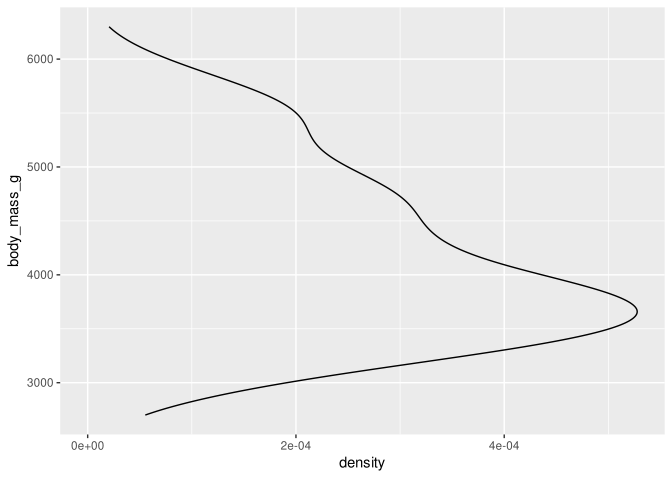
geom_bar() conta linhas. Para dados já resumidos, use geom_col() e uma coluna y. Ao passar dos dois primeiros separadores para os dois últimos, mudamos também de pergunta: em vez de quantos casos?, perguntamos que fracção do grupo?. Uma proporção sem denominador é informação incompleta.
Estas figuras são descritivas da amostra. Para respostas binárias, proporções, contagens, exposição e incerteza, veja GLMs para proporções e contagens.
8 Escalas, Coordenadas, Rótulos e Anotações
Transformar a Escala sem Apagar Dados
Pergunta. Uma escala em que distâncias iguais representam razões torna o padrão mais legível sem alterar as observações incluídas?
Uma escala logarítmica é útil quando razões (duplicar, metade) são mais interpretáveis do que diferenças ou quando poucos valores grandes comprimem o resto. Não a use para fazer um padrão «mais bonito». Diga que transformação usou e evite-a para valores zero ou negativos sem uma decisão justificada.
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species,
               shape = species)) +
  geom_point(alpha = 0.65) +
  scale_y_log10() +
  theme_classic() +
  labs(x = "Flipper length (mm)",
       y = "Body mass (g; log10 scale)", colour = "Species", shape = "Species")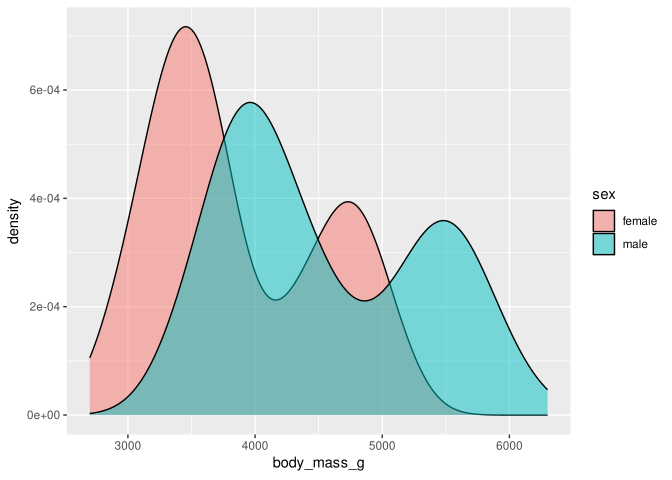
coord_cartesian(ylim = c(3000, 6500)) faz zoom sem remover observações do cálculo das camadas. scale_y_continuous(limits = c(3000, 6500)) descarta valores fora dos limites antes de estatísticas como uma linha suavizada. Esta diferença evita que um ajuste visual altere também os dados usados no cálculo.
Destacar sem Esconder o Resto
Pergunta. Que observações pertencem à região de barbatanas com pelo menos 210 mm e massa a partir de 5000 g?
Uma anotação deve ajudar a responder à pergunta, sem desviar a atenção dos dados. Aqui marcamos essa região e dizemos explicitamente qual foi a regra.
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species,
               shape = species)) +
  geom_point(alpha = 0.6) +
  annotate("rect", xmin = 210, xmax = Inf, ymin = 5000, ymax = Inf,
           fill = "gold", alpha = 0.15, colour = NA) +
  annotate("text", x = 211, y = 6250, label = "Highlighted region",
           hjust = 0, colour = "black") +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species", shape = "Species")
Visível: a regra de destaque e os pontos que a satisfazem. Escondido: por que esses valores existem e se são erros. Inferível: apenas que foram seleccionados por esta regra gráfica. Limite: não rotule observações como «outliers» para as apagar sem verificar a recolha e a pergunta.
Um Tema É Parte da Comunicação
theme_classic() e theme_minimal() reduzem ruído visual. Comece por rótulos com unidades, uma legenda com nome e texto legível. Só depois ajuste detalhes. Evite gráficos 3D, texto minúsculo, grelhas decorativas, paletas sem contraste e eixos truncados que exagerem diferenças. Para comparar magnitudes, mantenha um zero significativo em barras. Para pontos e intervalos, um recorte pode ser legítimo se for declarado e não esconder dados relevantes.
NotaReconhecer Gráficos Base do R
Antes do ggplot2, e ainda hoje em muitos scripts, encontrará funções base como plot(), hist(), boxplot(), qqnorm() e qqline(). Não é preciso aprender aqui uma segunda gramática completa: reconheça que estas funções desenham directamente a partir de vectores ou fórmulas, e consulte ?plot ou a documentação de gráficos base quando encontrar esse código. qqline() acrescenta uma linha de referência a um gráfico criado por qqnorm(). A linha não transforma o gráfico num teste automático de normalidade.
Ao encontrar estas figuras num script, consegue dizer que variável ou relação cada uma mostra e que informação precisaria antes de a interpretar?
9 Coordenadas, Facetas e Legendas
Já sabemos escolher as variáveis e as camadas. Falta experimentar algumas maneiras de organizar a figura sem mudar a pergunta nem os dados.
Categorias na Vertical
Quando os nomes das categorias são longos, colocar a medida no eixo horizontal evita rodar ou abreviar os rótulos. Aqui voltamos às caixas de massa por espécie, mas trocamos as posições de species e body_mass_g:
ggplot(ds, aes(body_mass_g, species)) +
  geom_boxplot() +
  theme_classic() +
  labs(x = "Body mass (g)", y = "Species")
Compare com as caixas anteriores: os quartis são os mesmos, mas agora lemos a massa da esquerda para a direita. Em código mais antigo encontrará coord_flip() para trocar os eixos de uma figura já construída.
Separar as Ilhas
Podemos usar painéis para procurar diferenças entre ilhas. Mantemos a espécie indicada por cor e forma para perceber também que espécies aparecem em cada ilha:
ggplot(ds, aes(flipper_length_mm, body_mass_g,
               colour = species, shape = species)) +
  geom_point(alpha = 0.6) +
  facet_wrap(~ island) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species", shape = "Species")
Procure uma espécie que apareça em mais de uma ilha. É mais fácil comparar a sua distribuição agora do que no gráfico sem painéis? As escalas comuns permitem comparar posições directamente. Usar scales = "free" daria mais espaço a cada nuvem de pontos, mas perderíamos essa comparação imediata de comprimentos e massas. Além disso, uma diferença entre painéis pode reflectir a composição por espécie, não apenas a ilha.
Tema e Legenda
Um tema altera o fundo, a grelha e o texto, sem mudar os mapeamentos nem os resumos estatísticos. Guardamos o gráfico para comparar duas apresentações dos mesmos pontos:
island_plot <- ggplot(ds, aes(flipper_length_mm, body_mass_g,
                              colour = species, shape = species)) +
  geom_point(alpha = 0.6) +
  facet_wrap(~ island) +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
colour = "Species", shape = "Species")island_plot + theme_classic()
island_plot +
  theme_minimal(base_size = 12) +
  theme(
    panel.grid.minor = element_blank(),
    legend.position = "bottom"
  )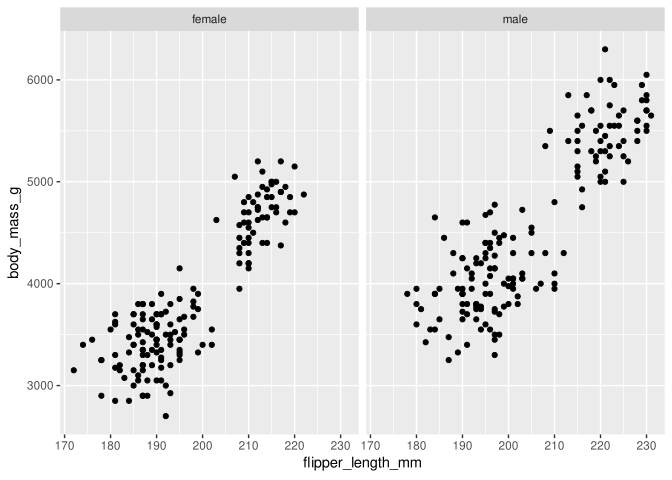
A grelha principal pode ajudar a alinhar pontos com os valores dos eixos; retirar a grelha secundária deixa menos linhas a competir com os dados. base_size define o tamanho de referência do texto. A legenda em baixo liberta espaço ao lado dos painéis, mas pode precisar de mais largura quando há muitas categorias. theme() vem depois do tema completo para que os seus ajustes não sejam substituídos por ele.
Compare as duas versões no tamanho em que pretende publicá-las. Consegue ler os eixos e distinguir as espécies sem depender apenas da cor? Para outras paletas e ajustes, consulte a documentação de escalas do ggplot2 e a documentação de temas.
10 Exercícios: Decidir Antes de Desenhar
Tente resolver sem copiar literalmente os exemplos. Em cada resposta, registe as variáveis, a unidade observacional, a escolha gráfica e uma limitação da leitura. A solução de cada exercício pode ser aberta logo a seguir; em exercícios abertos, a solução mostra uma decisão possível e explica por que razão ela é adequada.
- Escolha uma variável quantitativa de
ds. Faça dois histogramas com larguras de classe diferentes. Que padrão aparece nos dois, qual muda e que decisão tomaria antes de o descrever?
Solução 1: Largura das Classes
Usamos body_mass_g, porque é quantitativa e tem unidades claras. A largura menor mostra mais detalhe; a maior torna a forma geral mais estável para uma leitura rápida.
ggplot(ds, aes(body_mass_g)) +
  geom_histogram(binwidth = 250, boundary = 0, colour = "white")
ggplot(ds, aes(body_mass_g)) +
  geom_histogram(binwidth = 500, boundary = 0, colour = "white")
Nos dois gráficos procuramos a concentração principal e possíveis lacunas, não um número exacto de grupos. Antes de descrever um pico, alteraria ainda a largura e verificaria se ele persiste. O histograma mostra a distribuição dos pinguins observados, mas não resolve a dependência, a amostragem ou a causa de qualquer diferença.
- Redesenhe a comparação de massa por espécie sem
fill; use posição, forma, painéis ou rótulos para que continue legível a alguém que não distingue cores. Explique o que cada versão esconde.
Solução 2: Comparar Sem Depender da Cor
Uma solução que não depende de cor usa a posição para a espécie e a forma para o sexo:
ggplot(ds, aes(species, body_mass_g, shape = sex)) +
  geom_jitter(width = 0.12, alpha = 0.6) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)", shape = "Sex")
A posição permite comparar a massa entre espécies e a forma acrescenta o sexo. O jitter torna casos sobrepostos visíveis. Esta versão pode ficar difícil de ler com muitas categorias de forma e não mostra tão bem a comparação contínua entre sexos como painéis separados. Para privilegiar essa comparação, podemos usar:
ggplot(ds, aes(species, body_mass_g)) +
  geom_jitter(width = 0.12, alpha = 0.6) +
  facet_wrap(~ sex) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)")
Os painéis reduzem a sobreposição entre sexos, mas tornam mais difícil ver todos os casos numa única posição e não substituem informação sobre o delineamento.
- Um colega propõe barras de médias para
body_mass_g. Faça uma versão que inclua os dados individuais e outra que inclua uma estimativa com intervalo. Que pergunta cada uma responde? Que denominador ou delineamento ainda falta conhecer?
Solução 3: Dados e Incerteza
Primeiro mostramos cada pinguim. Assim podemos ver dispersão, assimetria e casos extremos, em vez de deixar a média falar sozinha:
ggplot(ds, aes(species, body_mass_g)) +
  geom_jitter(width = 0.12, alpha = 0.35) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)")
Depois calculamos uma média e um intervalo de confiança t de 95% por espécie. O intervalo descreve a incerteza da média sob as hipóteses indicadas; não é a amplitude dos pinguins nem um intervalo de previsão para um novo pinguim.
summary_table <- ds |>
  group_by(species) |>
  summarise(n = n(), mean = mean(body_mass_g), se = sd(body_mass_g) / sqrt(n)) |>
  mutate(t_critical = qt(.975, df = n - 1),
         lower_limit = mean - t_critical * se,
         upper_limit = mean + t_critical * se)

ggplot(ds, aes(species, body_mass_g)) +
  geom_jitter(width = 0.12, alpha = 0.25) +
  geom_errorbar(data = summary_table,
                aes(x = species, ymin = lower_limit, ymax = upper_limit),
                width = 0.12, inherit.aes = FALSE) +
  geom_point(data = summary_table, aes(x = species, y = mean), inherit.aes = FALSE,
             shape = 21, fill = "white", size = 2.8) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)")
A primeira figura responde «como estão distribuídos os casos?»; a segunda acrescenta «quão precisa é a média estimada?». Ainda precisamos de saber como os pinguins foram amostrados, qual é a unidade independente e para que população se pretende generalizar.
- Faça um gráfico de dispersão de duas medidas dos pinguins e acrescente uma linha apenas se souber explicar o modelo que ela representa. Identifique uma alternativa causal plausível que o gráfico não separa.
Solução 4: Relação e Modelo
Usamos duas medidas quantitativas e uma recta linear por espécie:
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "lm", se = TRUE) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species")
geom_smooth(method = "lm") estima uma relação linear entre massa e comprimento da barbatana dentro de cada espécie; a faixa mostra a incerteza da média prevista pelo ajuste. A figura descreve associações nos dados observados. Por exemplo, tamanho corporal, idade ou condições da ilha podem contribuir para as duas medidas. Sem delineamento e análise apropriados, o gráfico não separa essas alternativas nem demonstra que alterar uma medida causaria a outra.
- Crie uma versão com
facet_wrap(~ island). Compare-a com uma versão com cor por ilha: em qual encontra mais facilmente grupos pequenos, e em qual compara mais facilmente a mesma escala?
Solução 5: Ilhas em Painéis ou Cores
As duas versões usam as mesmas variáveis, mas distribuem a informação de modo diferente:
ggplot(ds, aes(flipper_length_mm, body_mass_g)) +
  geom_point(alpha = 0.6) +
  facet_wrap(~ island) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)")

ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = island)) +
  geom_point(alpha = 0.6) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Island")
As facetas mantêm uma escala comum e tornam um grupo pequeno mais fácil de localizar dentro do seu painel, embora possam esconder a sobreposição entre ilhas. A cor conserva essa sobreposição e facilita a comparação directa de posições, mas grupos pequenos podem desaparecer por baixo de outros pontos e a figura fica dependente da leitura das cores.
- Produza uma barra de contagens e uma barra de proporções para
speciesesex. Escreva uma frase que não confunda composição com tamanho da amostra.
Solução 6: Contagens e Proporções
geom_bar() conta linhas, enquanto position = "fill" normaliza cada barra. Aqui o denominador da proporção é o total de pinguins de cada espécie:
ggplot(ds, aes(species)) +
  geom_bar(fill = "grey55") +
  theme_classic() +
  labs(x = "Species", y = "Number of penguins")

ggplot(ds, aes(species, fill = sex)) +
  geom_bar(position = "fill") +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  theme_classic() +
  labs(x = "Species", y = "Proportion within species", fill = "Sex")
Assim, uma frase adequada é: «A composição por sexo difere entre as espécies observadas; isto não significa que as espécies tenham o mesmo número de pinguins.» A primeira figura mostra tamanho da amostra por espécie; a segunda mostra composição e pode esconder diferenças no número total de casos.
- No gráfico simulado de medidas repetidas, remova
group = participante observe que as linhas deixam de representar participantes. Depois, experimentegroup = 1: porque é que uma linha única que liga os grupos pode ser enganadora? Adapte o gráfico aos seus próprios dados apenas depois de identificar a coluna ID.
Solução 7: Ligar a Mesma Pessoa
No exemplo simulado, participant identifica a unidade repetida e time tem os níveis pre e post, por esta ordem (pré–pós). A versão correcta liga apenas as duas observações da mesma pessoa:
ggplot(repeated, aes(time, score, group = participant)) +
  geom_line(alpha = 0.35) +
  geom_point(alpha = 0.65) +
  theme_classic() +
  labs(x = "Time", y = "Score")
Para observar o problema, podemos retirar o agrupamento e depois forçar um único grupo:
ggplot(repeated, aes(time, score)) +
  geom_line() +
  geom_point()

ggplot(repeated, aes(time, score, group = 1)) +
  geom_line() +
  geom_point()
Sem group = participant, o ggplot2 não recebe a identidade que deve permanecer ligada. Com group = 1, todas as observações formam uma única linha, que liga arbitrariamente pessoas diferentes e inventa uma trajectória. Antes de adaptar o código a dados próprios, confirmaria que cada ID identifica a mesma unidade em todos os momentos, que há uma observação por momento e que a ordem de time é a pretendida. O gráfico mostra direcções individuais, mas não estima por si só uma mudança populacional nem estabelece causalidade.
- Escolha um gráfico desta página e faça uma auditoria: o que está visível, escondido, inferível e limitado pelo delineamento? Depois mude uma camada para responder a uma dessas limitações.
Solução 8: Auditar um Gráfico
Auditamos a figura de dispersão por espécie do exercício 4. São visíveis as medidas de cada pinguim, a sobreposição entre espécies e as rectas ajustadas. Ficam escondidos os pinguins excluídos por valores em falta, a incerteza sobre a amostragem e variáveis como idade ou ilha. Podemos inferir associações lineares descritivas dentro das espécies, mas não um efeito causal. Uma única alteração útil é acrescentar facet_wrap(~ sex) para tornar visível uma possível diferença entre sexos:
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "lm", se = TRUE) +
  facet_wrap(~ sex) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species")
A faceta revela heterogeneidade por sexo, mas reduz o número de casos por painel e não resolve confundimento ou dependência.
Mais Exercícios
Estes exercícios são deliberadamente abertos: servem para praticar a adaptação, não para produzir uma única figura «correcta».
- Reproduza um ou mais exemplos no seu computador, evitando fazer copy-paste. Antes de começar, escreva que decisão visual o exemplo está a demonstrar.
Solução 9: Reconstruir uma Contagem
Uma reprodução completa é reconstruir o gráfico de contagens sem copiar o bloco anterior. A decisão visual é contar linhas, não comparar médias:
count_plot <- ggplot(ds, aes(species)) +
  geom_bar(fill = "grey55") +
  theme_classic() +
  labs(x = "Species", y = "Number of penguins")
count_plot
O código usa uma linha de ds por pinguim, por isso a unidade observacional é o pinguim. A altura é uma contagem da amostra observada. Não permite inferir que as espécies tenham a mesma abundância na população sem um plano de amostragem que sustente essa generalização.
- Altere um ou mais exemplos — por exemplo, acrescente uma camada, mude a aparência ou substitua uma faceta por uma codificação de grupo. Explique a que nova pergunta se torna mais fácil responder com a alteração e que informação pode ter ficado menos visível.
Solução 10: Acrescentar uma Camada
Acrescentamos pontos a uma caixa por espécie e sexo. A nova camada torna a variação e a sobreposição dos casos mais fáceis de ver, enquanto a figura fica mais carregada do que uma caixa isolada:
ggplot(ds, aes(species, body_mass_g, fill = sex)) +
  geom_boxplot(outlier.shape = NA, alpha = 0.55) +
  geom_point(aes(shape = sex),
             position = position_jitterdodge(jitter.width = 0.10, dodge.width = 0.75),
             alpha = 0.35) +
  theme_classic() +
  labs(x = "Species", y = "Body mass (g)",
       fill = "Sex", shape = "Sex")
A caixa resume quartis; os pontos devolvem os casos individuais. O gráfico responde melhor à pergunta «há sobreposição e valores extremos?» e responde pior a uma leitura rápida de apenas quatro medianas. Continua a ser descritivo dos pinguins observados.
- Avançado. Use uma função ou técnica deste tutorial para fazer um gráfico dos dados de um dos seus estudos. Identifique a unidade observacional, justifique as codificações e escreva o que o gráfico não permite concluir.
Solução 11: Adaptar a Dados Próprios
Uma solução avançada, que pode servir de modelo para dados próprios, usa uma relação entre duas medidas e identifica a unidade na própria explicação:
ggplot(ds, aes(flipper_length_mm, body_mass_g, colour = species,
               shape = species)) +
  geom_point(alpha = 0.65) +
  theme_classic() +
  labs(x = "Flipper length (mm)", y = "Body mass (g)",
       colour = "Species", shape = "Species")
Aqui uma linha representa um pinguim, flipper_length_mm ocupa o eixo x, a massa ocupa o eixo y e a espécie é codificada por cor e forma. Usar duas codificações redundantes ajuda leitores que não distinguem cores, embora possa tornar a legenda mais pesada. O gráfico não permite concluir causalidade, nem que os grupos representem populações com tamanhos conhecidos, nem que cada linha seja independente se o mesmo pinguim tiver sido medido mais do que uma vez. Num estudo próprio, substituiria ds pela tabela original, confirmaria a coluna que identifica a unidade e registaria a proveniência dos dados antes de publicar.
11 Conclusão
Não existe um gráfico correcto para um tipo de variável isolado. Existe uma escolha que torna uma pergunta e as suas limitações legíveis. Comece pelos dados individuais quando puder, acrescente resumos, modelos ou anotações só quando esclarecem, e deixe sempre claro o que o delineamento não permite concluir.