install.packages("palmerpenguins")Descritivas no R
Programação
Estatística
Descritivas
Como resumir dados no R e perceber o que cada resumo mostra e esconde.
0 Estatística Descritiva: Resumos Que Não Apagam os Dados
A estatística descritiva resume os dados que observámos. Por exemplo, a média da massa corporal de um grupo de pinguins dá-nos um centro numérico, mas não mostra se há dois grupos de tamanhos diferentes, quantos valores faltam ou se uma observação extrema a desloca. Cada resumo perde parte da informação que estava nas linhas originais.
Neste tutorial começamos por cinco famílias de resumos: frequência, tendência central, localização, dispersão e forma. Em cada uma perguntamos que aspecto dos dados o resumo representa. Os gráficos completam esse trabalho, mostrando a distribuição, os agrupamentos e as relações entre observações. A página teórica de Estatística Descritiva desenvolve os conceitos. O tutorial Gráficos no R mostra como explorar os dados visualmente.
Vamos usar penguins, do pacote palmerpenguins. Instale o pacote uma vez, fora do script, se necessário, e depois execute:
library(palmerpenguins)
ds <- penguins
Há valores em falta nesta base e isso faz parte do exemplo. Uma estatística sem a sua regra para dados em falta é uma instrução incompleta.
Quem procura uma função pode começar pelo bloco mais próximo da sua pergunta. Quem quer primeiro reconhecer os resumos encontra as categorias abaixo. Em ambos os casos, vale a pena voltar aos dados e, quando a forma importar, aos gráficos. Um resumo levanta perguntas que podemos explorar nos dados.
1 Famílias de Resumos
Frequências: Contar Categorias
Frequência absoluta é o número de casos. Frequência relativa é a proporção (ou percentagem). Frequência acumulada acrescenta contagens pela ordem dos níveis, por isso faz sentido sobretudo para variáveis ordinais. Para uma variável nominal como species, conte sem inventar uma ordem.
# Count the absolute frequency for each species.
table(ds$species)
   Adelie Chinstrap    Gentoo
      152        68       124
# Calculate the relative frequency for each species.
prop.table(table(ds$species))
   Adelie Chinstrap    Gentoo
0.4418605 0.1976744 0.3604651
# Cross-tabulate two categorical variables.
table(ds$species, ds$sex, useNA = "ifany")
            female male <NA>
  Adelie        73   73    6
  Chinstrap     34   34    0
Gentoo 58 61 5 low medium high
2 3 6 Estas contagens dão-nos o tamanho e a composição da amostra. Para comparar a massa corporal entre espécies precisamos de resumir outra variável. Para saber se a amostra representa uma população mais ampla precisamos de informação sobre como foi obtida.
Tendência Central: Onde Está o Centro?
A moda é o valor mais frequente e é especialmente natural para variáveis categóricas. Em português, a palavra também significa roupa que está em voga. Na estatística, porém, basta contar ocorrências. Se cinco pessoas escolherem «calças largas, calças justas, calças justas, saia, calças justas», a moda é «calças justas». A mediana é o valor central depois de ordenar os dados (o segundo quartil, Q2). A média é a soma dividida pelo número de observações e é sensível a valores extremos.
Para a massa corporal, calculamos mediana e média. Para mostrar que uma variável pode ter mais de uma moda, usamos um exemplo categórico inventado com um empate.
[1] "agree" "disagree"# Median and mean body mass, explicitly ignoring NA.
median(ds$body_mass_g, na.rm = TRUE)[1] 4050mean(ds$body_mass_g, na.rm = TRUE)[1] 4201.754Neste exemplo, agree e disagree são ambas modas. Para categorias, esta contagem é exactamente a operação que queremos.
Com uma variável contínua, «moda» também pode significar a localização do pico da distribuição. Contar valores exactamente iguais pode dar uma resposta muito diferente, porque a precisão da medição e o arredondamento determinam os empates. Para estimar o pico, podemos estimar uma densidade e procurar o ponto onde ela é máxima; a suavização escolhida também influencia os picos encontrados.
Vale ainda a pena verificar o que o software chama mode. Em R base, mode() descreve o modo de armazenamento de um objecto; não calcula uma moda estatística. O detalhe sobre modas e picos na página teórica desenvolve esta distinção.
Nota
Pode ter aprendido “média para quantitativas, mediana para ordinais e moda para nominais”. Esta classificação ajuda numa primeira escolha. Para decidir que resumo usar, precisamos também de considerar a pergunta, a escala, os valores extremos e o delineamento. Neste site, explicamos a escolha com base nesses critérios.
Localização: Quartis e Quantis
Os quartis dividem os valores ordenados em quatro partes: Q1, Q2 e Q3. Outros quantis usam outros pontos de corte. A amplitude interquartil (AIQ, Q3 - Q1) resume a largura dos 50% centrais e é menos afectada por extremos do que a amplitude total.
Dispersão: Quão Diferentes São os Valores?
A amplitude total é max - min. A variância calcula desvios quadrados à média e o desvio-padrão (sd()) volta à unidade original. O desvio-padrão é útil quando a média e a escala quadrática fazem sentido. A AIQ pode ser uma escolha mais resistente. Nenhum deles descreve a forma completa da distribuição.
Forma: Assimetria, Caudas e Multimodalidade
Em distribuições unimodais com uma cauda bem definida, é frequente a média deslocar-se mais na direcção da cauda, a mediana menos e o pico da distribuição menos ainda. É daí que vem a conhecida regra moda < mediana < média para assimetria positiva, com a ordem invertida para assimetria negativa. Quando a distribuição tem vários picos, essa regra deixa de ser um bom guia: pode haver mais de uma moda e a posição dos picos já não descreve um único «centro».
Assimetria e curtose resumem aspectos da forma de uma distribuição. A assimetria descreve o desequilíbrio entre os dois lados da distribuição; a curtose clássica dá grande peso às observações afastadas do centro e, por isso, é especialmente informativa sobre as caudas. A associação tradicional entre curtose e simples “achatamento” é demasiado estreita. Para reconhecer assimetria, caudas, lacunas ou vários picos, comece por olhar para o gráfico e use estes coeficientes quando quiser quantificar uma característica específica. O tutorial Gráficos no R mostra como fazer isso.
Um Resumo Numérico e o Que Ele Omite
summary() é uma forma rápida de obter mínimo, quartis, mediana, média e máximo (e informação sobre NA, conforme o tipo). É excelente para uma primeira inspecção, mas não permite concluir que duas distribuições têm o mesmo formato. Por exemplo, duas listas podem ter os mesmos cinco números e, ainda assim, uma concentrar os valores no centro e outra juntar dois grupos.
summary(ds$body_mass_g) Min. 1st Qu. Median Mean 3rd Qu. Max. NAs
2700 3550 4050 4202 4750 6300 2 Um gráfico de pontos, histograma, densidade ou boxplot pode revelar aglomeramentos, assimetria e observações isoladas que uma tabela esconde. Esse é o motivo para combinar pelo menos um centro com uma medida de dispersão e, quando a forma importa, também uma visualização.
2 Resumir por Grupos e Aproximar o Modelo
Uma média global pode ocultar diferenças entre grupos ou uma composição imprevista da amostra. aggregate() produz resumos por grupo. Estes resumos descrevem os valores observados, sem testar hipóteses nem ajustar a incerteza de um modelo.
aggregate(body_mass_g ~ species, data = ds,
FUN = mean, na.rm = TRUE)| species | body_mass_g |
|---|---|
| Adelie | 3700.662 |
| Chinstrap | 3733.088 |
| Gentoo | 5076.016 |
aggregate(body_mass_g ~ species, data = ds,
FUN = sd, na.rm = TRUE)| species | body_mass_g |
|---|---|
| Adelie | 458.5661 |
| Chinstrap | 384.3351 |
| Gentoo | 504.1162 |
Para várias descritivas, podemos usar dplyr. Instale-o uma vez se for necessário, mas não misture estilos sem motivo dentro de um mesmo script.
install.packages("dplyr")| species | N | N_mass | mean | median | SD | IQR |
|---|---|---|---|---|---|---|
| Adelie | 152 | 151 | 3700.662 | 3700 | 458.5661 | 650.0 |
| Chinstrap | 68 | 68 | 3733.088 | 3700 | 384.3351 | 462.5 |
| Gentoo | 124 | 123 | 5076.016 | 5000 | 504.1162 | 800.0 |
N conta todos os casos do grupo e N_mass conta os que têm massa registada. Os dois números ajudam a perceber quantos casos formam cada resumo. Se resumirmos por species e sex, obtemos combinações de grupos. Repare se algum grupo é pequeno ou está ausente.
| species | sex | N_mass | mean | SD |
|---|---|---|---|---|
| Adelie | female | 73 | 3368.836 | 269.3801 |
| Adelie | male | 73 | 4043.493 | 346.8116 |
| Adelie | NA | 5 | 3540.000 | 477.1661 |
| Chinstrap | female | 34 | 3527.206 | 285.3339 |
| Chinstrap | male | 34 | 3938.971 | 362.1376 |
| Gentoo | female | 58 | 4679.741 | 281.5783 |
| Gentoo | male | 61 | 5484.836 | 313.1586 |
| Gentoo | NA | 4 | 4587.500 | 338.1937 |
Da Tabela para o Modelo
As descritivas ajudam a decidir o que investigar, mas não substituem o modelo. Um modelo linear pode estimar diferenças de massa entre espécies, ajustar covariáveis e quantificar incerteza:
Call:
lm(formula = body_mass_g ~ species, data = ds)

Residuals:
     Min       1Q   Median       3Q      Max
-1126.02  -333.09   -33.09   316.91  1223.98

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)       3700.66      37.62   98.37   <2e-16 ***
speciesChinstrap    32.43      67.51    0.48    0.631
speciesGentoo     1375.35      56.15   24.50   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 462.3 on 339 degrees of freedom
  (2 observations deleted due to missingness)
Multiple R-squared:  0.6697,    Adjusted R-squared:  0.6677
F-statistic: 343.6 on 2 and 339 DF,  p-value: < 2.2e-16
A tabela de médias resume diferenças observadas. O modelo explicita a comparação e depende do delineamento, da independência, da escala da resposta e de outras verificações. Consulte modelos lineares e pressupostos antes de interpretar coeficientes.
3 Exercícios
- Calcule uma tabela de frequência para
islande explique por que não há frequência acumulada natural para essa variável nominal.
Solução 1
island_frequencies <- table(ds$island, useNA = "ifany")
island_frequencies
   Biscoe     Dream Torgersen
      168       124        52
island é nominal: os nomes das ilhas não têm uma ordem numérica ou natural que permita interpretar cumsum() como frequência acumulada. Poderíamos calcular uma soma cumulativa depois de impor uma ordem administrativa, mas essa seria uma escolha convencional, não uma propriedade da variável.
- Compare média, mediana, AIQ e desvio-padrão de
bill_length_mmpor espécie. Que aspecto poderia continuar escondido? Faça um gráfico para o investigar.
Solução 2
| species | mean | median | IQR | SD |
|---|---|---|---|---|
| Adelie | 38.79139 | 38.80 | 4.000 | 2.663405 |
| Chinstrap | 48.83382 | 49.55 | 4.725 | 3.339256 |
| Gentoo | 47.50488 | 47.30 | 4.250 | 3.081857 |
ggplot2::ggplot(ds, ggplot2::aes(species, bill_length_mm)) +
  ggplot2::geom_jitter(width = 0.12, alpha = 0.35) +
  ggplot2::geom_boxplot(width = 0.45, outlier.shape = NA, alpha = 0.25) +
  ggplot2::theme_classic() +
  ggplot2::labs(x = "Species", y = "Bill length (mm)")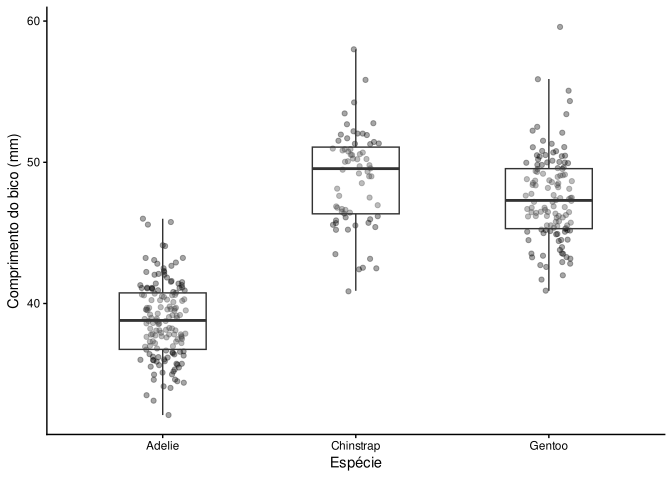
- Construa um resumo por
speciesesexque incluaNeN_mass. Explique por que são importantes antes de comparar médias.
Solução 3
| species | sex | N | N_mass | mean | SD |
|---|---|---|---|---|---|
| Adelie | female | 73 | 73 | 3368.836 | 269.3801 |
| Adelie | male | 73 | 73 | 4043.493 | 346.8116 |
| Adelie | NA | 6 | 5 | 3540.000 | 477.1661 |
| Chinstrap | female | 34 | 34 | 3527.206 | 285.3339 |
| Chinstrap | male | 34 | 34 | 3938.971 | 362.1376 |
| Gentoo | female | 58 | 58 | 4679.741 | 281.5783 |
| Gentoo | male | 61 | 61 | 5484.836 | 313.1586 |
| Gentoo | NA | 5 | 4 | 4587.500 | 338.1937 |
N conta as linhas no grupo e N_mass conta as massas efectivamente usadas no resumo. Se forem diferentes, a média não se baseia em todos os casos. Os dois números também alertam para grupos pequenos ou para padrões de valores em falta antes de compararmos médias.
- Ajuste um modelo para uma pergunta que o seu resumo sugeriu. Escreva uma frase que distinga claramente o que a tabela mostra do que o modelo estima.
Solução 4
Uma pergunta possível, sugerida pelas diferenças descritivas entre espécies, é se a massa corporal difere entre espécies depois de ter em conta o comprimento do bico:
Call:
lm(formula = body_mass_g ~ species + bill_length_mm, data = ds)

Residuals:
    Min      1Q  Median      3Q     Max
-871.21 -246.17    5.29  213.13 1084.73

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)       153.740    268.901   0.572    0.568
speciesChinstrap -885.812     88.250 -10.038  < 2e-16 ***
speciesGentoo     578.629     75.362   7.678 1.76e-13 ***
bill_length_mm     91.436      6.887  13.276  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 375.3 on 338 degrees of freedom
  (2 observations deleted due to missingness)
Multiple R-squared:  0.7829,    Adjusted R-squared:  0.781
F-statistic: 406.3 on 3 and 338 DF, p-value: < 2.2e-16body_mass_g em cada espécie. O modelo estima diferenças condicionais entre espécies, segundo a forma funcional e as hipóteses desse modelo. Outra pergunta sugerida pelos dados poderia justificar um modelo diferente. A escolha deve seguir a pergunta, mesmo que outro modelo dê um resultado mais conveniente.
-
Tarefa mais exigente, mas delimitada. Leia
data/manatees.csv, descrito na página dos datasets. ParaManateeDeathsePowerboats, faça uma tabela comN, valores em falta, mínimo, mediana, média e desvio-padrão. Faça também um gráfico de dispersão porYeare escreva duas frases: uma sobre o padrão descritivo que observa e outra sobre o que estes resumos não permitem concluir acerca de causalidade. Não ajuste um modelo.
Solução 5
manatees <- read.csv("../data/manatees.csv")

manatees_summary <- do.call(rbind, lapply(
  c("ManateeDeaths", "Powerboats"),
  function(name) {
    x <- manatees[[name]]
    data.frame(
      variable = name,
      N = length(x),
      missing = sum(is.na(x)),
      minimum = min(x, na.rm = TRUE),
      median = median(x, na.rm = TRUE),
      mean = mean(x, na.rm = TRUE),
      SD = sd(x, na.rm = TRUE)
    )
  }
))
manatees_summary| variable | N | missing | minimum | median | mean | SD |
|---|---|---|---|---|---|---|
| ManateeDeaths | 35 | 0 | 13 | 53 | 58.05714 | 29.34274 |
| Powerboats | 35 | 0 | 447 | 735 | 755.95714 | 179.33613 |
ggplot2::ggplot(manatees, ggplot2::aes(x = Year, y = ManateeDeaths)) +
  ggplot2::geom_point() +
  ggplot2::theme_classic() +
  ggplot2::labs(x = "Year", y = "Manatee deaths")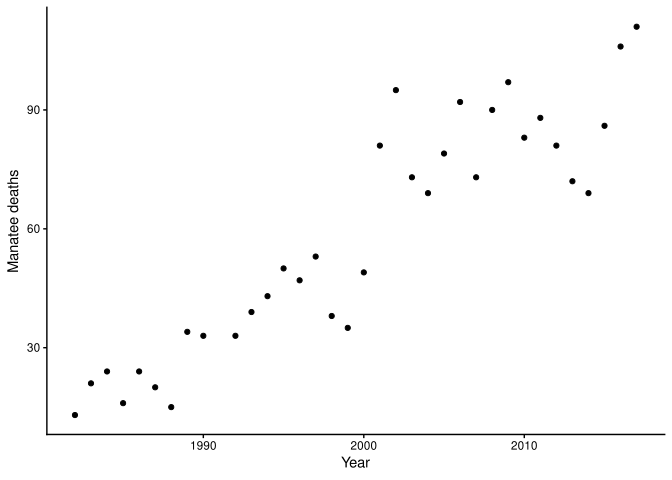
ggplot2::ggplot(manatees, ggplot2::aes(x = Year, y = Powerboats)) +
  ggplot2::geom_point() +
  ggplot2::theme_classic() +
  ggplot2::labs(x = "Year", y = "Powerboats")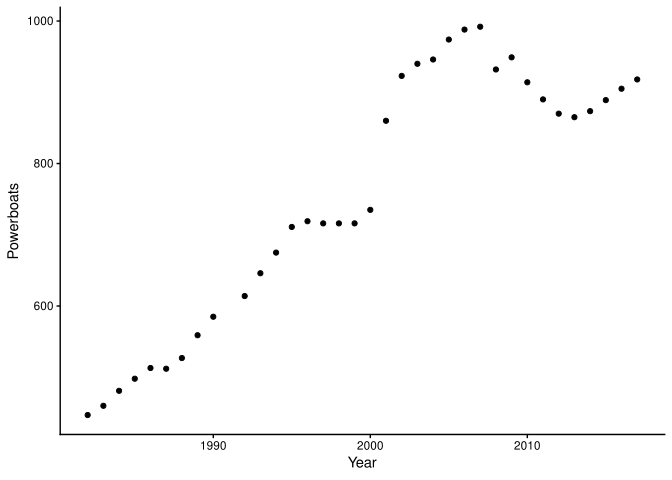
Powerboats causou as mortes. Para sustentar essa conclusão, seria necessário justificar um delineamento e uma estratégia de análise adequados. Uma tabela ou um gráfico alternativo pode ser preferível, desde que preserve as mesmas verificações e limites de interpretação.