Filosofia da Estatística
Fundamentos
Filosofia
Inferência
Probabilidade, testes e interpretações da evidência estatística.
0 Probabilidades Pouco Intuitivas
Depois de várias caras seguidas, a coroa fica «a dever-nos» uma saída? Se os lançamentos forem independentes e a moeda justa, a probabilidade de coroa continua a ser .5. A sequência anterior não obriga o acaso a compensar-nos no lançamento seguinte.
As probabilidades nem sempre acompanham a primeira intuição. Se uma pergunta destas nos faz hesitar, isso faz parte da aprendizagem: precisamos de identificar o acontecimento, as condições e o grupo de referência antes de fazer a conta. Vamos praticar esse cuidado com uma moeda e, depois, com um teste médico.
As pessoas mostram padrões previsíveis de erro em alguns problemas de probabilidade (Tversky & Kahneman, 1974), mas estes efeitos dependem muito da tarefa e da forma como a informação é apresentada (Gigerenzer & Hoffrage, 1995; McDowell & Jacobs, 2017; Szollosi & Newell, 2020).
NotaPara Explorar: Intuições Enganadoras
Trocar a condicional. As pessoas confundem por vezes \(P(A\mid B)\) com \(P(B\mid A)\); a prosecutor’s fallacy é um exemplo aplicado deste erro (Thompson & Schumann, 1987). A mesma confusão aparece quando um valor-p é lido como \(P(H_0\mid D)\).
Subvalorizar taxas de base. Este padrão aparece repetidamente (Tversky & Kahneman, 1974), mas o formato importa: frequências naturais melhoram substancialmente o raciocínio bayesiano (Gigerenzer & Hoffrage, 1995; McDowell & Jacobs, 2017), e há bastante heterogeneidade entre pessoas e problemas (Stengård et al., 2022).
Julgar uma conjunção mais provável do que uma das suas partes. Isto viola \(P(A\cap B)\leq P(A)\) e foi observado no conhecido problema de Linda (Tversky & Kahneman, 1983), embora a magnitude e a generalidade do efeito dependam da formulação e da tarefa (Mellers et al., 2001; Chandrashekar et al., 2021).
Esperar demasiado de amostras pequenas. As pessoas podem esperar que amostras pequenas reproduzam demasiado fielmente a população (Tversky & Kahneman, 1971), mas esta tendência não é universal (Bar-Hillel, 1979).
Esperar que o acaso se «compense». Depois de uma sequência, muitas pessoas tendem a prever o resultado oposto (Farmer et al., 2017), mas isso não implica necessariamente que atribuam probabilidades erradas ao próximo resultado (Xiang et al., 2025).
Tratar duas possibilidades como 50/50. «Ou acontece ou não acontece» não implica probabilidades iguais. Esta dificuldade aparece em estudos de concepções de probabilidade (Morsanyi et al., 2009).
Confundir independência com exclusão mútua. É uma dificuldade conceptual frequente entre estudantes (D’Amelio, 2009).
Confundir facilidade de recordação com frequência. A disponibilidade de exemplos pode influenciar julgamentos (Tversky & Kahneman, 1973), mas a dimensão do efeito depende do paradigma e de vários moderadores (Weingarten & Hutchinson, 2018).
Estranhar a lei dos grandes números. As proporções podem convergir mesmo quando a diferença absoluta entre resultados cresce (Falk, 2015). Aqui trata-se sobretudo de uma consequência matemática contra-intuitiva, não de um «viés» psicológico.
Em cada problema, perguntem qual é exactamente a probabilidade em causa, em que informação estamos a condicionar e até que ponto a formulação do problema altera o raciocínio.
1 Peixes Maiores?
«Os peixes de água salgada são maiores do que os de água doce.» Suponhamos que alguém faz esta afirmação hipotética. Maiores em que sentido? Todos os indivíduos de um grupo são maiores do que todos os do outro? Ou estamos a falar de uma diferença em média, para espécies, idades e condições que ainda precisamos de especificar?
Encontrar um peixe de água salgada menor do que um de água doce contrariaria a primeira afirmação sem contrariar a segunda. Se a hipótese admite variação entre indivíduos, um caso isolado não decide a questão. Precisamos de definir a comparação, medir os casos e avaliar quanto os resultados poderiam variar. É aí que precisamos de inferência estatística.
A Estatística Descritiva resume os casos observados. Inferir exige ir além deles: aprender sobre uma população, um processo ou uma discrepância que não observámos por inteiro. O delineamento, a medição e os pressupostos justificam essa passagem; a conta não os substitui (Greenland et al., 2016).
A filosofia da ciência precisa desta lógica para pôr à prova hipóteses probabilísticas. E a estatística precisa de filosofia para explicar por que uma probabilidade calculada sustenta uma conclusão, que conclusão sustenta e que erros ainda deixa passar. O que significa uma probabilidade? Como pode um número representar uma crença? E como deveria essa crença mudar perante novos dados? Estas também são perguntas da filosofia da estatística, às quais as diferentes tradições dão respostas distintas. Para começar sem carregar já todas as dificuldades dos peixes, lancemos uma moeda.
2 Uma Moeda, Dez Lançamentos
Lançamos uma moeda dez vezes. Sai cara seis vezes e coroa quatro.
Se a moeda for equilibrada, esperamos metade dos lançamentos de cada lado, em média, ao longo de muitas repetições. Em dez lançamentos, isso dá cinco caras. Mas ninguém prometeu que cada série de dez terminaria exactamente em cinco caras e cinco coroas.
Seis caras são motivo para desconfiar da moeda?
O Que Aconteceria Com Uma Moeda Justa?
Imaginem que suspeitamos, antes dos lançamentos, de que a moeda favorece caras. Se for justa, cada lançamento independente tem probabilidade .5 de dar cara. Podemos calcular o que aconteceria se repetíssemos muitas vezes a série de dez lançamentos sob essas condições.
Qual é a probabilidade de obter exactamente seis caras? Cerca de 20.5%. Mas seria essa a pergunta certa para avaliar um excesso de caras? Se tivessem saído sete, oito, nove ou dez, desconfiaríamos ainda mais. Precisamos de contar também esses resultados.
| Caras em dez lançamentos | Probabilidade de exactamente esse resultado | Probabilidade de obter esse resultado ou mais caras |
|---|---|---|
| 6 | 20.5% | 37.7% |
| 7 | 11.7% | 17.2% |
| 8 | 4.4% | 5.5% |
| 9 | 1.0% | 1.1% |
| 10 | 0.1% | 0.1% |
A última coluna soma cada resultado e todos os que têm mais caras: é a probabilidade acumulada na cauda superior. Assim, obter seis ou mais caras numa moeda justa tem probabilidade .377 (37.7%). Aconteceria em mais de um terço das séries. Oito ou mais já ocorreriam em cerca de 5.5%; nove ou mais, em 1.1%. A surpresa aumenta.
E se a pergunta fosse «a moeda é viciada?», em qualquer direcção? Também precisamos de contar resultados a favor de coroas. Mas como escolhemos os resultados da outra cauda?
No teste bilateral exacto de binom.test() do R, contamos as contagens que, sob o modelo nulo, têm probabilidade menor ou igual à da contagem observada. Com seis caras em dez e probabilidade .5, isso inclui zero a quatro e seis a dez caras. A soma é 75.4%. Aqui, a simetria permite duplicar a cauda superior. Não é uma regra universal para testes bilaterais: a ordenação dos resultados faz parte do teste (R, binom.test()).
NotaUma Binomial Assimétrica
Num exemplo construído com dez tentativas e probabilidade de referência .3, observamos seis sucessos. A mesma regra inclui zero e seis a dez sucessos: são as contagens tão ou menos prováveis que seis. O resultado bilateral é cerca de .0756; duplicar a cauda superior daria .0947. A cauda esquerda conta, mas não tem a mesma probabilidade.
binom.test(6, 10, p = .3, alternative = "two.sided")$p.value
# 0.07559651
Podemos verificar a selecção com dbinom(0:10, 10, .3). O R admite uma pequena tolerância numérica ao comparar probabilidades iguais.
Convém decidir qual pergunta fazemos antes de olhar para o resultado.
Ainda não precisamos de decorar nomes nem de escolher um limiar universal. Já temos uma ideia útil: podemos comparar uma observação com os resultados que um processo bem especificado conseguiria produzir.
Da Surpresa à Evidência, à Decisão e ao Erro
Três perguntas diferentes nasceram desta moeda. Vão ajudar-nos a compreender três perspectivas essenciais para o resto do site.
Primeira pergunta: quanto é que os dados põem em causa o modelo? O nosso resultado foi comparado com aquilo que uma moeda justa produziria. Nove caras dão-nos mais razões para questionar esse modelo do que seis. Ronald Fisher tornou influente esta maneira de usar resultados progressivamente menos compatíveis com um modelo de referência. O número que calculámos, incluindo os resultados tão ou mais extremos na direcção escolhida, é aquilo a que chamamos um valor-p.
Segunda pergunta: quando decidimos que há motivo suficiente para agir ou rejeitar o modelo? Podemos estabelecer uma regra antes da experiência, por exemplo rejeitar o modelo de moeda justa quando a probabilidade de cauda superior for, no máximo, .05. Com apenas dez lançamentos, essa regra rejeitaria a partir de nove caras: oito ainda correspondem a cerca de .055. Como os resultados possíveis são discretos, a probabilidade de rejeitar injustamente uma moeda justa com esta regra é cerca de 1.1%, não exactamente 5%.
Jerzy Neyman e Egon Pearson tornaram central a comparação entre regras: quantas vezes rejeitariam uma hipótese que fosse verdadeira e quantas vezes conseguiriam detectar alternativas relevantes? Isso ajuda a escolher procedimentos e a justificar decisões. Há também um objectivo de aprendizagem científica nessa preocupação com erros; reduzi-la a uma mera escolha de comportamentos seria historicamente pobre.
Terceira pergunta: o nosso teste tinha boas condições para descobrir que estávamos enganados? E se a moeda favorecesse ligeiramente caras, mas dez lançamentos fossem poucos para revelar o desvio? Obter seis caras não demonstraria que é justa. E até dez caras exigiriam verificar que a moeda foi lançada de forma adequada e que o modelo de referência fazia sentido.
Deborah Mayo coloca esta questão no centro da sua abordagem de error statistics: se uma afirmação estivesse errada de uma maneira importante, o teste teria uma boa oportunidade de o mostrar? Isso liga as propriedades dos testes àquilo que podemos aprender com um resultado concreto (Mayo & Spanos, 2006; Mayo, 2018).
Já temos, assim, um primeiro percurso completo: um modelo, observações, uma medida de discrepância, uma possível regra de decisão e a pergunta sobre o que o teste seria capaz de revelar. As três perguntas merecem respostas próprias. Voltaremos a cada uma com mais precisão, em vez de pedir ao leitor que as aprenda todas de uma vez.
Pausa de Leitura
3 Da Moeda aos Modelos
Mudar a Probabilidade Muda a Distribuição
A moeda tinha duas faces e, no modelo de referência, cada uma tinha probabilidade .5. Não há nada de especial no número .5 para a lógica que usámos. O que importa é saber qual é o processo aleatório que estamos a tomar como referência.
Num dado justo, contar «sair seis» dá uma probabilidade de sucesso de 1/6, em vez de .5. Continuamos a contar sucessos em tentativas independentes, mas a distribuição de referência muda. Mudar o número de tentativas também muda essa distribuição: a proporção observada, sozinha, não basta para avaliar a discrepância.
Esta família de modelos chama-se distribuição binomial. Os Fundamentos da Inferência mostram como a construímos e como calculamos as probabilidades na tarefa auditiva e no dado.
Estas contas não exigem que saibamos construir um modelo completo para uma moeda viciada ou um dado adulterado. Construímos primeiro a distribuição sob o modelo que queremos pôr à prova. Isso torna o teste possível, mas não identifica automaticamente a explicação de qualquer discrepância que encontremos.
O Que Pergunta um Valor-p?
Já calculámos um valor-p no início desta página: .377 para seis ou mais caras quando o modelo é uma moeda justa e a pergunta é um excesso de caras.
Damos um nome ao modelo que estamos a pôr à prova: hipótese nula, \(H_0\). Escolhemos também uma maneira de medir a discrepância e o que contaria como resultado «tão ou mais extremo». Então:
\[ p=P(\text{resultado tão ou mais extremo do que o observado} \mid H_0,\text{ modelo e procedimento}). \]
Para a moeda com a pergunta unilateral, tratámos como extremos os resultados com pelo menos tantas caras como as observadas. Se a pergunta fosse bilateral, também contaríamos resultados extremos na outra direcção. O procedimento faz parte da definição; não podemos escolher a cauda que dá o menor número depois de olhar para os dados.
Esta probabilidade é calculada se o modelo de referência for válido. Não é a probabilidade de \(H_0\) ser verdadeira depois de vermos os dados, nem identifica por si só a razão pela qual um resultado ocorreu (Wasserstein & Lazar, 2016).
O cálculo exacto de probabilidades binomiais, e mais tarde de áreas sob uma distribuição t, está desenvolvido nos Fundamentos da Inferência. Aqui vamos examinar por que podemos usar a mesma matemática para responder a perguntas filosóficas e científicas diferentes.
4 Probabilidade e Inferência
O Que Significa Uma Probabilidade?
Na moeda, .5 descreve o processo de lançamento que tomámos como referência. Podemos lê-lo em termos de frequências em repetições: a longo prazo, sob as condições do modelo, cerca de metade dos lançamentos daria cara. Também podemos usar probabilidades para representar incerteza acerca de uma hipótese. As contas obedecem às mesmas regras, mas o significado atribuído aos números muda.
A axiomatização moderna, associada a Kolmogorov, estabelece regras matemáticas para as probabilidades. Não decide, por si só, o que elas significam. Entre as interpretações mais importantes encontramos (Hájek, §3):
- a clássica, associada a casos favoráveis sobre casos possíveis quando as possibilidades são tratadas como equiprováveis;
- interpretações lógicas ou evidenciais, que procuram representar relações de suporte entre evidência e proposições;
- interpretações frequentistas, que ligam probabilidade a frequências em repetições relevantes;
- interpretações de propensão, que tratam a probabilidade como uma tendência ou disposição física de um processo;
- interpretações subjectivas ou personalistas, centrais em parte da tradição bayesiana, que representam graus de crença ou confiança coerentes.
As fronteiras não são perfeitas, e «Bayesianismo» também não é sinónimo de uma única interpretação subjectivista. A Wikipedia tem um mapa introdutório útil destas interpretações, e a Stanford Encyclopedia of Philosophy desenvolve as diferenças com muito mais profundidade.
Na leitura clássica, por exemplo, contamos três faces pares entre seis faces equiprováveis de um dado justo. A equiprobabilidade precisa de justificação: haver duas possibilidades não as torna 50/50. Uma leitura de propensão atribui a probabilidade ao processo físico; uma leitura subjectiva representa a incerteza de um agente. Não são apenas nomes diferentes para a mesma afirmação.
NotaPara Explorar: Interpretações de Probabilidade
O mapa da Wikipedia permite comparar as interpretações lado a lado. A SEP, ligada acima, discute os respectivos argumentos e dificuldades.
Se o navegador impedir a incorporação, abra directamente Probability interpretations — Wikipedia.
Esta diferença importa para a inferência. Podemos calcular probabilidades de resultados supondo uma hipótese, ou representar probabilisticamente a incerteza sobre hipóteses. Não são a mesma pergunta. Antes de comparar as escolas, precisamos de guardar a direcção da condicional.
A Direcção da Condicional
NotaUm Exemplo Para Levar Connosco
Imaginem 1000 pessoas. Dez têm uma doença. Um teste identifica 9 dessas 10, mas também dá positivo em 50 pessoas sem a doença. Entre as 59 pessoas com teste positivo, apenas 9 têm a doença.
A pergunta «qual é a probabilidade de um teste positivo se a pessoa estiver doente?» não é a mesma que «qual é a probabilidade de doença se o teste for positivo?». Qual é o grupo em que estamos a condicionar?
No primeiro sentido, contamos 9 entre 10 pessoas doentes; no segundo, 9 entre 59 pessoas com teste positivo. A direcção da pergunta muda o grupo de referência. É esta distinção que precisamos de guardar quando interpretamos um valor-p: uma probabilidade calculada sob uma hipótese não se transforma, por inversão, numa probabilidade dessa hipótese depois dos dados.
Vocabulário Mínimo
DicaTermos Que Vamos Usar
- População: conjunto mais amplo sobre o qual queremos aprender.
- Amostra: casos efectivamente observados.
- Parâmetro: quantidade que descreve a população ou um modelo.
- Estimativa: valor calculado a partir da amostra para aprender sobre um parâmetro.
- Erro-padrão: medida da variabilidade esperada de uma estimativa entre amostras repetidas sob um modelo.
- Hipótese nula (\(H_0\)): modelo de referência usado num teste.
- Hipótese alternativa (\(H_1\)): hipótese ou família de alternativas que contrasta com \(H_0\); o seu papel formal é especialmente importante em Neyman–Pearson.
- Valor-p: probabilidade, calculada sob \(H_0\) e o procedimento definido, de obter uma estatística pelo menos tão extrema como a observada.
- \(\alpha\): taxa de erro de Tipo I especificada para uma regra de decisão.
- \(\beta\): probabilidade de não rejeitar \(H_0\) quando uma alternativa específica é verdadeira.
- Poder (\(1-\beta\)): probabilidade de rejeitar \(H_0\) quando essa alternativa é verdadeira.
- Sensibilidade: capacidade do procedimento para revelar discrepâncias de determinada magnitude.
- Prior: distribuição usada para representar informação, compromisso ou incerteza antes dos dados numa análise bayesiana.
- Verosimilhança (likelihood): função que compara quão bem diferentes valores de parâmetros tornam os dados observados compatíveis com o modelo.
- Posterior: distribuição resultante da combinação do prior com o modelo para os dados.
- Factor de Bayes (Bayes factor): razão entre probabilidades marginais dos dados sob dois modelos.
5 Tradições da Inferência
As três perguntas da moeda são o nosso fio condutor. Fisher ajuda-nos a avaliar a discrepância observada sob um modelo. Neyman–Pearson compara regras através dos erros que cometem sob o nulo e alternativas. A abordagem de verosimilhança compara o apoio dos dados a hipóteses. Bayes permite representar a incerteza anterior e actualizá-la com novos dados. O argumento fiducial procura obter uma distribuição sobre parâmetros sem partir de um prior. Mayo pergunta que afirmações passaram um teste capaz de revelar erros relevantes.
Estas tradições não formam etapas que se substituíram. Há sobreposições e divergências, e cada uma inclui desenvolvimentos próprios. A comparação não cabe em dois blocos uniformes, «frequentismo» e «Bayesianismo» (Berger, 2003). Vejamos como justificam a passagem dos dados às conclusões.
Fisher: Significância Como Evidência
Voltemos à moeda: quanto mais raro for obter um resultado naquela direcção sob o modelo justo, mais razões teremos para questionar esse modelo, desde que o modo como definimos e executámos o teste seja defensável.
Fisher popularizou testes de significância para investigadores experimentais em Statistical Methods for Research Workers (Fisher, 1925). O valor \(P\) permitia perguntar quão surpreendente seria um resultado pelo menos tão discrepante como o observado se o modelo nulo fosse adequado.
Há aqui uma ideia extremamente económica. Muitas vezes é difícil especificar, com detalhe suficiente para gerar uma distribuição de dados, como seria o mundo se a nossa explicação substantiva estivesse certa. Em contraste, pode ser muito mais fácil especificar uma fonte de variação aleatória e perguntar: como seriam os dados se houvesse apenas esse processo de referência?
É esse o trabalho de \(H_0\). Não precisa de ser uma descrição completa do mundo. Funciona como um modelo deliberadamente restrito contra o qual conseguimos deduzir uma distribuição de resultados possíveis. Fisher sublinhava precisamente a importância de conhecer a distribuição amostral das estatísticas sob uma especificação hipotética e usar essa distribuição para testar se os dados estão em harmonia com ela (Fisher, 1925, cap. I).
NotaA Economia da Ideia de Fisher
Para testar uma explicação não precisamos sempre de conseguir modelar, de imediato, tudo o que esperamos ver se estivermos certos. Podemos começar por uma pergunta mais austera:
Se só estivesse a operar este modelo de referência, quão estranho seria o que observámos?
Isso transforma um problema científico potencialmente muito rico numa pergunta probabilística que conseguimos calcular. O preço é igualmente importante: rejeitar \(H_0\) diz que o modelo de referência não chega para explicar o resultado; não identifica automaticamente qual das muitas alternativas é a explicação correcta.
Fisher também não tratou 5% como um nível universal para toda a investigação. Na obra posterior insistiu que o investigador devia considerar cada caso à luz da evidência e do problema científico, e criticou a transformação dos testes de significância em regras automáticas de aceitação ou rejeição (Fisher, 1955; Kennedy-Shaffer, 2019).
Neyman–Pearson: Alternativas e Erros
Jerzy Neyman e Egon Sharpe Pearson desenvolveram em colaboração uma teoria diferente de testes estatísticos. Os artigos de 1928 já desenvolvem o papel de alternativas e critérios de teste (Neyman & Pearson, 1928a; 1928b). O artigo clássico de 1933 formaliza o problema de escolher testes eficientes quando \(H_0\) compete com alternativas e torna centrais as probabilidades de erro (Neyman & Pearson, 1933a).
Há uma diferença de ênfase em relação à pergunta inicial de Fisher. Podemos perguntar, antes de lançar a moeda, que regra distinguiria bem uma moeda justa de outras moedas que nos interessasse detectar. Com dez lançamentos e a regra unilateral de .05 do nosso exemplo, rejeitaríamos a moeda justa a partir de nove caras. Essa regra controla a probabilidade de rejeições erradas sob a hipótese nula. A sua capacidade de reconhecer uma moeda que favoreça caras depende de quanto ela as favorece.
A mudança conceptual é importante:
- em Fisher, \(H_0\) funciona sobretudo como modelo de referência contra o qual avaliamos a discrepância observada;
- em Neyman–Pearson, precisamos de alternativas para avaliar que testes distinguem melhor situações relevantes e que inferências o seu desempenho ajuda a justificar;
- \(\alpha\) controla a frequência de rejeitar \(H_0\) quando \(H_0\) é verdadeira: é o erro de Tipo I;
- \(\beta\) é a probabilidade de não rejeitar \(H_0\) quando uma alternativa especificada é verdadeira: é o erro de Tipo II;
- o poder, \(1-\beta\), é a probabilidade de rejeitar \(H_0\) sob essa alternativa. Depende do valor verdadeiro que consideramos.
Verosimilhança: Comparar o Apoio
Voltemos às seis caras em dez lançamentos. Em vez de perguntar por resultados tão ou mais extremos, podemos comparar a probabilidade destes dados sob diferentes valores da probabilidade de cara, que vamos chamar \(\theta\). A função de verosimilhança é \(L(\theta;D)=P(D\mid\theta)\): mantemos os dados \(D\) fixos e variamos \(\theta\). Em modelos contínuos usamos uma densidade, em vez da probabilidade de um resultado exacto.
Para comparar duas hipóteses simples, dividimos as suas verosimilhanças. No nosso exemplo binomial, a razão entre \(\theta=.6\) e \(\theta=.5\) é cerca de 1.22. Os dados observados são um pouco mais prováveis no primeiro modelo. Esta razão usa as seis caras e as quatro coroas observadas; não soma a probabilidade de obter sete, oito, nove ou dez caras.
O verosimilhançismo (likelihoodism) interpreta esta razão como medida do apoio relativo que os dados dão às hipóteses. A chamada lei da verosimilhança diz que os dados apoiam mais a hipótese sob a qual são mais prováveis (Romeijn, §3.3.1). Isso não atribui probabilidades às hipóteses: uma razão de 1.22 não significa uma probabilidade de 1.22, nem diz a probabilidade de cada hipótese ser verdadeira.
O princípio da verosimilhança acrescenta que toda a informação evidencial dos dados sobre os parâmetros está na função de verosimilhança. Aqui surge uma divergência com os testes frequentistas: estes também consideram resultados que o procedimento poderia ter produzido, mas não produziu, para calcular caudas e avaliar erros (Romeijn, §3.2.2).
Usar verosimilhanças não nos torna verosimilhançistas. A estimação por máxima verosimilhança é usada em análises frequentistas, e a verosimilhança também entra na actualização bayesiana. A diferença filosófica está em considerar que ela basta, ou não, para caracterizar o apoio evidencial.
Bayes: Integrar Dados e Conhecimento
Uma motivação bayesiana é tornar explícito o que já sabemos ou pensamos antes de recolher dados. Podemos codificar crenças acerca de uma hipótese e integrar os dados no conhecimento anterior. A incerteza inicial é representada por uma distribuição prior; um modelo diz-nos como os dados dependem das hipóteses ou parâmetros; a combinação produz uma distribuição posterior (Gelman & Shalizi, 2013).
Na moeda, podemos representar inicialmente diferentes valores plausíveis para a probabilidade de cara. Depois dos lançamentos, actualizamos essa distribuição usando a probabilidade dos dados sob cada valor. Não precisamos de reduzir o conhecimento anterior a uma escolha entre «justa» e «viciada».
Para uma hipótese \(H\) e evidência \(E\), o teorema de Bayes escreve-se:
\[ P(H \mid E)=\frac{P(E\mid H)P(H)}{P(E)}. \]
\(P(H)\) representa a probabilidade anterior, \(P(E\mid H)\) a probabilidade da evidência sob a hipótese e \(P(H\mid E)\) a probabilidade posterior. \(P(E)\) normaliza o resultado, considerando as possibilidades do modelo. O teorema é matemática; interpretar estas probabilidades como graus de crença ou incerteza sobre hipóteses é uma escolha filosófica.
Neste site, não adoptamos a interpretação da probabilidade como grau de crença. Vamos concentrar-nos no que os procedimentos permitem aprender sobre o mundo e na sua capacidade de detectar erros. Por isso, o Bayesianismo terá aqui menos desenvolvimento: apresentamos o seu raciocínio para compreender a proposta e compará-la com as outras tradições.
O teste médico mostra a actualização numa situação concreta. Antes do teste, 10 em 1000 pessoas estão doentes; entre as pessoas com resultado positivo, são 9 em 59. A informação do resultado muda a probabilidade de doença, mas não apaga a frequência inicial da doença nem os falsos positivos.
Na moeda, o prior pode dar mais peso a valores próximos de .5 ou distribuir a incerteza por uma gama mais ampla. Multiplicamos esse prior pela verosimilhança das seis caras e quatro coroas e normalizamos: obtemos o posterior. Um intervalo de credibilidade de 95% contém 95% da probabilidade posterior, dadas estas escolhas. É uma afirmação sobre a incerteza do parâmetro no modelo, diferente da cobertura em amostragens repetidas de um intervalo de confiança.
Esta interpretação é condicional ao modelo e ao prior. A análise não termina no cálculo do posterior: precisamos de verificar se o modelo descreve adequadamente os dados (Gelman & Shalizi, 2013, §§2 e 4). Devemos também examinar se as conclusões resistem a outras escolhas razoáveis de prior, como veremos nos aprofundamentos.
A análise permite comunicar directamente essa incerteza posterior e aproveitar informação substantiva anterior. Há também priors construídos por regras formais, em vez de representar as crenças pessoais de um investigador (Berger, 2006). Podemos ainda comparar dois modelos através de um factor de Bayes, uma razão entre as probabilidades dos dados sob esses modelos, integrando a incerteza sobre os seus parâmetros. Mais adiante distinguiremos as escolhas de priors e aprofundaremos essa comparação.
Fiducial: Inferir Sem um Prior?
Fisher procurou outra maneira de passar de uma distribuição amostral para uma distribuição sobre o parâmetro desconhecido, sem especificar um prior. É o objectivo do argumento fiducial. Não é uma leitura alternativa do valor-p, nem uma licença para interpretar qualquer intervalo de confiança como probabilidade posterior (Romeijn, §3.3.3).
Pensemos num exemplo construído: medimos uma grandeza e sabemos que a medição é o valor verdadeiro mais um erro com distribuição conhecida. Antes da observação, o valor verdadeiro está fixo e a medição varia com o erro. Depois de observarmos um valor, o argumento fiducial procura inverter essa relação: subtraímos os erros possíveis ao valor observado e transferimos a sua distribuição para os valores possíveis do parâmetro.
É precisamente essa transferência que exige justificação. A distribuição do erro antes dos dados não se transforma automaticamente numa distribuição de incerteza sobre o parâmetro depois deles. Em certos problemas simples, os intervalos fiduciais coincidem numericamente com intervalos de confiança. A coincidência das contas não torna iguais as justificações.
O argumento é controverso e a sua aplicação geral, sobretudo com vários parâmetros, encontra dificuldades. Existem desenvolvimentos e generalizações, mas não uma regra única que elimine essas questões (Romeijn, §3.3). Para o percurso deste site, basta reconhecer a proposta e a diferença: Bayes começa por uma distribuição sobre parâmetros; o argumento fiducial procura chegar a uma sem esse ponto de partida.
Mayo e o Teste Severo
A moeda ajuda-nos a perceber por que precisamos de mais uma pergunta. Seis caras não mostram que a moeda é justa: um teste com dez lançamentos pode não ter sido sensível a desvios modestos. E uma rejeição da hipótese de moeda justa, mesmo quando bem fundamentada, não identifica a causa do desequilíbrio.
Deborah Mayo procura reorganizar elementos úteis de Fisher e de Neyman–Pearson para avaliar quão bem uma afirmação foi posta à prova. A sua abordagem de error statistics parte desta pergunta:
Se esta afirmação estivesse errada de uma maneira importante, o teste teria tido uma boa oportunidade de mostrar isso?
Mayo e Spanos (2006) distinguem propriedades do procedimento avaliadas antes dos dados de uma avaliação inferencial feita depois dos dados para uma afirmação e um resultado concretos.
Antes dos dados, podemos estudar taxas de erro, poder e sensibilidade. Depois dos dados, perguntamos se uma afirmação específica passou um teste que teria tendência para produzir um resultado menos favorável caso essa afirmação estivesse errada de uma forma relevante.
Uma Ponte Entre Fisher e Neyman–Pearson
É aqui que Mayo aproxima ideias que a narrativa «Fisher contra Neyman–Pearson» costuma separar: de Fisher retém a preocupação com evidência num resultado concreto; de Neyman–Pearson usa o desempenho do procedimento sob alternativas para avaliar quão capaz era o teste de descobrir um erro. A severidade não elimina diferenças históricas entre as escolas. Propõe uma maneira de usar probabilidades de erro para avaliar a força probatória de uma inferência concreta (Mayo, 2018).
É esta a contribuição de error statistics que nos interessa: relacionar as propriedades do teste com as afirmações que o resultado sustenta. Mayo e Spanos (2006) argumentam que as probabilidades de erro não servem apenas para orientar comportamentos futuros; podem ajudar a justificar inferências após observarmos os dados. Trata-se de uma posição filosófica substantiva, sujeita a debate, que orienta a posição adoptada neste site.
DicaPré-Dados e Pós-Dados
- Pré-dados: que erros este procedimento controla? Que efeitos consegue detectar?
- Pós-dados: dado o resultado que obtivemos, que afirmações passaram um teste capaz de as pôr realmente em risco?
Confundir estas perguntas é uma fonte importante de mal-entendidos.
A severidade acompanha a afirmação concreta. Num teste adequado, um resultado pode dar bom apoio à existência de uma discrepância relativamente a zero sem sustentar que ela excede uma magnitude importante. Para a atribuir a uma intervenção ou generalizar a outros contextos, precisamos também de justificar o delineamento e a medição.
O baixo poder para um efeito especificado, por si só, não invalida uma detecção que ocorreu. Precisamos de avaliar o resultado observado e a discrepância que se pretende sustentar (Mayo & Spanos, 2006, secções 5.2–5.4).
Também vale a pena ler Mayo (1992) sobre o papel epistémico de Egon Pearson e a reconstrução histórica de Mayo (2018, Tour III). A controvérsia histórica fica aberta a quem quiser seguir os argumentos nas fontes.
NotaPara Ler / Explorar
- Mayo & Spanos (2006), Severe Testing as a Basic Concept in a Neyman–Pearson Philosophy of Induction.
- Mayo (1992), Did Pearson Reject the Neyman–Pearson Philosophy of Statistics?.
- Mayo (1991), Novel Evidence and Severe Tests.
- Mayo (1997), Error Statistics and Learning from Error.
- Mayo (2013), comentário de error statistics a Gelman & Shalizi.
- Mayo (2018), Statistical Inference as Severe Testing.
O Que Mayo Questiona no Bayesianismo
A posição de Mayo torna-se mais clara quando a comparamos com o Bayesianismo. Um bayesiano pode perguntar quão provável é um parâmetro ou modelo depois de combinar prior e dados. Mayo não considera que essa probabilidade posterior seja necessária para avaliar quão bem uma afirmação foi testada. A pergunta que privilegia é outra: o procedimento teria sido capaz de revelar um erro relevante, caso esse erro existisse?
Mayo (2013), comentando Gelman e Shalizi (2013), aceita muito do valor prático de verificação de modelos mas questiona se a filosofia bayesiana fornece as propriedades de detecção de erro que considera necessárias para justificar afirmações científicas. Mesmo reconhecendo o valor prático das análises, os autores divergem sobre o que conta como garantia probatória.
A aproximação a Fisher e Neyman–Pearson não elimina, portanto, o desacordo de Mayo com interpretações bayesianas da inferência. A questão continua a ser como justificar o apoio que atribuímos a uma afirmação.
A estatística frequentista também procura aprender com dados. Fundamenta essa aprendizagem no comportamento dos procedimentos, na incompatibilidade com modelos e na capacidade de revelar erros. As tradições divergem na justificação da inferência e no papel que atribuem às probabilidades para representar a incerteza sobre hipóteses ou parâmetros.
A Escolha Inferencial Deste Site
A nossa objecção incide na interpretação filosófica da distribuição posterior como probabilidade de hipóteses ou valores de parâmetros e, sobretudo, na ideia de que essa probabilidade basta para responder à pergunta evidencial que nos interessa. O teorema de Bayes mantém-se válido com outras interpretações da probabilidade.
Na perspectiva de error statistics de Mayo, evidência forte exige error probing: uma afirmação ganha suporte quando passa um teste que teria boa capacidade para revelar maneiras relevantes de ela estar errada. Uma probabilidade posterior elevada, ou um factor de Bayes favorável, não garante por si só essa propriedade; depende do modelo e dos priors considerados e responde a uma pergunta inferencial diferente (Mayo, 2018).
Neste site, a linguagem de erros, sensibilidade, poder e severidade também liga mais directamente a inferência ao delineamento experimental. Por isso vamos compreender a lógica bayesiana e algumas das suas vantagens e dificuldades, mas as análises que aprendemos a executar serão frequentistas. Não ensinaremos aqui a ajustar modelos bayesianos no R. A perspectiva de error statistics orienta a discussão: interessa-nos perceber o que um estudo conseguiu pôr à prova, o que ficou por testar e que conclusões o resultado sustenta. Esta escolha orienta o percurso do site; as outras tradições têm aqui espaço para podermos compreender e discutir as suas respostas.
Pausa de Leitura
6 Planeamento e Interpretação
Poder Como Curva
Na segunda pergunta da moeda, comparámos regras pelos erros que cometem. Na terceira, perguntámos que desvios o estudo poderia revelar. O planeamento começa por especificar esses desvios relevantes.
Esta exigência corrige uma maneira muito comum de falar. Um estudo não tem simplesmente «80% de poder para detectar um efeito». O poder é uma função dos valores que poderiam ser verdadeiros:
\[ \pi(\theta) = P_\theta(\text{rejeitar } H_0). \]
Ou seja: o poder é uma curva. Para cada valor possível de \(\theta\) existe uma probabilidade diferente de rejeitar \(H_0\). O que habitualmente aparece num artigo, numa análise de poder ou num cálculo de tamanho amostral é apenas um ponto dessa curva.
Quando dizemos «80% de poder», estamos normalmente a omitir a continuação da frase: 80% de poder se o verdadeiro parâmetro for este valor específico, mantendo também fixas as restantes suposições do cálculo. A linguagem corrente transforma assim uma função inteira num único número e pode dar a impressão errada de que «o poder» é uma propriedade fixa do estudo.
Na ilustração de uma amostra que vamos usar, \(d\) é a diferença estandardizada entre a média populacional \(\mu\) e o valor de referência \(\mu_0\): \(d=(\mu-\mu_0)/\sigma\), onde \(\sigma\) é o desvio-padrão populacional. A diferença fica expressa em unidades de desvio-padrão, em vez de palavras recordadas, segundos ou outra unidade da medida. Assim, \(d=.50\) corresponde a meio desvio-padrão. Noutros delineamentos, precisamos de indicar qual é a diferença e qual é o desvio-padrão usado para a estandardizar.
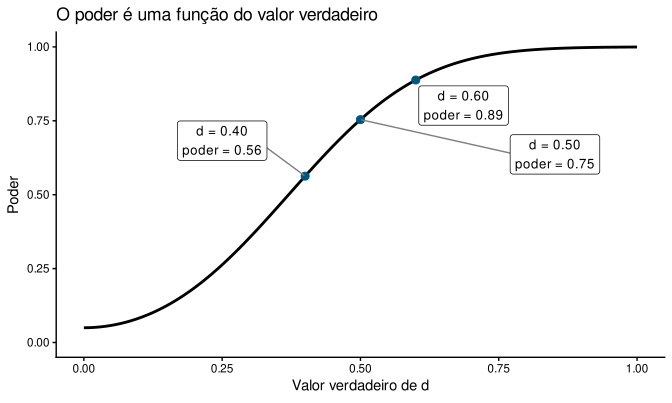
Por exemplo, dizer que planeámos um estudo para detectar um «efeito médio» não faz desaparecer esta dependência. Se «médio» significar, por convenção, \(d=0.50\), então o cálculo está a avaliar o procedimento no ponto \(d=0.50\). Se o verdadeiro efeito for \(d=0.20\), o poder é outro; se for \(d=0.80\), é outro. O rótulo pequeno/médio/grande apenas esconde temporariamente o valor numérico que entrou no cálculo.
Como se obtém cada ponto dessa curva? Nos Fundamentos da Inferência, podemos ver o que acontece às áreas de rejeição quando mantemos a regra e mudamos a diferença populacional. Aqui interessa-nos perceber o que fica por dizer quando resumimos o poder num único número.
Mesmo perto do ponto convencional \(d=.50\), a diferença pode ser substantiva. A figura seguinte usa apenas um exemplo ilustrativo: teste t bilateral de uma amostra, \(N=30\), \(\alpha=.05\). A faixa \(d=.40\)–\(.60\) não é uma definição formal de «médio»; serve apenas para mostrar que uma etiqueta de T-shirt pode esconder valores com poderes bastante diferentes.
Neste delineamento fixo, o poder passa aproximadamente de 0.56 em \(d=.40\) para 0.89 em \(d=.60\). Mesmo nesta faixa estreita, o número muda bastante. «80% de poder» é um ponto numa curva, não uma propriedade única do estudo.
Neyman–Pearson estudam tanto alternativas simples como problemas mais gerais com alternativas compostas. Por isso, é mais rigoroso dizer que o poder é avaliado ponto a ponto ao longo de \(H_1\) do que dizer que \(H_1\) tem necessariamente de ser uma hipótese pontual. Mas qualquer número de poder isolado corresponde sempre a algum ponto — ou conjunto de pressupostos muito específico — dessa função.
NotaPorque o Poder É Mais Exigente
Sob \(H_0\), muitas vezes conseguimos especificar um modelo de referência simples: por exemplo, diferença zero mais variabilidade aleatória. Para calcular poder, temos de perguntar também como seria a distribuição dos dados se um valor alternativo concreto fosse verdadeiro.
É aqui que a teoria de Neyman–Pearson mostra a dificuldade que Fisher podia evitar num teste de significância puro. Não basta modelar o ruído sob o nulo. Precisamos de especificar uma alternativa, a dimensão do efeito, o tamanho amostral, a variabilidade e as restantes condições relevantes. Só então podemos calcular a probabilidade de a regra rejeitar \(H_0\) nesse mundo alternativo.
Planeamento: Equivalência, Sensibilidade e \(\alpha\)
A discussão anterior tem consequências práticas. Se queremos saber quão bem uma afirmação foi testada, não basta olhar para o resultado depois de o obter. Precisamos de pensar antecipadamente que diferenças seriam importantes e que erros o estudo teria capacidade para revelar.
Não Significativo ≠ Ausência
Se um teste não rejeita \(H_0\), isso pode acontecer porque o efeito é pequeno, porque os dados são imprecisos ou porque o estudo tem pouca sensibilidade. Para apoiar a afirmação de que não existe um efeito grande o suficiente para ser cientificamente relevante, precisamos de uma pergunta mais específica.
Os testes de equivalência definem limites para o menor efeito que valeria a pena distinguir de zero (Lakens, 2017; Lakens et al., 2018). Isto não «prova o nulo» em sentido absoluto: permite rejeitar uma classe de efeitos considerados grandes o suficiente para interessar. O exemplo com intervalos mostra a diferença entre não detectar e excluir magnitudes relevantes.
Sensibilidade e Tamanho da Amostra
Se o tamanho da amostra já está fixado, uma análise de sensibilidade de poder pergunta que magnitude de efeito teria uma probabilidade especificada de ser detectada. Lakens (2022) descreve ainda várias formas de justificar tamanho amostral para além de uma única receita de poder.
Justificar \(\alpha\)
O limiar \(\alpha=.05\) é uma convenção histórica, não uma constante da natureza. A história de \(.05\) e \(.01\) mostra ainda por que não devemos transformar retrospectivamente o \(P\) fisheriano no \(\alpha\) de Neyman–Pearson: as convenções influenciaram-se, mas os conceitos não são idênticos. Lakens et al. (2018) defendem que escolhas como \(\alpha\) devem ser transparentes e justificadas. Maier e Lakens (2022) apresentam abordagens práticas.
AvisoEvitar um Novo Ritual
«Justificar \(\alpha\)» não deve transformar-se noutra caixa para assinalar. A pergunta é que erros importam, que custos têm, que efeito queremos detectar e quão informativo será o estudo.
Intervalos e «Novas Estatísticas»
Intervalos de confiança são extremamente úteis. Mostram a escala de valores que o procedimento não exclui ao nível correspondente e ajudam a comunicar magnitude e precisão. Para recordar de onde vem a incerteza de uma estimativa, podemos voltar às distribuições amostrais e ao erro-padrão. O problema começa quando se apresenta «usar intervalos» como se fosse, por si só, uma filosofia inferencial completamente diferente de «usar testes».
Testes e Intervalos
Para muitos testes frequentistas usuais, o intervalo de confiança correspondente pode ser construído invertendo o teste: os valores do parâmetro que não seriam rejeitados ao nível escolhido formam o intervalo. Perezgonzalez (2015) enfatiza precisamente que testes e intervalos podem ser dois lados da mesma pergunta.
Os intervalos permitem muitas vezes comunicar magnitude e precisão muito melhor do que uma decisão binária. Essa vantagem mantém-se mesmo quando o IC e o teste respondem à mesma pergunta. Ao trocar um valor-p por um IC, continuamos a trabalhar sob pressupostos frequentistas, e não com uma distribuição posterior.
NotaExemplo Hipotético: Que Diferenças Excluímos?
Imaginemos dois estudos sobre recordação de palavras. Em ambos, a diferença média estimada entre condições é 0.2 palavras, mas a precisão é diferente. Para simplificar, usamos intervalos t com 29 graus de liberdade:
| Estudo | Erro-Padrão da Diferença | IC de 95% para a Diferença |
|---|---|---|
| A | 0.8 palavras | [-1.44, 1.84] palavras |
| B | 0.2 palavras | [-0.21, 0.61] palavras |
Suponhamos que, antes dos dados, justificámos como relevantes diferenças de pelo menos uma palavra, em qualquer direcção. Este limite é inventado para o exemplo; não é uma recomendação para estudos de memória.
Os dois ICs incluem zero: nenhum dos testes bilaterais correspondentes rejeita diferença zero a \(\alpha=.05\). Mas o estudo A também não exclui diferenças relevantes. No estudo B, todo o IC fica entre -1 e 1. Podemos dizer: «A estimativa é 0.2 palavras, IC de 95% [-0.21, 0.61]; nas condições do modelo, o intervalo exclui diferenças de uma palavra ou mais em qualquer direcção.» Esta conclusão vale para a medida, a comparação e o alcance do estudo. Permite excluir aquelas magnitudes, sem provar que o efeito seja exactamente zero.
Para o teste de equivalência TOST, com cada teste unilateral a \(\alpha=.05\), o intervalo correspondente é de 90%, não de 95% (Lakens, 2017). Ter o IC de 95% inteiramente dentro dos limites, como em B, é um critério mais conservador.
A Proposta das «Novas Estatísticas»
Cumming (2014) defende uma mudança de ênfase para tamanhos de efeito, intervalos de confiança, meta-análise, replicação e acumulação quantitativa. Há muito de valioso aqui: comunicar magnitudes, mostrar incerteza e acumular evidência é preferível a publicar apenas «significativo / não significativo».
O próprio Cumming reconhece que, nos casos correspondentes, ICs e valores-p assentam na mesma teoria estatística e é possível passar de um para o outro. O argumento a favor dos intervalos é sobretudo que tornam magnitude e precisão mais visíveis ao leitor, não que pertençam a uma filosofia probabilística totalmente diferente (Cumming, 2014). Perezgonzalez (2015) aprofunda este ponto, distinguindo a história fisheriana dos valores-p da origem Neyman–Pearson dos intervalos e mostrando a dualidade matemática entre testes e intervalos correspondentes.
A simples substituição de NHST por intervalos deixa, porém, vários problemas inferenciais por resolver. García-Pérez (2017) argumenta que muitas críticas ao NHST atacam interpretações que o procedimento nunca justificou e que alternativas, incluindo ICs, tamanhos de efeito e métodos bayesianos, também podem ser mal interpretadas ou usadas mecanicamente.
Mayo levantou a mesma questão em discussão directa com Cumming: como os intervalos correspondentes são duais aos testes, que erro inferencial é realmente corrigido pela simples troca de formato? A discussão está reunida em Do CIs Avoid Fallacies of Tests? Reforming the Reformers e na resposta de Cumming.
Os Intervalos Também São Mal Interpretados
Hoekstra et al. (2014) relataram interpretações incorrectas persistentes de ICs em estudantes e investigadores. A leitura desse questionário foi depois contestada por Miller e Ulrich (2016), sobretudo quanto ao que as respostas permitem concluir sobre compreensão dos ICs. Morey et al. (2016) desenvolvem a questão conceptual: várias afirmações intuitivas sobre um IC observado não se seguem da teoria frequentista que o gerou.
Um IC frequentista de 95% não significa que, depois de calculado, há 95% de probabilidade de o parâmetro fixo estar dentro daquele intervalo específico. A garantia refere-se ao procedimento de construção de intervalos sob o modelo.
NotaO Problema Não É Mostrar Incerteza
Intervalos de confiança podem comunicar incerteza muito melhor do que um asterisco de significância. Para os interpretar, precisamos de compreender a inferência, qualquer que seja a visualização ou o resumo escolhido. Um IC interpretado como distribuição posterior é tão enganador como um valor-p interpretado como \(P(H_0\mid D)\).
NotaPara Ler / Explorar
- Cumming (2014), The New Statistics: Why and How.
- García-Pérez (2017), Thou Shalt Not Bear False Witness Against Null Hypothesis Significance Testing.
- Perezgonzalez (2015), Confidence Intervals and Tests Are Two Sides of the Same Research Question.
- Hoekstra et al. (2014), Robust Misinterpretation of Confidence Intervals.
- Morey et al. (2016), The Fallacy of Placing Confidence in Confidence Intervals.
- Mayo (1981), In Defense of the Neyman-Pearson Theory of Confidence Intervals.
7 História e Controvérsias
Mergulhar Mais Fundo
Fisher, Neyman e Pearson
Apresentar Neyman–Pearson como uma teoria exclusivamente comportamental, sem qualquer interesse na aprendizagem científica, também empobrece a história. Mayo (1992) reconstrói a posição de Egon Pearson e argumenta que preocupações epistémicas com a distinção entre efeitos genuínos e espúrios participaram no desenvolvimento desta teoria. A utilização de regras de decisão e taxas de erro não determina, por si só, uma interpretação filosófica única de tudo o que se pode aprender com um teste.
A contribuição de Pearson não deve desaparecer dentro da abreviatura «Neyman». A teoria nasceu de uma colaboração intelectual documentada nos artigos conjuntos e na reconstrução histórica de Lehmann (2011). Neyman e Pearson (1933b) discutiram até a relação dos seus testes com probabilidades a priori, o que por si só mostra como a história é mais rica do que slogans posteriores.
NotaFisher Foi Sempre Claro Sobre a Probabilidade?
Fisher distinguia a probabilidade de cauda da probabilidade de uma hipótese depois dos dados. Não há boa base histórica para lhe atribuir a leitura do valor-p como \(P(H_0\mid D)\). Antes de 1930, rejeitava explicitamente a probabilidade inversa como justificação geral para atribuir probabilidades a parâmetros desconhecidos.
Isso não torna os seus textos sempre fáceis de interpretar. Aldrich (2000) mostra que, em 1925 e 1928, Fisher usava palavras como «provável», «provavelmente» e «presunção» ao falar de limites inferenciais, sem lhes associar sempre uma probabilidade formal.
Em Inverse Probability (1930), Fisher propõe a probabilidade fiducial para fazer afirmações probabilísticas sobre parâmetros sem recorrer a um prior. Aldrich aponta lacunas, ambiguidades e contradições nessa exposição. Fisher viria a reformular a justificação do argumento fiducial. A sua maneira de passar das distribuições amostrais à inferência sobre parâmetros mudou ao longo do tempo, e uma frase isolada dificilmente dá conta desse percurso.
De Onde Vieram .05 e .01?
Os valores \(.05\) e \(.01\) não apareceram por uma única razão. Tornaram-se convencionais por uma sequência de escolhas históricas que se reforçaram umas às outras. Há também uma distinção de linguagem importante: Fisher discutia valores \(P\) e níveis de significância; \(\alpha\) como taxa de erro escolhida antes dos dados pertence à teoria de Neyman–Pearson. Por isso, quando hoje falamos informalmente da história de «\(\alpha=.05\)», estamos a juntar tradições que originalmente não eram idênticas.
Os principais passos foram estes:
- Já existia uma regra aproximada antes de Fisher. No início do século XX, resultados eram avaliados através de múltiplos do chamado erro provável. A tradição de tratar desvios próximos de dois desvios-padrão como especialmente notáveis antecede Statistical Methods for Research Workers (Cowles & Davis, 1982).
- Fisher deu a 5% uma formulação explícita e muito influente. Em 1925 observou que \(P=.05\) corresponde a cerca de 1.96 desvios-padrão e apresentou esse ponto como um limite conveniente para julgar significância (Fisher, 1925, cap. III). Noutro capítulo descreveu a regra de duas vezes o erro-padrão, aproximadamente equivalente a \(P=.05\), como uma convenção prática (Fisher, 1925, cap. V).
- O próprio Fisher admitia outros níveis. Em 1926 referiu explicitamente 2% e 1% como alternativas mais exigentes, embora dissesse preferir 5% como padrão baixo de significância (Fisher, 1926). Isto ajuda a explicar por que \(.05\) e \(.01\) ficaram associados como referências de exigência diferente, em vez de 5% surgir como uma constante científica especial.
- As tabelas favoreceram um pequeno conjunto de valores fáceis de consultar. Na tabela de \(\chi^2\), Fisher escolheu valores específicos de \(P\) e imprimiu os valores críticos correspondentes, em vez de tentar tabular todas as probabilidades possíveis (Fisher, 1925, cap. IV). Para a distribuição de \(z\), a primeira edição oferece uma pequena tabela para \(P=.05\) e observa que acrescentar \(P=.01\) provavelmente cobriria as necessidades correntes (Fisher, 1925, cap. I). Quando calcular probabilidades exactas à mão era trabalhoso, consultar valores críticos impressos tornava estes pontos especialmente fáceis de reutilizar.
- Neyman e Egon S. Pearson deram aos níveis escolhidos um papel diferente. Na sua teoria de testes, uma taxa \(\alpha\) é fixada antes dos dados como probabilidade de erro de Tipo I da regra de decisão. Isso ajudou a transformar níveis de significância familiares em limiares operacionais para procedimentos repetidos (Neyman & Pearson, 1933a).
- A repetição consolidou a convenção. Tabelas, manuais, ensino e prática aplicada difundiram os mesmos poucos níveis por várias disciplinas. Kennedy-Shaffer (2019) mostra como esta história de refinamento, difusão e combinação de tradições contribuiu para que \(p<.05\) acabasse tratado como padrão geral, muitas vezes sem a justificação histórica que lhe deu origem.
Assim, \(.05\) e \(.01\) tornaram-se comuns porque prolongavam convenções anteriores, foram divulgados por Fisher e eram fáceis de consultar nas tabelas. A teoria de Neyman–Pearson deu-lhes outro papel nas regras de decisão, e a repetição no ensino e na prática consolidou-os. Esta história explica a sua popularidade, mas não basta para justificar a escolha num estudo novo.
O Que as Tabelas Faziam na Prática
Uma tabela de valores críticos podia localizar um resultado num intervalo sem obrigar a calcular a probabilidade exacta. No capítulo de \(\chi^2\), por exemplo, Fisher explica que, para uso prático, a primeira necessidade era perceber se o resultado merecia suspeita e destaca vários pontos de referência, incluindo \(.05\) (Fisher, 1925, cap. IV). Isso é compatível com tratar valores \(P\) menores como discrepâncias mais fortes: a tabela podia dizer, por exemplo, que \(.02<P<.05\), mesmo sem produzir imediatamente um valor exacto.
NotaAntes de Fisher: Um Teste 50/50 em 1710
Um antecedente importante dos testes de significância aparece em Arbuthnot (1710). Arbuthnot analisou registos anuais de nascimentos de Londres. Em cada um dos 82 anos considerados nasceram mais rapazes do que raparigas. No modelo que adoptou, «rapazes em maioria neste ano» e «raparigas em maioria neste ano» eram tratados como resultados 50/50. Obter a mesma direcção em 82 anos seguidos teria então probabilidade \((1/2)^{82}\).
Isto não é exactamente um teste binomial moderno aplicado a todos os nascimentos individuais. O interesse histórico está na estrutura: especificar um processo aleatório de referência e perguntar quão extremo é o padrão observado. Kennedy-Shaffer (2019) inclui este episódio na genealogia dos testes de significância.
É a mesma estrutura que usamos, com um exemplo deliberadamente neutro, em Fundamentos da Inferência.
NotaAntes de Fisher: Student Dava Outra Leitura à Probabilidade
Em 1908, William Sealy Gosset, que publicava como Student, derivou e tabulou a distribuição que deu origem ao teste t. No exemplo sobre horas de sono, Student (1908) obteve uma probabilidade acumulada de cerca de \(.9985\) e converteu-a em odds de aproximadamente 666 para 1 de que um tratamento fosse melhor do que o outro.
Isto é historicamente importante porque a interpretação é muito próxima do que hoje chamaríamos probabilidade inversa ou bayesiana. Zabell (2008) descreve explicitamente a perspectiva inferencial inicial de Student como bayesiana; Senn e Richardson (1994) destacam a mesma interpretação do exemplo. A posição do próprio Student também viria a evoluir.
Isto não quer dizer que o valor-p moderno seja uma probabilidade posterior. Mostra antes que probabilidades de cauda e distribuições amostrais já eram calculadas antes de Fisher e podiam receber uma interpretação que invertia a direcção da inferência. Na sua 36.ª Fisher Memorial Lecture, Stephen Senn reconstrói precisamente esta mudança: Fisher não inventou as probabilidades de cauda; insistiu que a interpretação inversa era insegura e deu-lhes uma leitura directa sob um modelo de referência.
A Guerra Não Foi Só Intelectual
Fisher e Neyman tinham desacordos metodológicos reais. Mas a história também é uma história de pessoas. Lehmann (2011) descreve uma relação que se tornou profundamente hostil. A própria história institucional da UCL regista que a animosidade entre Fisher e Neyman criava fricção entre departamentos instalados no mesmo edifício.
A ruptura agravou-se em torno da controvérsia de 1935 sobre delineamentos experimentais. Sabbaghi e Rubin (2014) mostram que o episódio envolvia questões técnicas reais, erros e mal-entendidos. Mayo usa esta história para argumentar que parte da imagem de duas filosofias absolutamente incompatíveis foi amplificada pelo conflito pessoal e pela retórica da disputa (Mayo, 2018, Tour III).
O conflito pessoal agravou a disputa. Para compreender o desacordo, precisamos de distinguir as diferenças técnicas da retórica com que foram apresentadas.
O Desacordo de 1955–1956
Fisher (1955) critica «repeated sampling», erros de segundo tipo e «inductive behaviour». E. S. Pearson (1955) responde a Fisher. Neyman (1956) defende a necessidade de considerar alternativas e os dois tipos de erro.
Ao ler esta sequência, podemos acompanhar o desacordo nas palavras dos próprios autores. Discutiam problemas comuns, mas com objectivos e vocabulários parcialmente diferentes.
NHST Como Quimera?
Uma crítica influente diz que a prática moderna de NHST junta o valor-p evidencial de Fisher ao \(\alpha\) e à regra de decisão de Neyman–Pearson apesar de estes conceitos nascerem em programas diferentes (Hubbard & Bayarri, 2003). Perezgonzalez (2014) apresenta uma reconstrução semelhante.
A crítica é útil quando impede confusões: valor-p observado e \(\alpha\) não são a mesma coisa. Mas dizer apenas «é uma quimera incoerente» também pode ocultar demasiado. Berger (2003) mostra zonas de aproximação entre escolas. Já vimos uma tentativa de reorganizar elementos das duas tradições: a abordagem de error statistics de Deborah Mayo.
Ao combinar estas ferramentas, saibam que conceito estão a usar, em que momento e para responder a que pergunta.
Fisher e Neyman–Pearson discordavam sobre bastante coisa. Parte dessas diferenças pode ser reconciliada. O verdadeiro milagre aconteceu nos manuais: desapareceram as nuances e sobrou \(p<.05\).
NotaPara Ler / Explorar
- Arbuthnot (1710), An Argument for Divine Providence.
- Student (1908), The Probable Error of a Mean.
- Senn & Richardson (1994), The First t-Test.
- Zabell (2008), On Student’s 1908 Article “The Probable Error of a Mean”.
- Senn (2008), A Century of t-Tests.
- Fisher (1925), Statistical Methods for Research Workers.
- Fisher (1926), The Arrangement of Field Experiments.
- Aldrich (2000), Fisher’s “Inverse Probability” of 1930.
- Cowles & Davis (1982), On the Origins of the .05 Level of Statistical Significance.
- Kennedy-Shaffer (2019), Before p < 0.05 to Beyond p < 0.05.
- Senn (2017), And Thereby Hangs a Tail: The Strange History of P-values.
- Neyman & Pearson (1928a) e 1928b.
- Neyman & Pearson (1933a), On the Problem of the Most Efficient Tests of Statistical Hypotheses.
- Neyman & Pearson (1933b), probabilidades a priori.
- Fisher (1955), Pearson (1955) e Neyman (1956).
- Lehmann (2011), Fisher, Neyman, and the Creation of Classical Statistics.
- Sabbaghi & Rubin (2014).
- Mayo (2018), Deconstructing the N-P versus Fisher Debates.
8 Aprofundamentos de Probabilidade
Mergulhar Mais Fundo
Na primeira leitura, podemos seguir para Prática Científica. Para explorar os priors e os factores de Bayes, continue abaixo.
Priors e Factores de Bayes
Nem Todos os Priors São Iguais
Uma motivação subjectivista é simples: investigadores já têm expectativas e conhecimento prévio, portanto é preferível torná-los explícitos e actualizá-los coerentemente com os dados. Mas Bayesianismo não é sinónimo de subjectivismo. Há tradições de Bayesianismo objectivo ou de referência que procuram construir priors através de regras formais (Bernardo, 1979; Berger, 2006).
Podemos distinguir, de forma aproximada:
- priors informativos, que codificam conhecimento substantivo;
- priors fracamente informativos, que regularizam e excluem valores implausivelmente extremos sem dominar a análise (Gelman et al., 2008);
- priors ditos objectivos, de referência ou construídos por regras formais (Bernardo, 1979; Berger, 2006);
- priors muito vagos ou «não informativos», uma expressão que deve ser usada com cautela: ser difuso numa parametrização não significa ser neutro em todas as parametrizações ou para todas as perguntas.
Por isso, «o bayesiano escolhe um prior subjectivo» é uma caricatura tão pobre como «o frequentista só pensa em repetições infinitas». O debate não é simplesmente «dados versus opinião»; há desacordo também dentro do Bayesianismo sobre subjectividade, objectividade, regularização e regras de referência.
O Prior Desaparece?
Em muitos modelos regulares e bem identificados, à medida que os dados se tornam mais informativos, a influência de diferentes priors razoáveis pode diminuir e as respectivas distribuições posteriores podem aproximar-se. A literatura sobre consistência e resultados assintóticos bayesianos formaliza situações em que esta intuição funciona; Gelman e Shalizi (2013) discutem essa tradição e também os limites de tratar a convergência assintótica como uma justificação suficiente da prática.
Com dados fracos, parâmetros pouco identificados, modelos complexos ou priors que excluem regiões relevantes, essa influência pode permanecer importante. Precisamos, por isso, de verificar se as conclusões resistem à escolha de outros priors. Os desacordos iniciais podem diminuir à medida que obtemos mais informação, nas condições descritas acima. Fora delas, a convergência não está garantida.
Valores-p e Factores de Bayes: Relações Próximas
Em algumas análises comuns, valores-p e factores de Bayes estão muito mais próximos do que a mudança de linguagem sugere. García-Pérez (2017, pp. 640–644, figuras 2–3) ilustra essa proximidade em testes t de uma amostra ou de amostras emparelhadas e em testes de correlação. Fixados o tamanho da amostra, os modelos e a especificação do prior, os factores de Bayes estudados têm uma relação um-para-um com os valores-p correspondentes.
Porquê? Nesses casos, os dois números são calculados a partir da mesma estatística — o t ou a correlação observada — e das quantidades já fixadas. Nos gráficos de García-Pérez, os pares de valores alinham-se numa curva, tanto quando a hipótese nula é verdadeira como quando é falsa. Para cada tamanho amostral e especificação considerados, conhecer um dos números permite determinar o outro. Nessas condições, o factor de Bayes exprime noutra escala a informação dos dados já contida no valor-p. A interpretação muda: o factor de Bayes compara as probabilidades marginais dos dados sob dois modelos, enquanto o valor-p mede uma probabilidade de cauda sob o modelo de referência. A proximidade matemática mantém-se.
Esta relação ajuda a perceber por que uma troca de ferramenta pode alterar menos do que esperamos. Se usarmos limiares que correspondam entre si nessa curva, obtemos as mesmas classificações dos resultados. Usar \(p<.05\) e um limiar convencional de factor de Bayes, por outro lado, pode dar classificações diferentes simplesmente porque escolhemos pontos diferentes da curva. Para comparar as regras, precisamos de saber onde colocámos os limiares e como se comportam.
Há também dificuldades partilhadas. Nas simulações de García-Pérez, ambos variam entre amostras e podem dar indicações desfavoráveis a uma hipótese nula verdadeira ou favoráveis a uma hipótese nula falsa. Com amostras suficientemente grandes, ambos podem assinalar desvios pequenos, cuja importância científica continua por justificar. Substituir «significativo» por «evidência forte» não resolve, por si só, a passagem do resultado estatístico à conclusão científica. Precisamos ainda de avaliar a magnitude, o delineamento e aquilo que foi realmente posto à prova.
NotaDe Que Depende a Relação?
A correspondência descrita pertence aos testes e factores de Bayes especificados acima. A curva muda com o tamanho da amostra e com o prior: conhecer apenas \(p\), sem essa informação, não determina um factor de Bayes. García-Pérez mostra também que alterar a escala do prior nos testes t estudados muda a curva, mas mantém a relação um-para-um depois de fixada essa escolha.
Para aprofundar outras relações entre as duas medidas, Sellke et al. (2001) estudam a calibração de valores-p em termos de evidência bayesiana. Berger e Sellke (1987) discutem ainda como as conclusões podem divergir em testes de uma hipótese nula pontual, incluindo situações associadas ao paradoxo de Jeffreys–Lindley. A relação próxima numa análise fixada não exige que convenções de interpretação diferentes coincidam em todos os tamanhos amostrais.
NotaPara Ler / Explorar
- Gelman & Shalizi (2013), Philosophy and the Practice of Bayesian Statistics.
- Berger (2006), The Case for Objective Bayesian Analysis.
- García-Pérez (2017) — relação entre p e factores de Bayes em testes especificados e crítica de inferências automáticas.
- Sellke et al. (2001), Calibration of p Values for Testing Precise Null Hypotheses.
- Berger & Sellke (1987), The Irreconcilability of P Values and Evidence.
- van Doorn et al. (2021), orientações JASP.
9 Prática Científica
Estatística Ritual
Stark e Saltelli (2018) usam a expressão cargo-cult statistics para descrever a aplicação mecânica de procedimentos: seguimos a forma reconhecível da análise sem compreender suficientemente o que cada passo faz, que pergunta responde ou que pressupostos exige.
Nesta página preferimos chamar-lhe estatística ritual. A expressão descreve a aplicação mecânica dos procedimentos sem recorrer à metáfora antropológica.
Um exemplo simples é transformar «\(p<.05\)» numa rotina automática: correr o teste, procurar o asterisco e escrever «há efeito» ou «não há efeito» sem pensar na magnitude, precisão, sensibilidade, multiplicidade ou no delineamento.
Mas o problema não pertence ao NHST. Também podemos escolher um prior por defeito, copiar um factor de Bayes, desenhar um intervalo de confiança ou reportar um tamanho de efeito sem compreender o que cada número permite afirmar. Substituir uma ferramenta por outra não elimina o ritual.
García-Pérez (2017) é útil precisamente por mostrar que várias falhas atribuídas ao NHST são falhas de interpretação ou de delineamento que podem reaparecer com outras ferramentas.
A salvaguarda é reconstruir a cadeia de raciocínio: o que queremos saber, que dados podem responder, que erro seria relevante, que modelo estamos a usar, que alternativas o procedimento consegue distinguir e que conclusão o resultado permite?
10 Síntese
Um Mapa de Perguntas
- Descrição: o que aconteceu nesta amostra?
- Estimação: que valores para o parâmetro são compatíveis com estes dados e este modelo?
- Fisher: quão incompatíveis são os dados com \(H_0\)?
- Neyman–Pearson: como se comporta esta regra sob \(H_0\) e alternativas relevantes?
- Poder/sensibilidade: que discrepâncias conseguiríamos detectar?
- Bayes: como muda a incerteza depois de combinar prior e dados?
- Verosimilhança: qual das hipóteses torna os dados observados mais prováveis, e por quanto?
- Fiducial: podemos justificar uma distribuição sobre o parâmetro invertendo a relação amostral, sem começar por um prior?
- Mayo: se esta afirmação estivesse errada desta maneira, o teste teria boa oportunidade de mostrar isso?
- Equivalência: podemos excluir efeitos suficientemente grandes para serem relevantes?
- Intervalos: que valores não são excluídos pelo procedimento no nível escolhido e com que precisão estamos a estimar?
- Decisão: que acção escolher, dados os custos dos erros?
O Que Reter e Onde Continuar
Para perceber o que aprendemos com um resultado, precisamos de conseguir dizer:
- que pergunta o procedimento responde;
- que pressupostos foram necessários;
- que erros ou discrepâncias podia revelar;
- quanta incerteza permanece;
- que conclusões não são justificadas pelos dados.
Para acompanhar as contas da moeda, das distribuições e das médias, continuem nos Fundamentos da Inferência. Para trabalhar com estas ideias em modelos concretos, sigam A Abordagem de Comparação de Modelos. Para pressupostos, robustez e triangulação, vejam Diagnóstico e Pressupostos. Para a base filosófica sobre testes e erro, regressem a Filosofia da Ciência.
11 Exercícios
Os exemplos seguintes são inventados. Não precisam de saber R, nem de inventar um estudo na vossa área. Comecem pelas situações concretas. Para cada resposta, expliquem o vosso raciocínio em poucas frases. Por vezes, a melhor resposta será dizer que informação falta.
Quatro Situações Para Pensar
Experimentem responder primeiro. Nas perguntas sobre tradições estatísticas, estas respostas servem para orientar a argumentação, não para encerrar uma controvérsia.
-
A Máquina dos Autocolantes. Uma máquina deveria produzir autocolantes vermelhos e azuis com a mesma probabilidade. Suspeitamos, antes do teste, de que favorece o vermelho. Em dez autocolantes, saem sete vermelhos. Se a máquina funcionasse como previsto, a probabilidade de obter sete ou mais vermelhos seria aproximadamente 17.2%. Para nove ou mais, seria 1.1%.
- Em qual dos dois resultados desconfiariam mais da máquina? Porquê?
- Se saíssem sete vermelhos, seria razoável afirmar que a máquina está equilibrada? O que ainda não sabemos?
- Se a suspeita fosse «a máquina favorece uma das duas cores», que outros resultados teríamos de contar além dos excessos de vermelho?
Solução 1 — A Máquina dos Autocolantes
Nove ou mais vermelhos seriam mais surpreendentes sob o modelo equiprovável: cerca de 1.1% contra 17.2% para sete ou mais. Sete vermelhos também não demonstram equilíbrio. Observámos apenas dez autocolantes e é preciso considerar que desvios seriam detectáveis com tão pouca informação.
Se a suspeita inicial for de favorecimento de qualquer cor, temos de contar os resultados extremos nas duas direcções: sete ou mais vermelhos ou três ou menos vermelhos, e, para o outro limiar, nove ou mais ou um ou menos. Com a moeda equiprovável, as respectivas probabilidades bilaterais são aproximadamente 34.4% e 2.1%. A hipótese e a regra de contagem devem ser definidas antes de vermos qual a cor mais frequente.
-
Um Alarme de Incêndio. Dois alarmes foram comparados em simulações. Em 100 situações sem incêndio, o alarme A disparou por engano uma vez e o B seis vezes. Em 100 situações com incêndio, o A detectou 60 e o B detectou 95.
Alarmes falsos em 100 situações sem incêndio Incêndios detectados em 100 situações com incêndio Alarme A 1 60 Alarme B 6 95 - Qual dos alarmes deu menos falsos alarmes? Qual deixou escapar menos incêndios?
- Escolheriam necessariamente o mesmo alarme para todos os edifícios? Que custos e circunstâncias poderiam influenciar a escolha?
- Se pudessem definir a regra de disparo antes de uma nova simulação, que compromisso tentariam controlar? O que este caso vos ajuda a perceber sobre os erros de uma regra de decisão?
Solução 2 — O Alarme de Incêndio
A produz menos falsos alarmes (1 contra 6 em 100 situações sem incêndio). B detecta mais incêndios (95 contra 60 em 100), deixando escapar apenas 5 em vez de 40. Há um compromisso entre disparar facilmente e exigir evidência mais forte para disparar.
A escolha depende das consequências de um incêndio não detectado, do custo das evacuações, da frequência de incêndios e das condições do edifício. Antes da próxima simulação, definiríamos que riscos de falsos alarmes e de omissões são aceitáveis. Uma regra de decisão tem de ser avaliada pelos dois tipos de erro, não apenas pela percentagem de acertos.
-
Dois Resultados Sem Uma Diferença Clara. Dois estudos imaginários procuram saber se uma mudança de método altera a pontuação média. Ambos encontram uma diferença estimada de 0.2 pontos e nenhum rejeita a hipótese de diferença zero. Os intervalos de confiança de 95% calculados sob os respectivos modelos são:
Estudo Intervalo de confiança A -0.3 a 0.7 pontos B -7.8 a 8.2 pontos - O que têm em comum os dois resultados? Qual é mais preciso?
- Se uma diferença de 2 pontos já fosse importante, qual dos estudos permite afastar melhor diferenças dessa magnitude?
- Seria correcto escrever «provámos que não há qualquer efeito»? O que diriam em alternativa?
Solução 3 — Dois Intervalos
Os estudos estimam a mesma diferença, 0.2 pontos, e ambos incluem zero nos intervalos. O estudo A é muito mais preciso: o intervalo de -0.3 a 0.7 exclui diferenças de 2 pontos ou superiores em magnitude; o intervalo de -7.8 a 8.2 continua compatível com diferenças muito maiores.
Não escrevemos que a ausência de rejeição prova efeito zero. No estudo A, podemos afirmar que diferenças tão grandes como 2 pontos são incompatíveis com os valores cobertos pelo intervalo de confiança apresentado, sob o modelo usado. No B, a incerteza é demasiado grande para essa conclusão.
-
Um Teste Médico. Em 1000 pessoas, dez têm uma doença. Um teste identifica nove dessas dez, mas também dá positivo em 50 pessoas que não têm a doença.
- Quantas pessoas têm teste positivo? Entre essas pessoas, quantas têm realmente a doença?
- Saber que nove em cada dez pessoas doentes testam positivo responde à pergunta «se o meu teste for positivo, qual é a probabilidade de eu ter a doença»? Porquê?
- Se a doença fosse muito mais frequente na população, esperariam que a proporção de pessoas doentes entre os resultados positivos permanecesse igual? Expliquem a intuição, sem fazer novas contas.
Solução 4 — Um Teste Médico
Há \(9+50=59\) resultados positivos. Destes, apenas 9 são de pessoas com a doença. A proporção de pessoas doentes entre os positivos é \(9/59\approx 15.3\%\), neste exemplo.
Os nove acertos em dez doentes descrevem a sensibilidade: \(P(\text{positivo}\mid\text{doença})\). A pergunta de uma pessoa com resultado positivo é a condicional inversa, \(P(\text{doença}\mid\text{positivo})\). A frequência da doença também conta. Se a doença fosse mais frequente, mantendo-se as características do teste, esperaríamos uma proporção maior de casos reais entre os positivos.
Dos Resultados às Conclusões
-
Um Teste Que Podia Falhar. Uma investigação afirma que um programa melhorou a atenção. Os investigadores mediram apenas a satisfação dos participantes com o programa; não mediram atenção antes e depois. A maioria gostou do programa.
- A que pergunta respondem estes dados?
- Que observação seria capaz de pôr a afirmação sobre atenção realmente em dificuldades?
- Como relacionariam esta situação com a pergunta de Mayo sobre testes severos?
Solução 5 — Um Teste Que Podia Falhar
A medição informa-nos sobre satisfação com o programa. Não houve uma medição capaz de mostrar se a atenção melhorou. Uma avaliação da atenção antes e depois, com uma comparação adequada e uma tarefa que pudesse revelar ausência de melhoria, seria um começo.
Mayo pedir-nos-ia que explicássemos que erro a investigação estava em condições de detectar. Resultados favoráveis na satisfação não constituem um teste severo da alegação sobre atenção, porque seriam perfeitamente possíveis mesmo que a atenção não tivesse mudado.
-
A História de Duas Perguntas. Voltem ao exemplo da máquina. Um investigador quer saber quão invulgares são os dados sob o modelo de duas cores equiprováveis. Outro quer escolher, antes de observar novos autocolantes, uma regra que distinga a máquina equilibrada de máquinas com desvios relevantes.
- Que informação procura cada investigador?
- Porque é que os dois podem usar as mesmas probabilidades sem estar a fazer exactamente a mesma pergunta?
- O que acrescenta a pergunta sobre quais os desvios que o teste teria boas condições para detectar?
Solução 6 — Duas Perguntas
O primeiro investigador procura uma medida de discrepância dos dados relativamente ao modelo equiprovável, como uma probabilidade de cauda. O segundo precisa de uma regra de decisão definida antecipadamente e de conhecer o seu comportamento sob o modelo nulo e sob alternativas relevantes.
As mesmas probabilidades de resultados podem alimentar perguntas distintas. Acrescentar o poder obriga-nos a especificar que desvios queremos distinguir do equilíbrio. Uma regra que raramente assinala uma máquina equilibrada pode também deixar passar muitas máquinas enviesadas, sobretudo com apenas dez observações.
-
Voltar aos Peixes. Numa comparação hipotética, os peixes de água salgada observados têm maior comprimento médio, mas alguns são menores do que alguns dos peixes de água doce.
- Que afirmação sobre indivíduos foi contrariada? E que afirmação sobre médias continua em aberto?
- Que precisamos de saber sobre a selecção dos peixes, a medição e a incerteza antes de inferir uma diferença entre populações?
Solução 7 — Voltar aos Peixes
Foi contrariada a afirmação de que cada peixe de água salgada é maior do que cada peixe de água doce. Continua a ser possível que os comprimentos médios das populações sejam diferentes.
Para passar das médias observadas a uma inferência, precisamos de saber como foram escolhidos os peixes, se as medidas são comparáveis, se há agrupamentos relevantes (por exemplo, vários peixes do mesmo tanque) e qual a incerteza da diferença estimada. Uma diferença descritiva entre os peixes observados não determina sozinha o que acontece nas populações.
-
Conhecimento Anterior Sobre a Moeda. Temos informação de ensaios anteriores sobre uma moeda e fazemos mais dez lançamentos.
- Como poderia uma análise bayesiana representar a informação anterior e integrar os novos dados?
- Porque é que uma distribuição posterior e um valor-p respondem a perguntas diferentes?
- Que pergunta acrescentaria Mayo acerca da afirmação que queremos sustentar?
Solução 8 — Conhecimento Anterior
Uma análise bayesiana poderia representar a informação anterior numa distribuição prior para a probabilidade de cara e actualizá-la com os dez novos lançamentos. Por exemplo, um prior beta e uma verosimilhança binomial produzem uma distribuição posterior beta. A força do conhecimento anterior e a sua justificação afectam o resultado.
A posterior descreve a incerteza acerca do parâmetro dentro do modelo bayesiano escolhido. O valor-p descreve a probabilidade de resultados pelo menos tão extremos sob uma hipótese nula e uma regra de teste. Mayo perguntaria ainda quão bem o procedimento conseguiria detectar um erro relevante na afirmação sustentada pelo resultado observado.
Para Quem Quiser Explorar as Fontes
Estas perguntas exigem partes do capítulo que podem ser deixadas para uma leitura posterior. Não são pré-requisitos para os exercícios anteriores.
- Fisher, Neyman–Pearson e Mayo. Leiam as secções sobre as tradições, a controvérsia histórica e Mayo. Escolham uma diferença real entre as posições e uma aproximação possível. Identifiquem a fonte que sustenta cada interpretação, sem reduzir os autores a dois slogans opostos.
Solução 9 — Fisher, Neyman–Pearson e Mayo
Uma diferença importante está no papel atribuído ao resultado individual: em Fisher, a significância pode funcionar como indício de discrepância com a hipótese nula; em Neyman–Pearson, o planeamento de regras com propriedades de erro especificadas é central. Mayo procura ligar a evidência obtida a testes que teriam boas condições para descobrir erros concretos.
Há aproximações possíveis: todos precisam de considerar o que seria esperado sob hipóteses estatísticas e todos reconhecem alguma importância às propriedades dos testes. Uma boa resposta deve apoiar cada distinção nas fontes discutidas em Tradições da Inferência e História e Controvérsias, sem atribuir uma única filosofia indistintamente aos três.
- Poder e equivalência. Porque é que «80% de poder» exige especificar uma magnitude? Como se relaciona essa questão com a diferença entre não detectar um efeito e excluir efeitos cientificamente relevantes? Consultem poder e equivalência.
Solução 10 — Poder e Equivalência
Poder é uma função da magnitude verdadeira do efeito e de outras condições do estudo, incluindo tamanho amostral, variabilidade e regra de decisão. «80% de poder» fica incompleto enquanto não dissermos para detectar que efeito.
Não rejeitar diferença zero deixa em aberto efeitos que o estudo detectaria mal. Um teste de equivalência exige definir limites de diferença considerados irrelevantes e obter evidência suficiente para afastar diferenças fora desses limites. As duas perguntas são, portanto, distintas.
- Intervalos e reformas. Depois de lerem Intervalos e «Novas Estatísticas», expliquem uma vantagem de apresentar intervalos de confiança e um problema que a simples substituição do valor-p não resolve.
Solução 11 — Intervalos e Reformas
Um intervalo mostra uma gama de valores compatíveis com os dados sob o procedimento adoptado e ajuda a discutir magnitudes com relevância prática. A vantagem perde-se se o leitor o transformar noutra fronteira ritual, perguntando apenas se inclui zero.
Intervalos continuam dependentes do modelo, do delineamento e do procedimento de cobertura. Apresentá-los é útil, mas não resolve selecção de resultados, confundimento ou interpretações erradas da probabilidade.
- Outra interpretação da probabilidade. Como mudaria a pergunta se quiséssemos calcular probabilidades para modelos depois de observar os dados? Que papel poderia ter um prior? Consultem o Bayesianismo.
Solução 12 — Probabilidades Para Modelos
Para falar em probabilidades posteriores de hipóteses ou modelos é necessário especificar a sua probabilidade anterior e o modo como cada um prevê os dados. Bayes combina esses elementos com a evidência observada.
Assim, \(P(H\mid D)\) depende de \(P(D\mid H)\) e da distribuição anterior de probabilidades entre hipóteses. Um valor-p calculado sob uma hipótese nula não fornece, por si, a probabilidade posterior dessa hipótese.
12 Referências
Aldrich, J. (2000). Fisher’s “Inverse Probability” of 1930. International Statistical Review, 68(2), 155–172. https://doi.org/10.1111/j.1751-5823.2000.tb00319.x
Arbuthnot, J. (1710). An argument for Divine Providence, taken from the constant regularity observ’d in the births of both sexes. Philosophical Transactions, 27, 186–190. https://www.york.ac.uk/depts/maths/histstat/arbuthnot.htm
Bar-Hillel, M. (1979). The role of sample size in sample evaluation. Organizational Behavior and Human Performance, 24(2), 245–257. https://doi.org/10.1016/0030-5073(79)90028-X
Berger, J. O. (2003). Could Fisher, Jeffreys and Neyman have agreed on testing? Statistical Science, 18(1), 1–32. https://doi.org/10.1214/ss/1056397485
Berger, J. O. (2006). The case for objective Bayesian analysis. Bayesian Analysis, 1(3), 385–402. https://doi.org/10.1214/06-BA115
Berger, J. O., & Sellke, T. (1987). Testing a point null hypothesis: The irreconcilability of P values and evidence. Journal of the American Statistical Association, 82(397), 112–122. https://doi.org/10.1080/01621459.1987.10478397
Bernardo, J. M. (1979). Reference posterior distributions for Bayesian inference. Journal of the Royal Statistical Society: Series B, 41(2), 113–147. https://doi.org/10.1111/j.2517-6161.1979.tb01066.x
Chandrashekar, S. P., Cheng, Y. H., Fong, C. L., Leung, Y. C., Wong, Y. T., Cheng, B. L., & Feldman, G. (2021). Frequency estimation and semantic ambiguity do not eliminate conjunction bias, when it occurs: Replication and extension of Mellers, Hertwig, and Kahneman (2001). Meta-Psychology, 5. https://doi.org/10.15626/MP.2020.2474
Cowles, M., & Davis, C. (1982). On the origins of the .05 level of statistical significance. American Psychologist, 37(5), 553–558. https://doi.org/10.1037/0003-066X.37.5.553
Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
Dienes, Z. (2008). Understanding psychology as a science: An introduction to scientific and statistical inference. Palgrave Macmillan. https://www.bloomsbury.com/us/understanding-psychology-as-a-science-9780230542310/
D’Amelio, A. (2009). Undergraduate student difficulties with independent and mutually exclusive events concepts. The Mathematics Enthusiast, 6(1), 47–56. https://doi.org/10.54870/1551-3440.1133
Falk, R. (2015). Numbers defy the law of large numbers. Teaching Statistics, 37(2), 54–60. https://doi.org/10.1111/test.12031
Farmer, G. D., Warren, P. A., & Hahn, U. (2017). Who “believes” in the gambler’s fallacy and why? Journal of Experimental Psychology: General, 146(1), 63–76. https://doi.org/10.1037/xge0000245
Feynman, R. P. (1974). Cargo cult science. Engineering and Science, 37(7), 10–13. https://resolver.caltech.edu/CaltechES:37.7.CargoCult
Fisher, R. A. (1925). Statistical methods for research workers. Oliver & Boyd. https://psychclassics.yorku.ca/Fisher/Methods/
Fisher, R. A. (1926). The arrangement of field experiments. Journal of the Ministry of Agriculture of Great Britain, 33, 503–513. https://digital.library.adelaide.edu.au/dspace/handle/2440/15191
Fisher, R. A. (1955). Statistical methods and scientific induction. Journal of the Royal Statistical Society: Series B, 17(1), 69–78. https://doi.org/10.1111/j.2517-6161.1955.tb00180.x
García-Pérez, M. A. (2017). Thou shalt not bear false witness against null hypothesis significance testing. Educational and Psychological Measurement, 77(4), 631–662. https://doi.org/10.1177/0013164416668232
Gelman, A., & Higgs, M. (2025). Interrogating the “cargo cult science” metaphor. Theory and Society. https://doi.org/10.1007/s11186-025-09614-6
Gelman, A., Jakulin, A., Pittau, M. G., & Su, Y.-S. (2008). A weakly informative default prior distribution for logistic and other regression models. The Annals of Applied Statistics, 2(4), 1360–1383. https://doi.org/10.1214/08-AOAS191
Gelman, A., & Shalizi, C. R. (2013). Philosophy and the practice of Bayesian statistics. British Journal of Mathematical and Statistical Psychology, 66(1), 8–38. https://doi.org/10.1111/j.2044-8317.2011.02037.x
Gigerenzer, G., & Hoffrage, U. (1995). How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704. https://doi.org/10.1037/0033-295X.102.4.684
Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
Hermann, E. (2004). Dissolving the self-other dichotomy in Western “cargo cult” constructions. In H. Jebens (Ed.), Cargo, cult, and culture critique (pp. 36–58). University of Hawai’i Press. https://doi.org/10.1515/9780824840440-004
Hájek, A. (2023). Interpretations of probability. Stanford Encyclopedia of Philosophy. https://plato.stanford.edu/entries/probability-interpret/
Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3
Hubbard, R., & Bayarri, M. J. (2003). Confusion over measures of evidence (\(p\)’s) versus errors (\(\alpha\)’s) in classical statistical testing. The American Statistician, 57(3), 171–178. https://doi.org/10.1198/0003130031856
Kennedy-Shaffer, L. (2019). Before \(p<0.05\) to beyond \(p<0.05\): Using history to contextualize p-values and significance testing. The American Statistician, 73(sup1), 82–90. https://doi.org/10.1080/00031305.2018.1537891
Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. https://doi.org/10.1525/collabra.33267
Lakens, D., Adolfi, F. G., Albers, C. J., et al. (2018). Justify your alpha. Nature Human Behaviour, 2, 168–171. https://doi.org/10.1038/s41562-018-0311-x
Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
Lehmann, E. L. (2011). Fisher, Neyman, and the creation of classical statistics. Springer. https://doi.org/10.1007/978-1-4419-9500-1
Lindstrom, L. (1993). Cargo cult culture: Toward a genealogy of Melanesian kastom. Anthropological Forum, 6(4), 495–513. https://doi.org/10.1080/00664677.1993.9967429
Maier, M., & Lakens, D. (2022). Justify your alpha: A primer on two practical approaches. Advances in Methods and Practices in Psychological Science, 5(2). https://doi.org/10.1177/25152459221080396
Mayo, D. G. (1981). In defense of the Neyman-Pearson theory of confidence intervals. Philosophy of Science, 48(2), 269–280. https://doi.org/10.1086/288996
Mayo, D. G. (1991). Novel evidence and severe tests. Philosophy of Science, 58(4), 523–552. https://doi.org/10.1086/289639
Mayo, D. G. (1992). Did Pearson reject the Neyman-Pearson philosophy of statistics? Synthese, 90(2), 233–262. https://doi.org/10.1007/BF00485352
Mayo, D. G. (1997). Error statistics and learning from error: Making a virtue of necessity. Philosophy of Science, 64, S195–S212. https://doi.org/10.1086/392600
Mayo, D. G. (2013). The error-statistical philosophy and the practice of Bayesian statistics: Comments on Gelman and Shalizi. British Journal of Mathematical and Statistical Psychology, 66(1), 57–64. https://doi.org/10.1111/j.2044-8317.2012.02064.x
Mayo, D. G. (2018). Statistical inference as severe testing: How to get beyond the statistics wars. Cambridge University Press. https://doi.org/10.1017/9781107286184
Mayo, D. G., & Spanos, A. (2006). Severe testing as a basic concept in a Neyman–Pearson philosophy of induction. The British Journal for the Philosophy of Science, 57(2), 323–357. https://doi.org/10.1093/bjps/axl003
McDowell, M., & Jacobs, P. (2017). Meta-analysis of the effect of natural frequencies on Bayesian reasoning. Psychological Bulletin, 143(12), 1273–1312. https://doi.org/10.1037/bul0000126
McDowell, N. (1988). A note on cargo cults and cultural constructions of change. Pacific Studies, 11(2), 121–134. https://digitalcollections.byuh.edu/pacific-studies-journal/vol11/iss2/9/
Mellers, B., Hertwig, R., & Kahneman, D. (2001). Do frequency representations eliminate conjunction effects? An exercise in adversarial collaboration. Psychological Science, 12(4), 269–275. https://doi.org/10.1111/1467-9280.00350
Miller, J., & Ulrich, R. (2016). Interpreting confidence intervals: A comment on Hoekstra, Morey, Rouder, and Wagenmakers (2014). Psychonomic Bulletin & Review, 23(1), 124–130. https://doi.org/10.3758/s13423-015-0859-7
Morey, R. D., Hoekstra, R., Rouder, J. N., Lee, M. D., & Wagenmakers, E.-J. (2016). The fallacy of placing confidence in confidence intervals. Psychonomic Bulletin & Review, 23(1), 103–123. https://doi.org/10.3758/s13423-015-0947-8
Morsanyi, K., Primi, C., Chiesi, F., & Handley, S. (2009). The effects and side-effects of statistics education: Psychology students’ (mis-)conceptions of probability. Contemporary Educational Psychology, 34(3), 210–220. https://doi.org/10.1016/j.cedpsych.2009.05.001
Neyman, J. (1956). Note on an article by Sir Ronald Fisher. Journal of the Royal Statistical Society: Series B, 18(2), 288–294. https://doi.org/10.1111/j.2517-6161.1956.tb00236.x
Neyman, J., & Pearson, E. S. (1928a). On the use and interpretation of certain test criteria for purposes of statistical inference: Part I. Biometrika, 20A(1/2), 175–240. https://doi.org/10.1093/biomet/20A.1-2.175
Neyman, J., & Pearson, E. S. (1928b). On the use and interpretation of certain test criteria for purposes of statistical inference: Part II. Biometrika, 20A(3/4), 263–294. https://doi.org/10.1093/biomet/20A.3-4.263
Neyman, J., & Pearson, E. S. (1933a). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
Neyman, J., & Pearson, E. S. (1933b). The testing of statistical hypotheses in relation to probabilities a priori. Proceedings of the Cambridge Philosophical Society, 29(4), 492–510. https://doi.org/10.1017/S030500410001152X
Otto, T. (2009). What happened to cargo cults? Material religions in Melanesia and the West. Social Analysis, 53(1), 82–102. https://doi.org/10.3167/sa.2009.530106
Pearson, E. S. (1955). Statistical concepts in their relation to reality. Journal of the Royal Statistical Society: Series B, 17(2), 204–207. https://doi.org/10.1111/j.2517-6161.1955.tb00194.x
Perezgonzalez, J. D. (2014). A reconceptualization of significance testing. Theory & Psychology, 24(6), 852–859. https://doi.org/10.1177/0959354314546157
Perezgonzalez, J. D. (2015). Confidence intervals and tests are two sides of the same research question. Frontiers in Psychology, 6, 34. https://doi.org/10.3389/fpsyg.2015.00034
Romeijn, J.-W. (2025). Philosophy of statistics. Stanford Encyclopedia of Philosophy. https://plato.stanford.edu/entries/statistics/
Sabbaghi, A., & Rubin, D. B. (2014). Comments on the Neyman–Fisher controversy and its consequences. Statistical Science, 29(2), 267–284. https://doi.org/10.1214/13-STS454
Sellke, T., Bayarri, M. J., & Berger, J. O. (2001). Calibration of p values for testing precise null hypotheses. The American Statistician, 55(1), 62–71. https://doi.org/10.1198/000313001300339950
Senn, S. J. (2008a). A century of t-tests. Significance, 5(1), 37–39. https://doi.org/10.1111/j.1740-9713.2008.00279.x
Senn, S. J. (2008b). The t-test tool. Significance, 5(1), 40–41. https://doi.org/10.1111/j.1740-9713.2008.00280.x
Senn, S. J., & Richardson, W. (1994). The first t-test. Statistics in Medicine, 13(8), 785–803. https://doi.org/10.1002/sim.4780130802
Stark, P. B., & Saltelli, A. (2018). Cargo-cult statistics and scientific crisis. Significance, 15(4), 40–43. https://doi.org/10.1111/j.1740-9713.2018.01174.x
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Stengård, E., Juslin, P., Hahn, U., & van den Berg, R. (2022). On the generality and cognitive basis of base-rate neglect. Cognition, 226, 105160. https://doi.org/10.1016/j.cognition.2022.105160
Szollosi, A., & Newell, B. R. (2020). People as intuitive scientists: Reconsidering statistical explanations of decision making. Trends in Cognitive Sciences, 24(12), 1008–1018. https://doi.org/10.1016/j.tics.2020.09.005
Thompson, W. C., & Schumann, E. L. (1987). Interpretation of statistical evidence in criminal trials: The prosecutor’s fallacy and the defense attorney’s fallacy. Law and Human Behavior, 11(3), 167–187. https://doi.org/10.1007/BF01044641
Tversky, A., & Kahneman, D. (1971). Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110. https://doi.org/10.1037/h0031322
Tversky, A., & Kahneman, D. (1973). Availability: A heuristic for judging frequency and probability. Cognitive Psychology, 5(2), 207–232. https://doi.org/10.1016/0010-0285(73)90033-9
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
Tversky, A., & Kahneman, D. (1983). Extensional versus intuitive reasoning: The conjunction fallacy in probability judgment. Psychological Review, 90(4), 293–315. https://doi.org/10.1037/0033-295X.90.4.293
van Doorn, J., van den Bergh, D., Böhm, U., Dablander, F., Derks, K., Draws, T., et al. (2021). The JASP guidelines for conducting and reporting a Bayesian analysis. Psychonomic Bulletin & Review, 28, 813–826. https://doi.org/10.3758/s13423-020-01798-5
Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
Weingarten, E., & Hutchinson, J. W. (2018). Does ease mediate the ease-of-retrieval effect? A meta-analysis. Psychological Bulletin, 144(3), 227–283. https://doi.org/10.1037/bul0000122
Xiang, Y., Dorst, K., & Gershman, S. J. (2025). On the robustness and provenance of the gambler’s fallacy. Psychological Science, 36(6), 451–464. https://doi.org/10.1177/09567976251344570
Zabell, S. L. (2008). On Student’s 1908 article “The Probable Error of a Mean”. Journal of the American Statistical Association, 103(481), 1–7. https://doi.org/10.1198/016214508000000030