Estatística Descritiva
0 Descrever Sem Apagar a Pergunta
Uma tabela com centenas de linhas não se lê de uma vez. A estatística descritiva transforma as observações em representações mais manejáveis — números, tabelas e gráficos — que mostram o que foi medido, onde se concentram os valores, como variam e que padrões aparecem nos dados.
Esta é uma página conceptual. Para calcular estas quantidades no R, consulte o tutorial de descritivas. Para construir e adaptar gráficos, consulte Gráficos no R. Aqui interessa sobretudo escolher uma descrição que não substitua os dados por uma caricatura bem penteada.
Ver Uma Distribuição
Uma variável varia. Podemos olhar para uma observação de cada vez ou perguntar como os seus valores se distribuem.
Imaginem que contamos o número de faltas de dez estudantes num certo período. Em vez de mostrar dez linhas de uma tabela, podemos organizar as contagens:
| Faltas | Estudantes | Uma marca por estudante |
|---|---|---|
| 0 | 3 | ● ● ● |
| 1 | 4 | ● ● ● ● |
| 2 | 2 | ● ● |
| 4 | 1 | ● |
Esta é uma distribuição dos valores observados. Vemos que o valor mais frequente é uma falta, que sete dos dez estudantes tiveram no máximo uma falta e que uma pessoa teve quatro. Uma média única não mostraria tudo isto.
A mesma distribuição convida a perguntas diferentes. Qual é o valor mais frequente? Qual fica a meio quando ordenamos os estudantes? Qual é a diferença entre os extremos? Em que ponto já encontrámos 75% das observações? E se, em vez de faltas, tivéssemos tempos de reacção, com centenas de valores diferentes? É para responder a estas perguntas que introduzimos moda, mediana, quantis, média, dispersão e forma nas secções seguintes.
O gráfico é frequentemente o melhor primeiro olhar. Para contagens pequenas, uma barra por valor pode chegar. Para muitas medições quantitativas, podemos agrupar valores num histograma ou mostrar uma densidade estimada. Os Gráficos no R ensinam a construí-los.
Quando a Distribuição Representa Probabilidades
Também podemos usar uma distribuição para representar o que um processo poderia produzir, antes de sabermos o resultado. Nesse caso especificamos um modelo probabilístico.
Se lançarmos um dado justo, cada uma das seis faces tem probabilidade \(1/6\). Obter 1 ou 2 tem probabilidade \(2/6\): somamos as probabilidades dos resultados que nos interessam. Se contarmos quantas vezes sai 6 em dez lançamentos independentes, já não estamos a descrever uma só face. A distribuição binomial atribui probabilidades às várias contagens possíveis, de zero a dez.
Convém distinguir o que vimos:
| Distribuição observada | Distribuição de probabilidade | |
|---|---|---|
| Pergunta | Como se distribuíram estes dados? | Que resultados admite este modelo e com que probabilidades? |
| Exemplo | Três estudantes tiveram zero faltas. | Num dado justo, cada face tem probabilidade \(1/6\). |
| O que fazemos? | Contamos, desenhamos, resumimos. | Atribuímos probabilidades e calculamos somas ou áreas. |
Uma distribuição matemática é um modelo idealizado: especifica os resultados possíveis e a probabilidade que atribuímos a cada um. Já uma distribuição observada descreve os valores que efectivamente recolhemos. O modelo pode aproximar-se muito do padrão observado ou falhar de maneiras importantes. A amostragem, a medição e o delineamento influenciam essa comparação.
Algumas famílias matemáticas têm uma ligação particularmente clara com processos concretos. A binomial resulta quando contamos sucessos num número fixo de tentativas independentes, todas com a mesma probabilidade de sucesso. Não é uma curva desenhada por conveniência: a estrutura do processo permite deduzir a distribuição. Se aquelas condições falharem, a binomial pode deixar de ser um modelo adequado.
A normal é outro caso importante. Muitas distribuições empíricas aproximam-se de uma forma de sino, e uma normal pode ser uma aproximação útil para certas medidas. Uma razão matemática para o seu aparecimento é que a soma de muitos contributos pequenos, suficientemente independentes e sem que uns poucos dominem os restantes, pode aproximar-se de uma normal. É uma intuição ligada a resultados como o Teorema do Limite Central, mas a existência de muitos factores, por si só, não garante normalidade. Tempos de reacção, rendimentos e contagens, por exemplo, podem ter formas assimétricas.
Também convém distinguir a distribuição dos valores individuais da distribuição das médias de muitas amostras: a segunda pode aproximar-se de uma normal mesmo quando a primeira não é normal, dadas as condições apropriadas. Voltaremos a este ponto no capítulo de inferência.
Barras, Curvas e Áreas
Pensem nas figuras da geometria. Podemos definir matematicamente um rectângulo ou um círculo, desenhá-lo e calcular a sua área. Não precisamos de encontrar um círculo perfeito na natureza para trabalhar com as suas propriedades.
Fazemos algo semelhante com uma distribuição de probabilidade: uma função matemática define-a, podemos desenhá-la e sabemos como calcular as probabilidades que atribui aos resultados. Nos casos contínuos, calculamos áreas debaixo de uma curva. A área total vale sempre 1, isto é, 100% da probabilidade. Nos casos discretos, a função atribui uma probabilidade a cada valor possível e somamos os valores correspondentes.
Com resultados discretos, como o número de caras em dez lançamentos, cada barra representa a probabilidade de um valor possível. Para reunir vários resultados, somamos as probabilidades dessas barras. Com uma variável contínua, como um tempo idealizado medido com precisão arbitrária, usamos uma densidade. A altura da curva é uma densidade, não a probabilidade de observar um valor exacto. A probabilidade é a área debaixo da curva num intervalo. Uma densidade pode até ter altura superior a 1; a área total é que tem de ser 1.
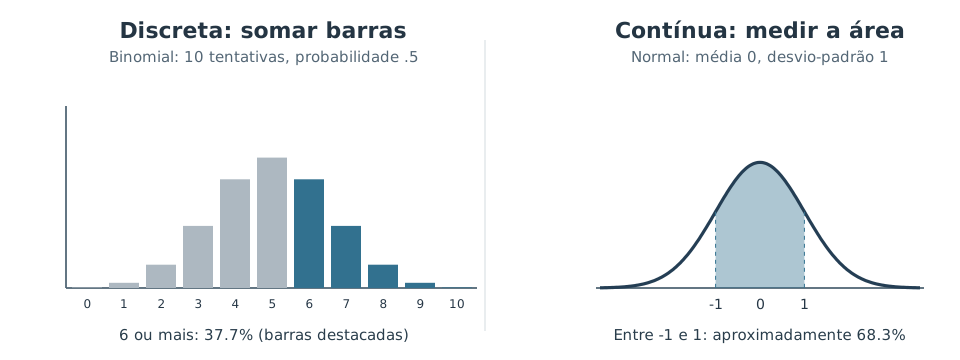
A distribuição binomial da esquerda atribui probabilidade a cada contagem possível, de zero a dez. As barras destacadas somam 37.7%. Na normal da direita, a área sombreada representa uma probabilidade de aproximadamente 68.3%. Nos dois casos, escolhemos que resultados nos interessam e calculamos a probabilidade que lhes corresponde.
Pensem numa distribuição normal centrada em zero, com desvio-padrão igual a um, frequentemente representada pela letra \(Z\). A curva tem maior altura perto de zero e duas caudas que se vão aproximando do eixo horizontal. A área debaixo da curva inteira é 1, isto é, 100% da probabilidade:
- Entre -1 e 1: aproximadamente 68.3% da área.
- À esquerda de -1: aproximadamente 15.9%.
- À direita de 1: aproximadamente 15.9%.
Se quisermos a probabilidade de ficar abaixo de um ponto, acumulamos a área desde a esquerda até esse ponto. Se quisermos a probabilidade de ficar acima, contamos a área à direita. Para um intervalo entre dois pontos, contamos apenas a área entre eles.
As caudas da normal estendem-se indefinidamente. Escrevemos \(-\infty\) e \(+\infty\) para indicar que a curva não tem um limite finito à esquerda ou à direita. Não são dois valores que alguém possa observar ou duas probabilidades adicionais: indicam apenas os limites da área que estamos a considerar.
Quando as Barras Parecem Uma Curva
A diferença entre valores discretos e contínuos é importante, mas não cria duas matemáticas sem relação.
Pensem novamente no número de caras numa moeda justa. Em dez lançamentos, só temos onze contagens possíveis, de zero a dez: as barras ficam bem separadas. Em mil lançamentos, há 1001 contagens possíveis. Perto das 500 caras, as probabilidades individuais variam suavemente e o conjunto de barras parece uma curva. Podemos então aproximar a binomial por uma distribuição normal e usar áreas para estimar probabilidades. Para uma moeda justa e muitos lançamentos, essa aproximação costuma funcionar muito bem na parte central da distribuição.
O resultado continua a ser uma contagem inteira: 500 caras são possíveis, 500.5 caras não. A curva é uma aproximação conveniente, não uma mudança de natureza da variável. Além disso, ter muitos valores possíveis não chega: algumas distribuições discretas são muito assimétricas, têm picos separados ou concentram quase toda a probabilidade em poucos resultados. A qualidade da aproximação depende também da forma e da região que queremos estudar, especialmente nas caudas.
Para aproximar, com uma curva contínua, a probabilidade de um valor inteiro específico, pode ser útil medir a área entre o ponto médio anterior e o seguinte. Por exemplo, uma aproximação normal a \(P(X=500)\) usa a área entre 499.5 e 500.5. Chama-se correcção de continuidade. É sobretudo uma maneira de fazer corresponder a área de um intervalo contínuo à probabilidade de uma barra discreta. A aproximação continua sujeita às suas condições.
Para uma variável discreta, se \(q(k)\) é a probabilidade de cada resultado \(k\), somamos os resultados que pertencem ao conjunto que nos interessa:
\[ P(X\in A)=\sum_{k\in A}q(k). \]
Para uma variável contínua com densidade \(f(x)\), a soma passa a ser uma integral. Por exemplo:
\[ P(a\leq X\leq b)=\int_a^b f(x)\,dx, \qquad P(X\leq a)=\int_{-\infty}^{a}f(x)\,dx. \]
A área à direita de \(a\) é \(\int_a^{+\infty} f(x)\,dx\). Todas as áreas somam 1. Como a área de um ponto sem largura é zero, numa distribuição contínua \(P(X=a)=0\), mesmo que \(f(a)\) seja positiva. Isto não significa que o valor \(a\) seja impossível.
Uma função de distribuição acumulada, \(F(a)=P(X\leq a)\), reúne as probabilidades à esquerda de cada ponto. Em variáveis contínuas, \(P(X>a)=1-F(a)\). Para contagens discretas, precisamos de prestar atenção à inclusão do valor do limite.
Sabemos calcular a área. O que nos permite dizer sobre um resultado? A moeda da Filosofia da Estatística é um primeiro exemplo para pensar sobre evidência, decisão e erro. Para acompanhar as contas, os Fundamentos da Inferência mostram como o valor-p ganha uma interpretação geométrica.
Poderá ter aprendido que cada escala de medida traz uma receita fixa de estatísticas e gráficos. Aqui preferimos começar pela pergunta, pelo processo de medição e pelos dados observados, porque a mesma receita pode ocultar assimetria, subgrupos, valores em falta ou observações influentes. As categorias tradicionais continuam úteis como vocabulário e ponto de partida, não como um piloto automático.
Antes de Calcular: Quatro Perguntas
Uma descrição começa antes da fórmula. Primeiro precisamos de saber o que é uma observação e que característica dos dados queremos tornar visível.
- Que unidade é uma observação: pessoa, ensaio, ninho, dia ou medição repetida?
- Há valores em falta, códigos impossíveis, limites de detecção ou arredondamento?
- Um único centro e uma única dispersão esconderiam grupos relevantes?
- Que comparação responde à pergunta substantiva, e que variação precisa de ficar visível?
Ao longo do capítulo vamos voltar a quatro perguntas simples:
| Pergunta | Exemplos de descrições |
|---|---|
| Com que frequência? | contagens, proporções, frequências acumuladas |
| Onde estão os valores? | moda, mediana, quantis, média |
| Quanto variam? | amplitude, AIQ, desvios, variância, desvio-padrão |
| Que forma ou relação têm? | assimetria, caudas, picos, gráficos |
Esta tabela é um mapa, não uma receita. A mesma base de dados pode exigir várias destas descrições. Cada sumário preserva uma característica e deixa outras de fora.
Limites das Descritivas
Um sumário reduz informação deliberadamente. A média da idade, por exemplo, localiza um centro aritmético, mas não mostra se há dois grupos etários, se uma idade extrema o desloca ou quantas idades estão em falta. Por isso, numa boa descrição indicamos normalmente o número de observações e de valores em falta, resumimos a localização e a dispersão e mostramos a distribuição ou a relação relevante num gráfico.
Também importa distinguir a variável das suas observações. Contar as respostas a uma pergunta nominal pode ser apropriado. Fazer a média de códigos arbitrários como 1 = azul e 2 = verde não cria uma medida de cor. A escala ajuda a delimitar operações sensatas, mas o significado dos valores, o delineamento do estudo e a finalidade da comparação continuam a decidir o que vale a pena mostrar.
A distinção clássica entre escalas nominais, ordinais, de intervalo e de razão está resumida em Medição e Evidência. Vale a pena conhecer a regra que costuma acompanhar essa classificação: frequências e moda para categorias, mediana e quantis quando há ordem, média e desvio-padrão quando as diferenças numéricas têm significado. Ao longo desta página vamos usar exemplos para perceber o que cada operação pressupõe e que informação nos dá.
Por exemplo, podemos ordenar «baixo», «moderado» e «alto». Isso não garante que a distância entre os dois primeiros níveis seja igual à distância entre os dois últimos. Codificá-los como 1, 2 e 3 ou como 1, 2 e 10 mantém a ordem, mas altera a média e o desvio-padrão. Para interpretar esses dois sumários, precisamos de saber o que representam as diferenças entre os valores.
Quatro Perguntas Para Descrever Dados
Frequências e Proporções
Comecemos por contar. Num exemplo inventado, dez respostas válidas distribuem-se por «baixo», «moderado» e «alto»: 2, 5 e 3 respostas. Estas contagens são as frequências absolutas. Se as dividirmos pelo total de dez, obtemos as frequências relativas: .20, .50 e .30. Multiplicando por 100, temos 20%, 50% e 30%.
Na notação habitual, \(n_i\) é a contagem da categoria \(i\) e \(n\) o total de observações usadas. A frequência relativa é \(f_i=n_i/n\). Ao apresentar percentagens, indique esse total: aqui descrevemos as dez respostas válidas. Se houve participantes que não responderam, convém indicar também quantos foram.
Podemos ainda perguntar quantas respostas ficam até um determinado nível. As frequências acumuladas somam as frequências até à categoria escolhida, incluindo-a. No exemplo, as contagens acumuladas são 2, 7 e 10, e as proporções acumuladas são .20, .70 e 1. Assim, 70% das respostas estão no nível «moderado» ou abaixo dele.
Escrevemos estas somas como
\[N_i=\sum_{j=1}^{i}n_j,\qquad F_i=\sum_{j=1}^{i}f_j=\frac{N_i}{n}.\]
O índice \(j\) percorre as categorias da primeira até à categoria \(i\). O símbolo \(\sum\) indica que somamos as suas frequências, sempre com o mesmo denominador \(n\).
Esta acumulação faz sentido quando as categorias têm uma ordem substantiva, como neste exemplo. Para categorias nominais, uma acumulação depende apenas da ordem arbitrária escolhida para as linhas e raramente informa.
Centro e Localização
As três medidas mais conhecidas de tendência central respondem a perguntas diferentes: qual o valor mais frequente, qual o valor central na ordenação e qual o centro aritmético? Vamos calculá-las e ver porque podem dar resultados diferentes. O NIST/SEMATECH apresenta estas definições em Measures of Location.
Moda
A moda é a categoria ou valor com a maior frequência. Por exemplo, se numa pequena amostra aparecem «calças largas, calças justas, calças justas, saia, calças justas», a moda é «calças justas»: aparece três vezes. Para a encontrar, basta contar as ocorrências de cada valor ou categoria.
Se dois valores partilham a maior frequência, ambos são modas; se mais de dois a partilham, temos várias modas. Também usamos os termos unimodal, bimodal e multimodal para descrever distribuições com um, dois ou vários picos. Voltaremos a esses picos quando olharmos para os gráficos.
Há duas operações com o mesmo nome. Na moda por frequência, contamos valores observados e escolhemos o que aparece mais vezes. Isto funciona directamente para categorias e dados discretos. Em medições contínuas, o resultado depende da precisão e do arredondamento. Podemos ter muitas observações diferentes concentradas perto de 10 e apenas duas observações exactamente iguais a 12.40; a contagem dos valores exactos escolheria 12.40, embora a maior concentração esteja perto de 10.
A moda de uma distribuição contínua é a localização do pico da sua função de densidade. Se a densidade for \(f(x)\), procuramos o valor de \(x\) em que \(f(x)\) atinge o máximo. Com dados observados, uma estratégia comum é estimar a densidade por kernel (KDE) e procurar onde a densidade estimada atinge o máximo. A largura de banda controla a suavização e pode juntar ou separar picos.
Muitas funções de software chamadas mode não fazem esta estimação. Algumas limitam-se a contar valores exactos; outras usam a palavra mode para outra propriedade do objecto. Para dados contínuos, convém verificar qual destas operações está realmente a ser feita.
Mediana e Quantis
A mediana ocupa o meio das observações ordenadas. Para a encontrar, começamos por pôr os valores por ordem crescente. Depois contamos quantos valores temos: se o número for ímpar, há uma observação no meio; se for par, há duas observações centrais e a regra numérica habitual é fazer a sua média.
Nos comprimentos inventados 8, 9, 10, 11 e 12 cm, o terceiro valor é o central: a mediana é 10 cm. Com 8, 9, 11 e 12 cm, os dois valores centrais são 9 e 11. Fazemos a sua média, \((9+11)/2=10\) cm. Neste caso, a mediana fica entre duas observações.
A ideia importante é a posição: primeiro ordenamos, depois encontramos o meio. A definição formal fica na nota seguinte.
A fórmula reúne estas duas situações. Escrevemos os valores ordenados como \(x_{(1)} \leq x_{(2)} \leq \cdots \leq x_{(n)}\), onde \(n\) é o número de observações. Os índices entre parênteses indicam a posição depois de ordenar. Assim,
\[ \tilde{x} = \begin{cases} x_{((n+1)/2)}, & \text{se } n \text{ é ímpar},\\[4pt] \dfrac{x_{(n/2)} + x_{(n/2+1)}}{2}, & \text{se } n \text{ é par}. \end{cases} \]
Podemos confirmar a fórmula nos exemplos: para cinco valores, \((n+1)/2=3\); para quatro, \(n/2=2\) e \(n/2+1=3\). Primeiro encontramos as posições centrais, depois lemos os valores que lá estão.
A mediana também nos permite localizar o centro de categorias ordenadas, como níveis de concordância. Se as duas observações centrais pertencerem a categorias diferentes, há várias convenções de apresentação, explicadas na nota seguinte.
Quando as respostas estão codificadas numericamente, também se usa a média dos dois códigos centrais para apresentar a mediana. Com os códigos centrais 2 e 3, esta regra dá 2.5. Podemos, por isso, encontrar uma mediana decimal no resumo de respostas ordinais, mesmo quando as opções de resposta são números inteiros.
A objecção da teoria da medição diz respeito ao significado desse ponto intermédio. Se 2 e 3 representam «moderado» e «alto», a ordem permite localizar as duas categorias centrais. Para interpretar 2.5 como uma posição a igual distância de ambas, precisamos também de uma interpretação das distâncias entre códigos. Outra codificação que preserve a ordem pode mudar esse ponto intermédio. Osherson e Lane discutem esta questão das distâncias e o debate sobre operações aritméticas com escalas ordinais em Levels of Measurement.
Na apresentação dos resultados, podemos indicar as duas categorias centrais, escolher a inferior ou a superior por uma convenção explícita, ou reportar o ponto médio dos códigos, deixando clara a codificação usada. Quando ambas as observações centrais pertencem à mesma categoria, estas escolhas coincidem. Com pontuações interpretadas como aproximadamente intervalares, a justificação para usar o ponto médio depende dessa interpretação da medida.
Os quantis generalizam a ideia de posição numa distribuição. Os quartis \(Q_1\), \(Q_2\) e \(Q_3\) correspondem aos quantis de .25, .50 e .75; \(Q_2\) é a mediana. Os percentis usam a mesma ideia numa escala de 0 a 100: o percentil 90 corresponde ao quantil .90. Estes pontos ajudam-nos a localizar os valores mais baixos, o centro e os valores mais altos da distribuição.
A definição de mediana admite valores repetidos: pelo menos metade das observações é menor ou igual à mediana e pelo menos metade é maior ou igual a ela. Pode, portanto, haver muitas observações iguais ao valor central.
Em amostras finitas há várias convenções de interpolação dos quantis. Dois programas podem dar quartis ligeiramente diferentes. Quando há valores repetidos nos pontos de corte, os quatro grupos também podem ter tamanhos diferentes.
Média e Robustez
A média amostral soma os valores e divide pelo número de observações:
\[\bar{x} = \frac{1}{n}\sum_{i=1}^{n}x_i.\]
Aqui, \(x_i\) é o valor da observação \(i\), \(n\) é o número de observações usadas e \(\sum\) pede que somemos todos os valores. É o centro de massa dos valores quantitativos: cada valor, incluindo os extremos, contribui para ela.
Voltemos aos comprimentos inventados 8, 9, 10, 11 e 12 cm. A média é \(50/5=10\) cm, igual à mediana. Se substituirmos apenas 12 por 32 cm, a média passa a \(70/5=14\) cm, mas a mediana continua em 10 cm. Se aumentarmos ainda mais o último valor, a média continua a subir; a mediana mantém-se enquanto a ordenação central não mudar. É neste sentido que a mediana é mais robusta a valores extremos: um valor muito afastado não a arrasta como arrasta a média. A mediana acompanha sobretudo o que acontece às posições centrais; para a deslocar, teremos de alterar os valores que as ocupam.
Qual das duas nos interessa? Para descrever um espécime no meio da ordenação, a mediana responde directamente à pergunta. Se queremos conhecer o comprimento total dos cinco espécimes, podemos recuperá-lo multiplicando a média por cinco. Nesse total, o espécime maior tem de contribuir com todo o seu comprimento. A escolha depende do aspecto que queremos descrever. Muitas vezes vale a pena mostrar as duas medidas, acompanhadas de dispersão e de um gráfico.
Um valor muito afastado dos restantes merece ser verificado. Se resultar de um erro de registo, precisamos de o corrigir. Se for válido, faz parte do fenómeno que estamos a estudar e pode ser importante para a pergunta de investigação. A página de Estatística Robusta desenvolve as opções para resumir os dados e avaliar a influência destas observações.
Dispersão
Saber onde fica o centro não basta para saber quanto variam os valores. Os conjuntos inventados 9, 10 e 11 cm e 2, 10 e 18 cm têm a mesma média e a mesma mediana, mas a dispersão é muito diferente. Podemos descrevê-la por distâncias entre pontos da distribuição ou por distâncias de cada observação a um centro.
Amplitudes
A amplitude total é \(\max(x)-\min(x)\): a distância entre o maior e o menor valor. Nos dois conjuntos anteriores é 2 cm e 16 cm. É simples, mas usa apenas os extremos; uma única observação muito afastada pode alterá-la bastante.
A amplitude interquartil (AIQ) é \(Q_3-Q_1\): a largura do intervalo entre o primeiro e o terceiro quartis, habitualmente descrito como os 50% centrais. Ao não usar directamente os extremos, é menos sensível a eles do que a amplitude total. As duas amplitudes ficam nas unidades da variável: se medimos comprimentos em cm, estas larguras também se expressam em cm.
Para dados apenas ordinais, podemos indicar as categorias mínima e máxima ou as categorias dos quartis. Para interpretar uma diferença numérica entre os seus códigos como uma distância, precisamos de justificar o significado das diferenças entre códigos.
Porque Não Somar os Desvios?
Uma forma de medir a dispersão seria começar por calcular quanto cada valor se afasta da média: \(d_i=x_i-\bar{x}\). Um desvio negativo indica um valor abaixo da média; um desvio positivo indica um valor acima. Precisamos dos sinais para saber a direcção, mas eles criam um problema se quisermos resumir a distância.
Usemos os comprimentos inventados 8, 9, 10, 11 e 12 cm, cuja média é 10 cm. Subtraindo 10 a cada valor, obtemos os desvios -2, -1, 0, 1 e 2 cm. A sua soma é
\[-2-1+0+1+2=0.\]
Os desvios abaixo da média anulam os que estão acima. O mesmo aconteceria se os comprimentos fossem muito mais afastados da média: a soma continuaria a dar zero. Precisamos de uma forma de juntar as distâncias que conserve essa informação sobre a dispersão.
Esta anulação acontece em qualquer conjunto de valores: os desvios em relação à média somam sempre zero, mesmo numa amostra assimétrica. A nota seguinte mostra porquê.
Pela definição de média, a soma dos valores é \(n\bar{x}\). Ao subtrair a média a cada uma das \(n\) observações, subtraímos precisamente esse total:
\[ \sum_{i=1}^{n}(x_i-\bar{x}) =\sum_{i=1}^{n}x_i-n\bar{x} =0. \]
A média dos desvios com sinais também é zero. Essa propriedade depende de usarmos a média como centro; os desvios a outro centro podem ter uma soma diferente.
Valores Absolutos ou Quadrados?
Duas soluções são tomar o valor absoluto, \(|d_i|\), ou elevar o desvio ao quadrado, \(d_i^2\). Ambas tornam as contribuições positivas ou nulas. Vejamos o que acontece aos desvios do nosso exemplo:
| Comprimento \(x_i\) (cm) | Desvio \(d_i\) (cm) | \(\lvert d_i\rvert\) (cm) | \(d_i^2\) (cm²) |
|---|---|---|---|
| 8 | -2 | 2 | 4 |
| 9 | -1 | 1 | 1 |
| 10 | 0 | 0 | 0 |
| 11 | 1 | 1 | 1 |
| 12 | 2 | 2 | 4 |
| Soma | 0 | 6 | 10 |
Nas duas últimas colunas já podemos somar as distâncias sem as anular. Os resultados diferem porque o quadrado dá mais peso aos desvios maiores. Um desvio de 2 cm contribui com 2 para a soma dos valores absolutos e com 4 para a soma dos quadrados. Um desvio de 10 cm contribui, respectivamente, com 10 e com 100. A distância aumentou cinco vezes; a contribuição quadrática aumentou 25 vezes. É neste sentido que dizemos que o quadrado «penaliza» mais os grandes desvios: quanto mais afastada da média estiver uma observação, mais pesa no cálculo. O NIST/SEMATECH explica esta ponderação em Measures of Scale.
O desvio absoluto médio em relação à média calcula a média das distâncias absolutas:
\[D_{\mathrm{médio}}=\frac{1}{n}\sum_{i=1}^{n}|x_i-\bar{x}|.\]
No exemplo da tabela é \(6/5=1.2\) cm. Ficámos com uma média de distâncias expressa em cm. Vamos agora seguir a outra opção, a dos quadrados, que nos leva à variância. A nota seguinte apresenta uma alternativa robusta baseada em distâncias absolutas.
Podemos usar a mediana como centro e calcular também a mediana das distâncias absolutas a esse centro. O desvio absoluto mediano em relação à mediana é
\[D_{\mathrm{mediano}}=\operatorname{mediana}\bigl(|x_i-\tilde{x}|\bigr).\]
As distâncias à mediana de 10 cm são 2, 1, 0, 1 e 2 cm. Depois de as ordenar, a distância central é 1 cm. Aqui usamos uma mediana em ambos os passos: primeiro para encontrar o centro, depois para resumir as distâncias. Esta medida é mais robusta a valores extremos do que o desvio absoluto médio, cuja média continua a ser sensível a uma observação arbitrariamente grande.
Ambas as medidas podem aparecer com a sigla inglesa MAD. Ao reportá-las, indique o centro e a fórmula. Alguns programas multiplicam o desvio absoluto mediano por um factor para o tornar comparável ao desvio-padrão sob um modelo normal. No nosso exemplo usámos o valor sem esse ajuste. A documentação de mad() no R explicita o factor usado por omissão.
Dos Quadrados à Variância
Se escolhermos os quadrados, obtemos uma medida de dispersão fazendo a média dessas distâncias quadráticas. A ideia essencial é:
\[ \text{variância} \propto \sum_i(x_i-\bar{x})^2. \]
No trabalho com uma amostra, a fórmula habitual é
\[ s^2=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar{x})^2. \]
Portanto, a variância resume distâncias quadráticas à média. É por isso que observações muito afastadas pesam tanto: duplicar um desvio quadruplica a sua contribuição.
Se queremos apenas descrever a dispersão dos \(n\) valores observados, podemos calcular
\[ v_n=\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^2. \]
Se tratamos os dados como uma amostra usada para estimar a variância da população, a convenção habitual usa \(n-1\):
\[ s^2=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar{x})^2. \]
A soma dos quadrados é a mesma; muda a finalidade e o denominador. A nota matemática seguinte explica a origem de \(n-1\).
A média usada no cálculo foi estimada com os próprios dados. Esse centro minimiza a soma dos desvios quadráticos, pelo que as distâncias a ele tendem a ser menores do que as distâncias à verdadeira média populacional.
Além disso, os desvios têm de somar zero: conhecidos \(n-1\) desvios, o último fica determinado pelos restantes. Dizemos que há \(n-1\) graus de liberdade. Para observações independentes e identicamente distribuídas, com variância populacional finita \(\sigma^2\), obtém-se
\[\operatorname{E}\!\left[\sum_{i=1}^{n}(X_i-\bar{X})^2\right] =(n-1)\sigma^2.\]
Dividir por \(n-1\) dá, nestas condições, um estimador não enviesado de \(\sigma^2\): em amostragens repetidas, a sua média é a variância populacional. Esta propriedade não exige normalidade e é a justificação do denominador usado por var() no R. A propriedade de não enviesamento aplica-se a \(s^2\); a raiz quadrada \(s=\sqrt{s^2}\) tem, em geral, algum viés como estimador do desvio-padrão populacional. As condições de amostragem e independência continuam a fazer parte da justificação deste uso inferencial.
Da Variância ao Desvio-Padrão
A variância fica em unidades ao quadrado: cm², anos², euros². O desvio-padrão é a raiz quadrada da variância e regressa às unidades originais:
\[ s=\sqrt{s^2}. \]
No nosso exemplo, \(s=\sqrt{2.5}\approx1.58\) cm. Podemos lê-lo como uma medida da escala das distâncias à média, lembrando que essas distâncias foram quadradas antes de serem combinadas. Por isso, valores muito afastados continuam a exercer grande influência.
Esta sequência é a parte que interessa reter:
\[ x_i-\bar{x} \longrightarrow (x_i-\bar{x})^2 \longrightarrow \text{variância} \longrightarrow \text{desvio-padrão}. \]
Os valores absolutos oferecem outra família de soluções. O desvio absoluto médio e o desvio absoluto mediano, apresentados acima, não dão o mesmo peso aos grandes desvios.
Se extraíssemos a raiz de cada quadrado antes de somar, obteríamos \(\sqrt{d_i^2}=|d_i|\). Fazendo depois a média dessas distâncias, chegaríamos ao desvio absoluto médio. Para calcular o desvio-padrão, a raiz é extraída só no fim, depois de dividir a soma dos quadrados pelo denominador escolhido.
Numa distribuição normal, cerca de 68% dos valores ficam a uma distância de até um desvio-padrão da média. Essa percentagem depende da forma da distribuição. Para a usar com dados observados, precisamos de avaliar se a aproximação normal é adequada.
Aqui usámos o desvio-padrão para descrever a variação entre observações. Em Inferência Estatística, veremos como a incerteza de estimação da média em amostragens repetidas é resumida pelo erro-padrão da média.
Forma da Distribuição
Duas distribuições podem ter centros e dispersões semelhantes e, ainda assim, formas diferentes. A assimetria (skewness) e a kurtose (kurtosis) são dois sumários clássicos dessa forma. A página Measures of Skewness and Kurtosis do NIST/SEMATECH apresenta os coeficientes usuais e algumas das convenções que os programas adoptam. Convém conhecê-los para ler um manual ou um resultado de software, mesmo quando não precisamos de os reportar.
Para variáveis estritamente ordinais, a ordem e as frequências acumuladas são directamente interpretáveis. Coeficientes que subtraem códigos ou quantis exigem, além da ordem, uma interpretação das distâncias entre esses valores. A nota seguinte mostra por que razão esta distinção importa e apresenta alternativas baseadas apenas na ordenação.
Há uma distinção importante entre usar a ordem das categorias e fingir que as distâncias entre elas são conhecidas. A moda, a categoria mediana, os quantis como categorias e as frequências acumuladas continuam a fazer sentido numa escala estritamente ordinal. Podemos, por exemplo, observar se a moda fica abaixo, coincide com ou fica acima da categoria mediana e comparar a massa de probabilidade acumulada dos dois lados. Estas descrições usam ordem e frequências, não a distância entre códigos.
A história da assimetria contém várias tentativas de transformar relações entre centros em coeficientes. Pearson comparou média e moda; Yule comparou média e mediana; Bowley (1920) propôs um coeficiente baseado em quartis,
\(B=\frac{Q_3+Q_1-2Q_2}{Q_3-Q_1}.\)
Este último é robusto e evita momentos, mas há uma armadilha: não passa a ser uma medida estritamente ordinal só por usar mediana e quartis. A fórmula subtrai os valores dos quantis. Se «baixo», «médio» e «alto» forem codificados como 1, 2 e 3 ou como 1, 2 e 10, a ordem é a mesma mas as diferenças mudam. O mesmo problema afecta coeficientes históricos baseados em distâncias entre média, mediana ou moda.
Para variáveis categóricas ordenadas em sentido estrito, Klein e Doll (2021) argumentam que uma medida de assimetria deve ser invariante perante transformações estritamente crescentes e contínuas, e propõem uma classe de medidas que cumpre esse requisito. Esta é uma boa ilustração da diferença entre «ordinal» e «números que por acaso representam categorias ordenadas». A distinção entre a escala como propriedade do procedimento e os códigos numéricos é discutida na Teoria da Medida.
Também existem alternativas à kurtose de momentos baseadas em quantis. A kurtose de Moors (1988), por exemplo, usa octis:
\(M=\frac{(Q_{.875}-Q_{.625})+(Q_{.375}-Q_{.125})} {Q_{.75}-Q_{.25}}.\)
É útil para variáveis quantitativas e para pontuações ordenadas quando temos uma justificação para interpretar as diferenças entre valores, mas não é invariante numa escala estritamente ordinal. Para categorias puramente ordinais, é mais defensável descrever concentração, dispersão, caudas aparentes e picos pelas frequências e frequências acumuladas, e mostrar a distribuição num gráfico, do que atribuir significado métrico aos códigos das categorias.
Assimetria
Uma distribuição simétrica tem a mesma forma dos dois lados de um centro. Numa distribuição com assimetria positiva, a cauda estende-se mais para a direita, para valores elevados; com assimetria negativa, estende-se mais para a esquerda, para valores baixos. A direcção da cauda dá o nome à assimetria, não o lado onde se concentra a maioria das observações.
Por exemplo, numa distribuição de salários com muitos valores moderados e poucos muito elevados, podemos encontrar uma cauda longa à direita. Esses valores entram directamente no cálculo da média e tendem a deslocá-la para a cauda. A mediana depende sobretudo da posição das observações ordenadas e costuma deslocar-se menos. Numa distribuição unimodal, o pico pode ficar ainda mais perto da região onde os dados se concentram. Daí vem a regra mnemónica frequentemente ensinada para uma distribuição assimétrica positiva:
moda < mediana < média
e, invertendo a direcção, para uma assimetria negativa:
média < mediana < moda.
Esta é uma descrição frequente de distribuições unimodais com uma cauda dominante, não uma propriedade geral da assimetria. A regra perde utilidade rapidamente quando há dois ou mais picos: podemos ter várias modas, um pico local longe do centro global, ou média e mediana em posições que já não seguem essa ordenação. É precisamente um dos casos em que olhar para a distribuição é mais informativo do que tentar inferir a sua forma pela posição relativa de três números.
O coeficiente clássico baseado no terceiro momento padronizado combina os desvios ao cubo. Ao contrário do quadrado, o cubo conserva o sinal: \((-2)^3=-8\) e \(2^3=8\). Os grandes desvios de cada lado contribuem, portanto, com sinais opostos. Um coeficiente positivo indica predomínio das contribuições cúbicas positivas; um coeficiente negativo indica o contrário. A nota matemática abaixo mostra como se retiram as unidades e o que podemos concluir destes valores.
Kurtose
Poderá ter aprendido que a kurtose mede o “achatamento” ou o “pico” de uma distribuição. Essa regra é enganadora (Westfall, 2014). A kurtose clássica usa desvios à quarta potência: \(1^4=1\), \(2^4=16\), \(3^4=81\). Valores afastados do centro ganham, portanto, um peso enorme.
É mais útil pensar na kurtose como particularmente sensível à extremidade das caudas do que como uma medida simples de “pontiagudez”. Duas distribuições podem ter a mesma kurtose e picos muito diferentes. O gráfico continua a ser necessário para conhecer a forma.
A normal tem kurtose 3. Quando o software apresenta excesso de kurtose, subtrai 3 e a referência normal passa a ser 0. Os termos tradicionais leptocúrtica, mesocúrtica e platicúrtica significam apenas, respectivamente, kurtose acima, igual ou abaixo dessa referência; não determinam a aparência global da distribuição.
Um momento central de ordem \(r\) resume potências dos desvios ao centro. Para os dados observados, definimos
\[m_r=\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^r.\]
O segundo momento \(m_2\) é a variância descritiva com denominador \(n\), não a variância corrigida \(s^2\). Para calcular estes momentos, precisamos de interpretar as diferenças numéricas como distâncias, tal como no cálculo da variância. Se \(m_2>0\), os coeficientes empíricos não corrigidos são
\[g_1=\frac{m_3}{m_2^{3/2}},\qquad b_2=\frac{m_4}{m_2^2},\qquad g_2=b_2-3.\]
Aqui, \(g_1\) mede assimetria, \(b_2\) é a kurtose e \(g_2\) o excesso de kurtose. As unidades cancelam-se: no exemplo dos comprimentos, \(m_3\) tem unidades cm³, como \(m_2^{3/2}\); \(m_4\) tem unidades cm⁴, como \(m_2^2\). Se todos os valores forem iguais, \(m_2=0\) e estes quocientes não estão definidos.
Numa distribuição simétrica com terceiro momento finito, as contribuições cúbicas anulam-se e o coeficiente de assimetria é zero. A anulação também pode ocorrer numa distribuição assimétrica. A relação entre média e mediana é uma pista útil em muitos casos, mas precisa de ser lida à luz da distribuição.
Da mesma forma, assimetria zero e excesso de kurtose zero são compatíveis com várias formas de distribuição. Para avaliar uma aproximação normal, precisamos de olhar também para os dados e para as consequências dessa aproximação na análise. Em amostras pequenas, uma única observação extrema pode dominar estes coeficientes.
Na população, substituímos as médias amostrais pelas esperanças das potências dos desvios à média populacional e padronizamos com a variância populacional. Os momentos necessários têm de existir e a variância tem de ser positiva. Software diferente pode usar correcções de amostra finita ou outros coeficientes de assimetria. Antes de comparar números, confirme a fórmula, o denominador e se a kurtose é apresentada com ou sem a subtracção de 3.
Ao usar um destes coeficientes, procure a característica que ele ajuda a descrever. Uma cauda longa, por exemplo, pode merecer atenção por reunir observações substantivamente importantes. O gráfico permite localizá-las e perceber o seu contributo para o sumário.
1 Voltar aos Dados: O Papel dos Gráficos
Até aqui comprimimos os dados deliberadamente. Uma frequência, uma média, um quantil ou um desvio-padrão responde bem a uma pergunta específica, precisamente porque deixa muitas outras características de fora.
Um sumário responde a uma pergunta; um gráfico pode mostrar-nos que havia outras perguntas que devíamos ter feito.
Um gráfico organiza muitas observações no mesmo campo visual e permite-nos apreender rapidamente assimetria, grupos, lacunas, valores extremos, caudas e relações não lineares. Por isso, os gráficos não são decoração acrescentada depois das estatísticas descritivas. São outra forma de descrição e, muitas vezes, a forma que revela quais os sumários numéricos que vale a pena calcular.
A Forma nos Gráficos
Podemos começar por ver a distribuição e depois usar média, mediana, desvio-padrão, AIQ, assimetria, kurtose ou outros sumários para medir as características que encontrámos.
Anscombe (1973) tornou este problema célebre com quatro conjuntos de dados que partilhavam praticamente os mesmos sumários — incluindo médias, variâncias, correlação e regressão linear — mas tinham aparências muito diferentes quando representados graficamente. Matejka e Fitzmaurice (2017) levaram a ideia muito mais longe: o Datasaurus Dozen mostra conjuntos com formas radicalmente diferentes mantendo praticamente constantes vários dos mesmos sumários.
Abrir a demonstração Same Stats, Different Graphs
Matejka, J., & Fitzmaurice, G. (2017). Same Stats, Different Graphs: Generating Datasets with Varied Appearance and Identical Statistics through Simulated Annealing. CHI 2017, 1290–1294. doi:10.1145/3025453.3025912. O trabalho desenvolve a demonstração clássica de Anscombe, F. J. (1973), Graphs in Statistical Analysis, The American Statistician, 27(1), 17–21. doi:10.1080/00031305.1973.10478966.
Gráfico e sumário fazem trabalhos diferentes e complementares. O gráfico dá acesso rápido à estrutura global; os números permitem medir, comparar, comunicar e modelar características específicas. Vale a pena usá-los em conjunto.
Mostrar os Dados Antes do Sumário
Quando o número de observações o permite, pontos individuais — eventualmente com transparência, deslocamento horizontal moderado ou painéis por grupo — mostram mais do que uma barra da média. Para grupos grandes, podemos juntar pontos, quantis, caixas ou densidades, mas convém deixar claro o que cada camada representa. Uma barra alta pode ser uma média elevada, uma soma, uma contagem ou uma proporção: o eixo e a legenda devem dizê-lo explicitamente.
Não há um gráfico universalmente correcto. Há uma escolha que torna mais fácil ver a comparação que interessa sem esconder as alternativas plausíveis.
Categorias: Barras e, com Reserva, Sectores
Gráficos de barras são normalmente uma boa primeira escolha para contagens ou proporções de categorias: permitem comparar comprimentos e ordenar as categorias por uma ordem substantiva ou por frequência. Quando o comprimento codifica uma contagem ou proporção, o eixo deve normalmente começar em zero. Cortar a base exagera diferenças visuais.
Um gráfico circular pode ser reconhecível, mas comparar ângulos e áreas é muitas vezes mais difícil do que comparar barras. As barras facilitam particularmente a comparação entre várias categorias ou entre frequências próximas.
Distribuições: Histogramas, Caixas e Densidades
Um histograma agrupa valores quantitativos em intervalos. A sua aparência depende da largura e do ponto de início dos intervalos. Mudar ambos pode sugerir padrões diferentes. Por isso, não devemos declarar uma distribuição “normal” ou “bimodal” após experimentar uma única divisão em barras. Mostrar alternativas razoáveis ou os pontos subjacentes é muitas vezes esclarecedor.
Uma caixa de bigodes (boxplot) mostra tipicamente \(Q_1\), mediana e \(Q_3\). A caixa cobre a AIQ. Na convenção mais comum, os bigodes chegam ao valor observado mais distante que se encontre, no máximo, a 1.5 AIQ da caixa, e os restantes pontos são desenhados separadamente. Não são, portanto, necessariamente o mínimo e o máximo, nem os pontos marcados são automaticamente erros: são observações que merecem ser verificadas e compreendidas no contexto do estudo.
Uma curva de densidade é uma estimativa suavizada. A altura não é uma contagem e pode ser superior a 1. A área total sob a curva é 1. A suavização pode inventar ou apagar pequenos picos, sobretudo com poucos dados. É útil compará-la com um histograma, uma caixa ou pontos, não tratá-la como a silhueta exacta da população.
Relações: Pontos, Grupos e Escalas
Um diagrama de dispersão é o ponto de partida para duas variáveis quantitativas: cada ponto representa uma observação. Permite procurar curvatura, grupos, heterogeneidade da dispersão e casos influentes antes de resumir tudo por uma recta ou correlação. Cor, forma e painéis podem acrescentar uma categoria, desde que não transformem a legenda num teste de visão cromática.
Ao comparar grupos, escalas comuns facilitam a comparação entre painéis. Uma escala diferente pode ser justificada para tornar visível uma estrutura local, mas deve ser evidente. O leitor não deve descobrir a mudança depois de tirar uma conclusão. Rótulos com unidades, uma legenda que explique os símbolos e uma indicação de \(n\) tornam o gráfico verificável.
2 Descrição Antes da Inferência
Podemos usar a estatística descritiva por si só: contar observações, representar distribuições e relações e calcular sumários dos dados observados.
A inferência parte dessas descrições e pergunta como uma estatística observada se relaciona com outras amostras possíveis, com um parâmetro ou com as previsões de um modelo. O erro-padrão descreve a variabilidade de uma estatística entre amostras possíveis. Um intervalo de confiança parte de uma estimativa, e um teste compara uma estatística dos dados com o comportamento previsto por um modelo. Precisamos, por isso, de compreender o que foi observado e o que a estatística resume antes de estudar a sua incerteza.
Podemos ficar pela descrição. Quando fazemos inferência, começamos por ela. Para começar pela interpretação, siga a moeda da Filosofia da Estatística. Para perceber como uma média varia entre amostras, entre nos Fundamentos da Inferência, onde chegamos às distribuições amostrais e ao erro-padrão.
3 O Que Reter
A estatística descritiva é compressão orientada por uma pergunta. Antes de calcular, identifique a unidade de observação e pergunte o que precisa de ficar visível.
O mapa do capítulo cabe em quatro perguntas:
- Com que frequência? Contagens e proporções descrevem categorias e ocorrências.
- Onde estão os valores? Moda, mediana, quantis e média localizam aspectos diferentes da distribuição.
- Quanto variam? Amplitudes descrevem larguras; desvios absolutos e quadráticos descrevem distâncias a um centro. Variância e desvio-padrão nascem dos desvios quadráticos.
- Que forma ou relação têm? Coeficientes quantificam características particulares; um gráfico preserva muito mais da estrutura observada.
Nenhum destes sumários é uma miniatura completa dos dados. A sequência produtiva é olhar, descrever, comparar e só depois modelar ou testar. Gráficos e números pertencem ao mesmo trabalho: os gráficos ajudam-nos a descobrir que perguntas devemos fazer; os números ajudam-nos a medir e comunicar as respostas.
4 Exercícios de Reflexão
Comecem pelas três perguntas seguintes se esta for a vossa primeira leitura. As restantes permitem aprofundar resumos, gráficos e fórmulas.
Dados e Modelo. Numa turma de dez pessoas, três faltaram zero vezes, quatro faltaram uma vez, duas faltaram duas vezes e uma faltou quatro vezes. Esta tabela descreve o que observámos ou aquilo que um modelo probabilístico prevê? Se quiséssemos estimar a probabilidade de um estudante faltar num dia, de que mais precisaríamos de saber?
Barras ou Áreas? Uma moeda justa é lançada dez vezes. O modelo diz que obter seis ou mais caras tem probabilidade 37.7%. Onde procurariam essa probabilidade na figura das distribuições? E a probabilidade de uma normal estar entre -1 e 1? Precisariam de somar probabilidades de valores específicos ou de medir uma área?
Uma Curva Para Contagens? Se lançarmos uma moeda mil vezes, o número de caras continua a ser discreto. Porque é que, apesar disso, uma curva normal pode ajudar a estimar probabilidades? Conseguimos observar exactamente 500.5 caras?
Para Explorar com Mais Tempo
- Uma amostra tem média 50, mediana 42 e desvio-padrão 30. Que distribuições ou problemas de dados ainda seriam compatíveis com estes três números? Que gráfico pediria antes de interpretar a diferença entre média e mediana?
- Um boxplot assinala duas observações como estando para lá de 1.5 AIQ. Explique porque é que isto não autoriza, por si só, apagá-las.
- Faça dois histogramas do mesmo conjunto de dados com escolhas razoavelmente diferentes de intervalos. Que conclusões permanecem estáveis? Quais dependem da escolha de visualização?
- Ordene os valores 12, 8, 11 e 9 cm e calcule a mediana. Porque é que a posição central e o valor da mediana são coisas diferentes? Opcional: consulte a nota sobre escalas ordinais e compare as convenções de apresentação quando os dois lugares centrais pertencem a categorias diferentes.
- Para 8, 9, 10, 11 e 12 cm, explique porque a soma dos desvios à média dá zero. Isso indica ausência de dispersão? Calcule o desvio absoluto médio, a variância com denominador \(n\) e a variância com denominador \(n-1\). Extraia os dois desvios-padrão correspondentes e indique as unidades de cada resultado. Porque é que o desvio-padrão não é o desvio absoluto médio?
- Substitua 12 por 32 cm no conjunto anterior. Compare a média e a mediana antes e depois da substituição. Que pergunta poderia justificar reportar a média apesar da sua maior sensibilidade? Que verificações faria antes de decidir se o valor 32 deve ser corrigido ou mantido?
- Um programa reporta kurtose 3 e outro reporta excesso de kurtose 0 para os mesmos dados. Há necessariamente uma discordância? Opcional: consulte a nota sobre momentos padronizados e explique se esses resultados, acompanhados de assimetria zero, demonstram que a distribuição é normal?
5 Recursos Para Consulta
Para consultar as definições clássicas em inglês, o NIST/SEMATECH e-Handbook of Statistical Methods reúne medidas de localização, medidas de dispersão e assimetria e kurtose. Ao comparar essas fórmulas com resultados de software, procure sobretudo o denominador, as correcções amostrais e a convenção de excesso de kurtose.
Para passar das ideias aos cálculos e gráficos, use os tutoriais de descritivas no R e de gráficos no R. Para aprofundar as alternativas à média e ao desvio-padrão perante observações influentes, consulte Estatística Robusta.
6 Referências
Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs. Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems, 1290–1294. https://doi.org/10.1145/3025453.3025912
Klein, I., & Doll, M. (2021). Tests on asymmetry for ordered categorical variables. Journal of Applied Statistics, 48(7), 1180–1198. https://doi.org/10.1080/02664763.2020.1757045
Moors, J. J. A. (1988). A quantile alternative for kurtosis. The Statistician, 37(1), 25–32. https://doi.org/10.2307/2348376
Westfall, P. H. (2014). Kurtosis as peakedness, 1905–2014. R.I.P. The American Statistician, 68(3), 191–195. https://doi.org/10.1080/00031305.2014.917055