Código
library(ggplot2)
library(palmerpenguins)

options(contrasts = c("contr.sum", "contr.poly"))

vars <- c("body_mass_g", "species", "sex")
data <- penguins[complete.cases(penguins[, vars]), vars]Em muitos cursos, os pressupostos aparecem ao lado dos nomes dos testes. Para o teste-t e a ANOVA, falava-se de normalidade dentro dos grupos e de homogeneidade das variâncias. Para a regressão, apareceram linearidade, normalidade dos resíduos, dispersão constante dos erros (homoscedasticidade) e ausência de associações fortes entre preditores (multicolinearidade). Talvez tenha aprendido também a pedir um teste de normalidade antes de avançar. A lista cresceu, mas a razão de ser de cada condição nem sempre ficou tão clara.
Em Comparação de Modelos vimos que estes testes são estudados através do mesmo percurso: ajustar modelos com lm(), interpretar coeficientes e previsões e comparar restrições. Os nomes tradicionais ajudam a reconhecer essas comparações, mas não exigem um procedimento separado para cada teste. Como podem, então, ter pressupostos diferentes? O que significa realmente cada um? E porque nos devemos preocupar se o R continua a fazer as contas e o céu não nos cai em cima?
O R consegue encontrar os coeficientes que melhor reproduzem uma amostra sem saber se essa amostra representa a população que nos interessa, se medimos dez animais ou dez vezes o mesmo animal, ou se a relação estudada é aproximadamente uma recta. Conseguir calcular uma resposta é o primeiro passo. Precisamos ainda de perceber o que essa resposta estima e que incerteza lhe podemos atribuir.
Vamos separar três tarefas: ajustar previsões aos dados, estimar uma relação na população e usar uma estatística de teste para fazer inferência. Os pressupostos entram em pontos diferentes deste percurso. Compreender essa diferença permite avaliar uma análise sem a transformar numa colecção de carimbos «passou» e «não passou».
A formulação comum no manual de R, §11.1 é a nossa referência. Aqui desenvolveremos o seu significado; o tutorial de diagnóstico mostra o trabalho no R e Estatística Robusta aprofunda as alternativas de estimação e inferência.
Comecemos pela equação mais familiar de uma regressão simples:
\[ \hat Y_i=\hat\beta_0+\hat\beta_1x_i. \]
Escolhemos um valor de \(x\), multiplicamos pelo declive, somamos o intercepto e obtemos uma previsão. A observação pode ficar acima ou abaixo dela. Essa diferença é o resíduo,
\[ e_i=Y_i-\hat Y_i. \]
Se acrescentarmos um preditor, permitimos mais variação nas previsões. Na comparação entre modelos compacto e aumentado perguntamos quanto diminui a soma dos resíduos ao quadrado, \(SSE\), ao libertar os novos coeficientes. Até aqui estamos a descrever contas feitas com os dados disponíveis.
Um factor entra na mesma equação através de colunas numéricas de contrastes. A diferença é que essas colunas só podem assumir certos valores. Com três níveis, por exemplo, a codificação soma-zero que já conhecemos é
| Nível | \(C_1\) | \(C_2\) |
|---|---|---|
| A | +1 | 0 |
| B | 0 | +1 |
| C | −1 | −1 |
O modelo continua a multiplicar preditores por coeficientes:
\[ \hat Y=\hat\beta_0+\hat\beta_1C_1+\hat\beta_2C_2. \]
Mas agora só existem três combinações admissíveis desses preditores. Substituindo os valores da tabela, obtemos
\[ \hat Y_A=\hat\beta_0+\hat\beta_1,\qquad \hat Y_B=\hat\beta_0+\hat\beta_2,\qquad \hat Y_C=\hat\beta_0-\hat\beta_1-\hat\beta_2. \]
Temos três previsões, em vez de uma recta percorrida por um preditor contínuo. Os coeficientes dos contrastes fazem algebricamente o trabalho de declives, mas não faz sentido inventar uma categoria a meio de A e B só porque conseguimos colocar outro número na equação.
Mais níveis exigem mais contrastes. Mais factores criam mais combinações, e as interacções permitem que o contributo de um contraste dependa dos outros. Enquanto todos os preditores forem categóricos, o conjunto de previsões para as combinações dos seus níveis continua a ser finito. Num factorial, chamamos célula a cada combinação de níveis. Se incluirmos todos os termos e interacções, com células observadas e parâmetros estimáveis, o modelo pode ajustar uma previsão livre a cada célula. Dizemos que fica saturado para essas células. Por mínimos quadrados, essas previsões são precisamente as médias amostrais das células.
É daqui que vem a linguagem da ANOVA. Chegámos às médias por célula resolvendo uma equação de regressão. Um modelo aditivo, como y ~ A + B, impõe restrições às previsões e pode não reproduzir essas médias. Acrescentar A:B liberta a restrição de aditividade; a comparação pergunta se essa liberdade reduz suficientemente o erro.
Ajustar significa escolher coeficientes para aproximar as previsões das observações. Os mínimos quadrados ordinários, ou OLS (ordinary least squares), escolhem os que minimizam
\[ SSE=\sum_i(Y_i-\hat Y_i)^2. \]
Podemos fazer esta conta com erros assimétricos, variâncias diferentes ou medições dependentes. Algumas dessas condições mudam as propriedades da estimativa, mas não impedem a minimização. Para obter uma solução única para todos os coeficientes precisamos de preditores sem redundâncias exactas: é a condição de posto completo, a que voltaremos.
Estimar uma relação populacional exige uma ligação entre o ajuste e o processo que gerou os dados. Escrevemos essa ligação como
\[ Y_i=m(X_i)+\varepsilon_i, \]
onde \(X_i\) reúne os preditores da unidade \(i\) e \(m(X_i)\) é a função que propomos para fazer previsões na população. O erro, \(\varepsilon_i\), é o desvio da observação em relação a essa função.
Que queremos prever? Pensemos em todas as observações da população que partilham os mesmos valores dos preditores: por exemplo, pinguins da mesma espécie e sexo, com o mesmo comprimento de barbatana. Queremos representar a sua massa média. Essa média chama-se média condicional: «condicional» indica que fixámos os valores dos preditores. Não precisamos de ter vários pinguins exactamente iguais na amostra para propor uma função para essa média na população.
Na regressão simples propomos \(m(X_i)=\beta_0+\beta_1x_i\). A recta proposta pode aproximar bem essa média ou falhá-la sistematicamente. Ao ajustar o modelo à amostra, obtemos \(\hat Y_i=\hat\beta_0+\hat\beta_1x_i\): são as previsões calculadas com os coeficientes estimados. Queremos que o declive estimado nos informe sobre o \(\beta_1\) populacional. Para isso, precisamos de justificar a forma da relação e o que assumimos sobre os erros.
Fazer inferência com um teste acrescenta outra pergunta: que resultados produziria esta comparação se a restrição do modelo compacto fosse verdadeira? O R calcula um F a partir da redução de \(SSE\) e dos graus de liberdade. Para converter esse número num valor-p, precisa de uma distribuição de referência. No modelo Gaussiano clássico, normalidade, independência e variância comum dos erros permitem obter distribuições t e F exactas em amostras finitas. É essa justificação probabilística que podemos perder, mesmo quando a tabela continua a aparecer no ecrã.
Podemos, portanto, ter um declive bem estimado e um erro-padrão mal calculado. Também podemos ter um intervalo muito estreito para um coeficiente que não representa a relação que pretendíamos estudar. Vamos seguir estas duas possibilidades ao examinar cada condição.
Para cada combinação de valores dos preditores, queremos que a previsão populacional \(m(X_i)\) coincida com a média de \(Y\) nessa parte da população. Assumimos, por isso, que os erros positivos e negativos se compensam em média:
\[ E(\varepsilon_i\mid X_i)=0. \]
O símbolo \(E\) indica uma média na população; a barra \(\mid X_i\) lê-se «para os valores dos preditores em \(X_i\)». A equação afirma que a média dos erros é zero para cada combinação desses valores. É um pressuposto sobre a função proposta: escrever \(Y_i=m(X_i)+\varepsilon_i\) apenas define o erro e não garante que a sua média seja zero.
Assim, o modelo não fica sistematicamente acima ou abaixo da resposta média para esses valores dos preditores. Os erros individuais podem ser grandes. Uma faixa de observações muito dispersa pode continuar bem centrada na previsão; uma faixa estreita pode seguir uma curva que a recta falha.
Porque precisamos desta condição? Porque queremos que os coeficientes estimem a relação média que escrevemos no modelo. Se a recta ficar sempre abaixo da média num extremo e acima no outro, o declive calculado estará a absorver uma estrutura que a equação não representa adequadamente. Aumentar a amostra pode tornar esse resumo muito preciso sem o transformar na relação que queríamos estimar.
Para estudar as estimativas OLS, usamos esta condição tendo em conta todos os preditores de todas as observações. Reunimo-los numa tabela numérica, a matriz do modelo, \(\mathbf X\), e escrevemos \(E(\boldsymbol\varepsilon\mid\mathbf X)=\mathbf 0\). Esta é uma condição de exogeneidade: a média dos erros continua a ser zero quando fixamos toda essa informação.
Sem redundâncias exactas entre as colunas do modelo (posto completo), esta condição justifica estimativas sem viés para os parâmetros especificados: se repetíssemos a amostragem sob estas condições, a média das estimativas coincidiria com esses parâmetros. Não exige, por si só, normalidade nem variância constante dos erros.
É tentador confirmar a condição calculando a média dos resíduos. Só que, num ajuste OLS com intercepto, essa média já é zero por construção. Os resíduos também têm associação linear amostral nula com cada preditor não constante incluído no modelo. Na linguagem da álgebra, são ortogonais às colunas do modelo. São propriedades da conta que fizemos, não descobertas sobre a população (Hyndman e Athanasopoulos, §7.3). Precisamos de procurar estrutura que a conta ainda não conseguiu absorver.
Uma recta afirma que cada unidade adicional de \(x\) se associa à mesma mudança média em \(Y\). Essa é uma hipótese substantiva. Num exemplo hipotético, o crescimento de uma alga aumenta com os nutrientes até se aproximar de um patamar. Uma recta ajustada a toda essa região pode sobrestimar o crescimento nas extremidades e subestimá-lo no meio. Nos resíduos ficará uma curva.
Conseguimos calcular o declive dessa recta. A dificuldade está em interpretá-lo como uma mudança constante quando o próprio processo parece abrandar. Um termo quadrático ou uma curva de saturação permitem outras previsões. «Linear», em modelo linear, refere-se à combinação dos coeficientes: incluir \(x^2\), transformações dos preditores ou interacções pode produzir curvas e continuar a dar um modelo linear nos parâmetros.
A escolha da forma ganha sentido quando a ligamos ao processo. Esperávamos um patamar porque outro recurso se torna limitante? Já foi observado em estudos anteriores? Temos medições suficientes na região onde as duas formas divergem? O gráfico dos dados e os resíduos contra os preditores ajudam a formular estas perguntas. Comparar os modelos quantifica a melhoria do ajuste ao libertar a curvatura; o conhecimento biológico ajuda a decidir que relação estamos a tentar representar.
Uma relação média bem representada pode ser útil para previsão e continuar a não ter a interpretação causal que gostaríamos de lhe dar. Uma associação entre exercício e saúde, por exemplo, pode incluir diferenças de saúde prévia que também influenciam a prática de exercício. O declive pode descrever bem a associação observável sem medir o efeito de intervir no exercício.
Quando o alvo é um efeito causal, uma causa omitida associada ao preditor pode comprometer a condição de média zero na equação causal pretendida. Um gráfico de resíduos sem padrões evidentes não mostra que eliminámos esse confundimento, isto é, a mistura da associação que nos interessa com o contributo de outras causas. Precisamos da justificação adicional do delineamento, da medição e do processo de selecção das unidades. Precisamos tanto de avaliar o ajuste como de justificar que a relação estimada permite responder à pergunta causal.
Antes de discutir a incerteza de um declive, convém saber se os dados permitem separá-lo dos restantes. A matriz do modelo contém uma coluna para o intercepto e outras para preditores, contrastes e interacções. Para estimar cada coeficiente separadamente, nenhuma coluna pode ser reproduzida exactamente multiplicando outras por constantes e somando os resultados. Esta ausência de redundância exacta chama-se posto completo.
Num exemplo hipotético, incluímos o comprimento de cada peixe em centímetros e o mesmo comprimento em milímetros. A previsão depende de \(\beta_{\mathrm{cm}}x+\beta_{\mathrm{mm}}10x\). Podemos aumentar um coeficiente e compensar no outro sem alterar uma única previsão. Os dados informam-nos sobre a combinação \(\beta_{\mathrm{cm}}+10\beta_{\mathrm{mm}}\), mas não sobre os dois contributos separadamente. É um problema de identificação, anterior à escolha de uma distribuição dos erros.
O R pode omitir um coeficiente redundante e continuar a produzir previsões. Isso resolve o cálculo, mas não recupera a informação em falta. Uma célula vazia num factorial completo pode criar o mesmo tipo de dificuldade: certos contrastes exigem previsões que os dados não permitem estimar.
A multicolinearidade elevada, mas imperfeita, tem outra consequência. Se idade e tamanho estiverem fortemente associados, talvez existam poucos animais de idades diferentes com tamanho semelhante. Conseguimos separar o declive de cada um mantendo o outro no modelo, mas com pouca precisão. Os intervalos podem ser largos e as estimativas reagir muito a pequenas alterações da amostra. Dentro da região observada, as previsões conjuntas podem continuar boas.
Sob as restantes condições de identificação e média zero, essa associação forte entre preditores não introduz automaticamente viés em OLS. Aumenta a variância das estimativas. Para um preditor representado por uma única coluna, o factor de inflação da variância, ou VIF, resume quanto aumenta a variância da estimativa devido à associação com os restantes preditores:
\[ \mathrm{VIF}_j=\frac{1}{1-R_j^2}, \]
onde \(R_j^2\) vem de prever esse preditor a partir dos restantes. Quanto mais os outros conseguem reproduzi-lo, menos informação distinta resta para estimar o seu declive parcial (Penn State, §10.7). Para factores com várias colunas precisamos de diagnósticos apropriados aos termos, como explica o tutorial.
Esta dificuldade também nos diz algo sobre a amostra. Talvez tenhamos observado apenas uma estreita trajectória de crescimento. Recolher animais que permitam separar idade de tamanho pode ser mais informativo do que eliminar o preditor com maior VIF. Centrar uma covariável facilita certas interpretações e pode reduzir correlações entre colunas de interacções, mas não cria combinações de idade e tamanho que nunca observámos.
Já distinguimos o erro populacional do resíduo calculado com a previsão ajustada. Podemos agora traduzir o pressuposto de normalidade que costuma acompanhar a ANOVA.
No modelo saturado para as células, cada combinação dos contrastes recebe uma previsão igual à média amostral dessa célula. Um pinguim de 4 500 g terá um resíduo diferente consoante a previsão usada: uma única previsão para todos os pinguins, uma por espécie, ou uma por combinação espécie × sexo. O desvio só tem significado em relação a um modelo.
Se subtrairmos a média populacional a todos os valores de uma célula, mudamos a posição da distribuição, preservando a forma e a dispersão. Assim, normalidade da resposta dentro de cada célula equivale a normalidade dos erros dentro dessa célula. O pressuposto não mudou de sítio quando passámos para a regressão. Apenas o exprimimos em relação à previsão.
Juntar valores brutos de células com médias diferentes pode produzir uma distribuição não normal, mesmo que a distribuição dentro de cada célula seja normal. Na regressão com preditores contínuos, a previsão também muda, agora ao longo desses preditores. Perguntamos pela distribuição dos erros à volta dessa previsão, sem criar uma célula para cada comprimento. O comprimento da barbatana não precisa de ser normal para estudarmos a massa em função dele.
A igualdade das variâncias é uma segunda pergunta: a distribuição tem a mesma dispersão em cada condição? A homogeneidade entre células é a homoscedasticidade dos erros expressa na linguagem da ANOVA. Podemos ter normalidade em todas as células e variâncias diferentes entre elas.
A equivalência com as médias amostrais por célula exige o modelo que as ajusta livremente, com parâmetros estimáveis. Um modelo aditivo como y ~ A + B pode deixar diferenças entre células nos resíduos. Voltar a centrá-los por célula esconderia precisamente parte da inadequação que queremos investigar.
Num factorial completo e equilibrado, sem covariáveis e com contrastes centrados, os espaços dos termos são ortogonais. Helmert torna também ortogonais as colunas individuais; contr.sum() não o garante com mais de dois níveis. Desequilíbrio, exclusões e células vazias podem alterar esta estrutura. Veja a nota sobre equilíbrio e ortogonalidade e a documentação de model.matrix(). A ortogonalidade não estabelece normalidade, variância constante ou independência dos erros.
Os resíduos usam coeficientes estimados com os mesmos dados. Por isso são, em geral, dependentes entre si mesmo quando os erros populacionais são independentes. Os seus gráficos permitem investigar o modelo, mas não são observações directas dos erros populacionais. A documentação de lm() define os resíduos como resposta menos valor ajustado.
Porque aparece tantas vezes a Normal? No modelo Gaussiano clássico, assumir erros normais, independentes e com variância comum permite deduzir a distribuição dos coeficientes e das somas de quadrados. Sob a hipótese nula, daí resultam as distribuições t e F usadas nos testes exactos. A normalidade torna este problema matematicamente tratável e dá uma garantia precisa para a inferência em amostras finitas.
Essa garantia é mais exigente do que a necessária para calcular os coeficientes ou justificar a ausência de viés sob média zero. Com erros não normais, podemos continuar a estimar a relação média. Algumas inferências sobre médias e coeficientes também funcionam por aproximação amostral, cuja qualidade depende da informação disponível e da distribuição dos erros. Um intervalo de previsão para uma nova observação exige ainda atenção à distribuição dos erros individuais: estimar bem a média não chega para saber onde ficará um novo animal (Penn State, §7.1; Hyndman e Athanasopoulos, §7.3).
Como investigamos uma distribuição que não observamos directamente? Usamos os resíduos como diagnóstico. Num gráfico Q–Q, ordenamos os resíduos e comparamos valores em posições equivalentes das duas distribuições (os quantis): a observada e uma Normal. Se as formas forem semelhantes, os pontos aproximam-se de uma recta. Curvatura assimétrica sugere assimetria; extremos muito afastados podem indicar mais valores extremos do que esperaríamos numa Normal (caudas pesadas) ou casos particulares. A documentação de check_normality() recomenda a inspecção visual. Um teste formal consegue assinalar desvios, mas o seu valor-p não mede o efeito desses desvios sobre o contraste que nos interessa.
Com poucos pontos sabemos pouco sobre as caudas. Com muitos, conseguimos detectar irregularidades pequenas. Uma ligeira curvatura com centenas de unidades independentes tem consequências diferentes de uma assimetria forte num ajuste com oito unidades, uma das quais determina quase todo o declive. Também não basta contar linhas: muitas medições do mesmo animal não substituem muitas unidades independentes. Não há um tamanho amostral universal que dispense olhar para a distribuição e para a estrutura da amostra.
A forma pode ainda levantar uma pergunta sobre o fenómeno. Uma escala limitada, variação multiplicativa, populações misturadas ou um erro de medição podem produzir padrões distintos. Um Q–Q não escolhe a explicação por nós. Ajuda a localizar o que merece investigação. Se suspeitarmos de dispersões diferentes entre condições, convém examiná-las separadamente: um gráfico global pode misturar escalas e esconder formas locais.
A homoscedasticidade afirma que a dispersão à volta da previsão é constante. Usamos a variância para a quantificar; \(\sigma^2\) representa o valor comum que assumimos para todas as combinações dos preditores:
\[ \operatorname{Var}(\varepsilon_i\mid\mathbf X)=\sigma^2. \]
Num gráfico de resíduos contra um preditor ou contra as previsões, esperamos uma faixa de espessura semelhante. Uma faixa que alarga, ou dispersões diferentes nas combinações dos factores, sugerem heterocedasticidade.
A variância comum permite resumir a variabilidade dos erros num único \(\sigma^2\). No modelo clássico, estimamo-lo a partir do erro residual e usamos essa estimativa nos erros-padrão e no denominador do F. Se a variância muda ao longo dos preditores, a fórmula usual pode atribuir informação a mais ou a menos às regiões em que estamos a estimar um declive ou um contraste.
Suponhamos que a média está correctamente especificada, há posto completo e \(E(\boldsymbol\varepsilon\mid\mathbf X)=\mathbf 0\). A heterocedasticidade, por si só, não introduz viés nos coeficientes OLS. Altera a sua variância amostral. Os erros-padrão usuais podem sobrestimar ou subestimar a incerteza, e OLS pode dar estimativas menos precisas do que um ajuste que represente correctamente as variâncias (Shalizi, cap. 10, §§10.2–10.2.2). É por isso que podemos manter os coeficientes e mudar o cálculo da incerteza. A página de Estatística Robusta introduz HC3, uma forma de calcular erros-padrão que admite variâncias diferentes, quando as unidades são independentes.
Mas porque alarga a faixa? Animais maiores podem variar mais em gramas. Uma intervenção pode produzir respostas mais heterogéneas. Ou talvez as previsões estejam a reunir relações que faria sentido estudar separadamente. Modelar a variância ou usar erros-padrão adequados permite fazer inferência sobre a relação escolhida. Investigar a origem do padrão pode revelar que há outra pergunta científica interessante.
Num exemplo hipotético, queremos compreender como a massa varia com um comprimento \(x\) e se essa relação muda com o sexo. Imaginemos duas relações que se cruzam em \(x=0\), medido a partir de uma referência, e depois se afastam. Se usarmos uma única recta para ambas, os resíduos podem alargar à medida que nos afastamos do cruzamento.
Essa possibilidade motiva uma comparação concreta: um modelo com um só declive e outro que permite declives diferentes. A interacção \(x\times S\), onde \(S\) codifica o sexo, liberta a diferença entre declives. Estimamos quanto diferem e com que incerteza, examinando se há dados dos dois grupos na região que queremos comparar. Que diferença entre declives seria biologicamente relevante? Que mecanismo a poderia produzir? São essas perguntas que dão interesse à comparação, mesmo que o modelo agregado já represente bem a média.
Codifiquemos os grupos por \(S=0\) e \(S=1\) e escrevamos
\[ Y=\alpha+\beta x+\delta xS+u. \]
\(\delta\) é a diferença entre declives. Suponhamos uma proporção constante \(p\) do grupo \(S=1\) ao longo de \(x\), ambos os grupos representados na região estudada e ruído com \(E(u\mid x,S)=0\) e \(\operatorname{Var}(u\mid x,S)=\sigma^2\). Ignorando \(S\), obtemos
\[ E(Y\mid x)=\alpha+(\beta+p\delta)x, \]
\[ \operatorname{Var}(Y\mid x)=\sigma^2+\delta^2x^2p(1-p). \]
A média agregada continua a ser uma recta. A variância cresce com a distância ao ponto de cruzamento: para \(x\geq0\), aparece o funil crescente habitual; num domínio dos dois lados de zero, a faixa alarga nas duas extremidades.
Neste caso, HC3 pode ajudar a estimar a incerteza do declive agregado, \(\beta+p\delta\). A interacção permite estimar a diferença \(\delta\) entre as relações que o produziram. A escolha depende de qual destas quantidades responde à pergunta científica.
Também podemos juntar duas relações com declives iguais e interceptos diferentes. Aqui as rectas mantêm sempre a mesma distância. A dispersão agregada depende de quanto se misturam os dois grupos em cada valor do preditor: será maior onde ambos estão igualmente representados e menor onde quase só encontramos um deles. Uma separação constante entre rectas não produz necessariamente um funil crescente.
Num segundo exemplo hipotético, escrevemos
\[ Y=\alpha+\beta x+\gamma S+u, \]
onde \(S=0\) ou \(S=1\) identifica o grupo, \(E(u\mid x,S)=0\) e \(\operatorname{Var}(u\mid x,S)=\sigma^2\). Se a proporção de \(S=1\) for \(p(x)\),
\[ E(Y\mid x)=\alpha+\beta x+\gamma p(x), \qquad \operatorname{Var}(Y\mid x)=\sigma^2+\gamma^2p(x)[1-p(x)]. \]
A contribuição adicional para a variância é máxima em \(p=.5\) e desaparece quando só há um grupo. Com \(\sigma=1\) e \(\gamma=4\), as proporções \(.1\), \(.5\) e \(.9\) dão variâncias 2.44, 5 e 2.44. Se a composição for constante, a contribuição para a variância também será constante.
Quando \(p(x)\) muda, a forma da média pode mudar através de \(\gamma p(x)\). A omissão pode, assim, afectar tanto a média como a dispersão, com padrões que dependem da composição da amostra ao longo do preditor.
Colorir os pontos pelo grupo e examinar a cobertura do preditor ajuda a investigar estas possibilidades. Para atribuir o padrão a uma explicação específica precisamos também de conhecimento do processo, boas medições e uma comparação que permita distingui-la das alternativas. Regressaremos a esse passo depois dos restantes diagnósticos.
A independência diz que conhecer o erro de uma unidade não nos informa sobre o erro de outra, quando fixamos os valores dos preditores. Precisamos dela no modelo clássico para representar a informação de cada unidade como uma contribuição independente à inferência. Quando os erros partilham variação, os cálculos têm de representar também essa parte partilhada.
Começamos pelo protocolo: o que representa uma linha? Que linhas partilham um animal, tanque, escola, local ou ocasião? A que nível varia o tratamento? Pinguins distintos podem partilhar o nível «espécie» sem isso constituir uma medida repetida. Já várias medições do mesmo pinguim partilham uma unidade, e animais diferentes podem partilhar condições relevantes de um tanque. Identificadores diferentes não garantem independência.
A autocorrelação é uma forma de dependência associada a uma ordem. Num exemplo hipotético, medimos diariamente a actividade de animais e prevemo-la a partir da temperatura. Uma sequência de resíduos positivos pode reflectir persistência de condições não representadas, sazonalidade, adaptação ou deriva do instrumento. O gráfico dos resíduos no tempo e a função de autocorrelação ajudam a perceber a duração desse padrão. A estrutura restante pode conter informação útil para previsão (Hyndman e Athanasopoulos, §7.3).
Porque muda a incerteza? Para uma média, a conta explicita o problema:
\[ \operatorname{Var}(\bar\varepsilon)=\frac{1}{n^2} \left[\sum_i\operatorname{Var}(\varepsilon_i) +2\sum_{i<j}\operatorname{Cov}(\varepsilon_i,\varepsilon_j)\right]. \]
Aqui, \(\operatorname{Cov}\) mede como dois erros variam em conjunto. A fórmula para erros independentes omite a segunda soma. Se as covariâncias forem positivas, essa omissão subestima a variância da média. Cem dias consecutivos podem trazer informação parcialmente repetida. Para declives e contrastes, a consequência depende também da organização dos preditores; não existe uma correcção única baseada apenas no número de linhas.
A condição de média zero dos erros para cada configuração dos preditores pode continuar a justificar coeficientes OLS sem viés mesmo com erros correlacionados. O cálculo usual dos erros-padrão é que deixa de representar a sua variabilidade. Podemos precisar de um modelo temporal, de representar agrupamentos com modelos mistos ou de uma estimativa da covariância apropriada à dependência. HC3 foi concebido para heterocedasticidade; não representa automaticamente estas covariâncias. E nenhuma alteração do erro-padrão cria replicação experimental em falta.
Um teste de autocorrelação investiga certas associações ao longo da ordem escolhida. A ausência dessas associações não certifica independência geral. Nem precisamos de uma ordem temporal para ter dependência: observações de um mesmo tanque podem partilhar variação mesmo que a tabela esteja ordenada alfabeticamente. Baralhar as linhas não muda o processo que as produziu.
Se os momentos necessários existirem, independência implica correlação zero. A implicação inversa não vale em geral. Se \(Z\) for normal padrão, \(Z\) e \(Z^2-1\) têm correlação zero, mas conhecer \(Z\) determina o segundo valor. São dependentes.
Sob normalidade conjunta, covariância zero implica independência. Ter apenas distribuições marginais normais não chega (Taboga, 2021; normalidade marginal e conjunta). Esta diferença explica por que a informação do delineamento continua indispensável mesmo quando um diagnóstico de correlação não assinala nada.
Os mínimos quadrados dão muito peso a resíduos grandes, porque os elevam ao quadrado. Também um ponto isolado numa extremidade dos preditores pode ter um papel decisivo na orientação da recta. Vale a pena perceber quanto da nossa conclusão depende de casos particulares.
Uma observação pode ser extrema numa variável, ter um resíduo grande ou ter muita alavancagem, por ocupar uma combinação pouco comum de preditores. A influência descreve quanto muda o ajuste quando alteramos a contribuição dessa observação. Estes conceitos podem apontar para animais diferentes.
Num exemplo hipotético, um peixe muito grande segue perfeitamente a relação esperada entre comprimento e massa. Outro tem comprimento corrente, mas uma massa muito afastada da previsão: tem um resíduo grande. Um terceiro é o único na extremidade dos comprimentos e pode determinar boa parte do declive. A distância de Cook ajuda a investigar influência, mas um limiar serve para chamar a atenção, não para decidir uma exclusão (vignette de performance).
«Não ter outliers» não é um pressuposto formal adicional do modelo linear. Até uma população normal produz casos afastados do centro. A questão é saber se o caso pertence ao processo que queremos estudar, se foi medido correctamente e se a conclusão é estável perante a sua contribuição.
O primeiro trabalho é recuperar a proveniência: unidade de medida, registo original, identidade, calibração, data e critérios de inclusão. Um erro verificado pode ser corrigido de forma documentada. Um caso legítimo pode revelar uma condição rara, outro processo ou uma cauda que a população realmente tem.
Depois comparamos o contraste, os declives, as previsões e os intervalos com e sem esse caso, identificando a exclusão como análise de sensibilidade. Um estimador robusto pode acrescentar outra comparação útil. Se a conclusão muda bastante, precisamos de compreender e relatar essa dependência. Apagar o caso só porque muda o valor-p esconderia a informação mais importante que o diagnóstico acabou de nos dar.
Podemos agora voltar aos nomes familiares. As diferenças entre listas de pressupostos tornam-se mais fáceis de compreender quando escrevemos a resposta, as previsões e a estrutura dos erros de cada análise.
O modelo y ~ 1 estima um único intercepto e faz a mesma previsão para todas as unidades. No teste-t de uma amostra, comparamo-lo com a previsão fixada pelo valor de referência. Como só subtraímos uma constante, a normalidade da resposta nessa população equivale à normalidade dos erros.
Não temos dois conjuntos de previsões cujas dispersões comparar com Levene, nem vários preditores entre os quais procurar colinearidade. A independência entre unidades continua a importar. E uma só previsão pode esconder subpopulações ou períodos com dispersões diferentes: a simplicidade da fórmula não garante a simplicidade do processo.
No teste-t emparelhado, a resposta analisada é a diferença dentro de cada par. Se medimos o mesmo animal antes e depois de uma intervenção, definimos \(D_i=Y_{i,\mathrm{depois}}-Y_{i,\mathrm{antes}}\) e ajustamos um modelo só com intercepto a \(D_i\). Testamos se precisamos de uma previsão diferente de zero para essa mudança.
A normalidade relevante para o teste exacto é a das diferenças. A dependência entre as duas medições do animal entra na análise através da própria subtracção. A independência a justificar é entre pares: dez animais no mesmo aquário podem continuar a partilhar condições depois de calcularmos uma diferença por animal.
A variância da diferença mostra como a dependência interna é incorporada:
\[ \operatorname{Var}(D)=\operatorname{Var}(Y_{\mathrm{depois}}) +\operatorname{Var}(Y_{\mathrm{antes}}) -2\operatorname{Cov}(Y_{\mathrm{depois}},Y_{\mathrm{antes}}). \]
Não precisamos de exigir duas distribuições marginais normais nem igualdade das variâncias antes e depois. Precisamos de representar correctamente os pares e a distribuição da resposta que efectivamente analisamos. Veja o caso pré–pós para a ligação ao modelo de medidas repetidas.
Um contraste −1/+1 permite duas previsões. Libertar o seu coeficiente faz passar de uma previsão comum para duas, iguais às médias amostrais dos grupos. O declive desse contraste é metade da diferença entre as previsões. Comparar y ~ 1 com y ~ grupo através de lm() e anova() testa se precisamos de o libertar. A inferência clássica usa uma variância residual comum: é a mesma estimativa usada no teste-t de Student.
Se as variâncias diferirem, podemos manter o interesse nessa diferença, mas precisamos de reconsiderar o cálculo da incerteza. O procedimento de Welch, apresentado na página de Estatística Robusta, faz essa alteração para grupos independentes.
Os vários contrastes de um factor permitem várias previsões discretas. No factorial completo, com todas as interacções e parâmetros estimáveis, chegamos às médias das células. A comparação clássica usa uma variância residual comum para avaliar a redução do erro ao libertar os contrastes. As alternativas para variâncias desiguais são discutidas em Estatística Robusta.
Acrescentar um preditor quantitativo faz variar a previsão também ao longo desse eixo. Na ANCOVA aditiva, impomos o mesmo declive em todas as combinações dos factores: é a habitual «homogeneidade dos declives». A interacção com a covariável liberta essa restrição. Passamos a estudar como muda a diferença entre previsões ao longo da covariável, em vez de resumir tudo numa única diferença ajustada.
Nos modelos de medidas repetidas precisamos ainda de representar a covariância dentro da unidade. A esfericidade da ANOVA intra-sujeitos é uma condição específica sobre variâncias das diferenças. A página de medidas repetidas desenvolve essa condição e as alternativas; ela não é um requisito universal de toda a regressão.
Certas questões desaparecem das listas porque a estrutura já as resolveu. Um único preditor numérico não constante com intercepto tem posto completo; não há outro preditor explicativo com que separar o seu contributo. Se acrescentarmos \(x^2\), passamos a ter mais colunas, mesmo partindo da mesma variável original. Com um factor de dois níveis, duas previsões livres reproduzem quaisquer dois pontos. Só esses níveis não dão informação para identificar curvatura.
Num factorial completo e equilibrado, os contrastes centrados permitem separar a informação dos vários termos sem sobreposição linear entre eles (a ortogonalidade). Isto ajuda a compreender por que a multicolinearidade costuma ocupar pouco espaço nessa apresentação da ANOVA. Desequilíbrio, células vazias e covariáveis obrigam a reexaminar a geometria do modelo. A estrutura também pode apoiar a independência: unidades amostradas independentemente e medidas uma vez dão uma justificação diferente de várias medições do mesmo animal. Em cada caso, precisamos de perceber o que já foi assegurado e o que continua por justificar.
Na comparação clássica entre dois modelos aninhados, ajustados às mesmas \(n\) observações, calculamos
\[ F=\frac{(SSE_0-SSE_1)/(k_1-k_0)}{SSE_1/(n-k_1)}, \]
com \(k_0\) e \(k_1\) coeficientes independentes nos modelos compacto e aumentado. A redução do erro por parâmetro libertado é comparada com o erro residual por grau de liberdade. Sob a hipótese nula e as condições Gaussianas clássicas, esta razão segue uma distribuição \(F_{k_1-k_0,n-k_1}\). É isso que permite interpretar a dimensão da melhoria relativamente à variação que esperaríamos sob a restrição.
Reunimos média bem especificada, posto completo, erros de média zero, independentes, normais e com variância comum. Precisamos ainda de graus de liberdade residuais para estimar essa variância: com \(n\) observações e \(k_1\) coeficientes independentes, restam \(n-k_1\). Um modelo saturado para as médias das células pode ter muitas observações por célula e deixar graus de liberdade residuais. Ajustar exactamente cada observação sem deixar graus de liberdade já não permite estimar a variância residual dessa forma.
A tabela resume onde entram as condições. Serve para regressar à pergunta que uma irregularidade realmente põe em causa.
| Questão | O Que Está Principalmente Em Jogo? |
|---|---|
| A média deixa estrutura sistemática por explicar | significado dos coeficientes e adequação das previsões; possível viés relativamente ao parâmetro pretendido |
| Erros não normais | distribuições exactas dos testes e intervalos clássicos; distribuição de novas observações |
| Variâncias desiguais com média bem especificada | erros-padrão usuais e eficiência, não viés automático de OLS |
| Erros correlacionados | informação disponível e matriz de covariância da inferência |
| Colinearidade perfeita | identificação dos coeficientes ou contrastes pretendidos |
| Multicolinearidade elevada | precisão e estabilidade das estimativas parciais |
| Observações influentes | sensibilidade das estimativas e conclusões a casos particulares |
Outras estratégias permitem relaxar algumas condições e obter garantias diferentes. É preciso escolher a estratégia pelo problema: um erro-padrão que admite variâncias diferentes pode bastar para a incerteza de um declive bem especificado; uma curva sistemática nos resíduos pede que reconsideremos a relação média. Mudar a fórmula da incerteza não muda a recta que ajustámos.
Vejamos agora a tradução entre previsões e médias por célula com a massa dos pinguins. Ajustamos os contrastes de espécie, sexo e a sua interacção. Este modelo permite uma previsão livre por combinação espécie × sexo; vamos verificar que são as médias amostrais e que subtraí-las preserva as variâncias dentro de cada célula.
Usamos palmerpenguins e ggplot2. Pode abrir os blocos de código para acompanhar as contas.
library(ggplot2)
library(palmerpenguins)
options(contrasts = c("contr.sum", "contr.poly"))
vars <- c("body_mass_g", "species", "sex")
data <- penguins[complete.cases(penguins[, vars]), vars]Primeiro contamos as observações por célula; depois comparamos os valores ajustados com as médias e as variâncias antes e depois de centrar.
cell_data <- data
cell_data$cell <- interaction(cell_data$species, cell_data$sex, drop = TRUE)
with(cell_data, table(species, sex))
sex
species female male
Adelie 73 73
Chinstrap 34 34
Gentoo 58 61[1] 7.730705e-12| cell | body_mass_g | residual |
|---|---|---|
| Adelie.female | 72565.64 | 72565.64 |
| Chinstrap.female | 81415.44 | 81415.44 |
| Gentoo.female | 79286.34 | 79286.34 |
| Adelie.male | 120278.25 | 120278.25 |
| Chinstrap.male | 131143.61 | 131143.61 |
| Gentoo.male | 98068.31 | 98068.31 |
A primeira diferença é zero salvo erro numérico. Em cada linha da tabela, a variância da massa e a do resíduo coincidem: retirámos uma constante a todos os valores dessa célula. As variâncias podem, contudo, ser diferentes entre linhas. A homoscedasticidade refere-se à igualdade das variâncias populacionais entre condições, não à igualdade entre uma variável e a sua versão centrada.
Pela mesma razão, o teste de Levene centrado na mediana dá o mesmo resultado com massas ou resíduos neste modelo por células, sem covariáveis. O NIST descreve o teste como uma comparação de variâncias entre grupos discretos. Não responde, por exemplo, à pergunta sobre curvatura da relação média.
Para investigar a forma por célula, usamos os mesmos resíduos:
ggplot(cell_data, aes(sample = residual)) +
  stat_qq(alpha = 0.55) +
  stat_qq_line() +
  facet_wrap(~ cell, scales = "free") +
  theme_classic() +
  labs(x = "Theoretical normal quantiles", y = "Cell residual quantiles")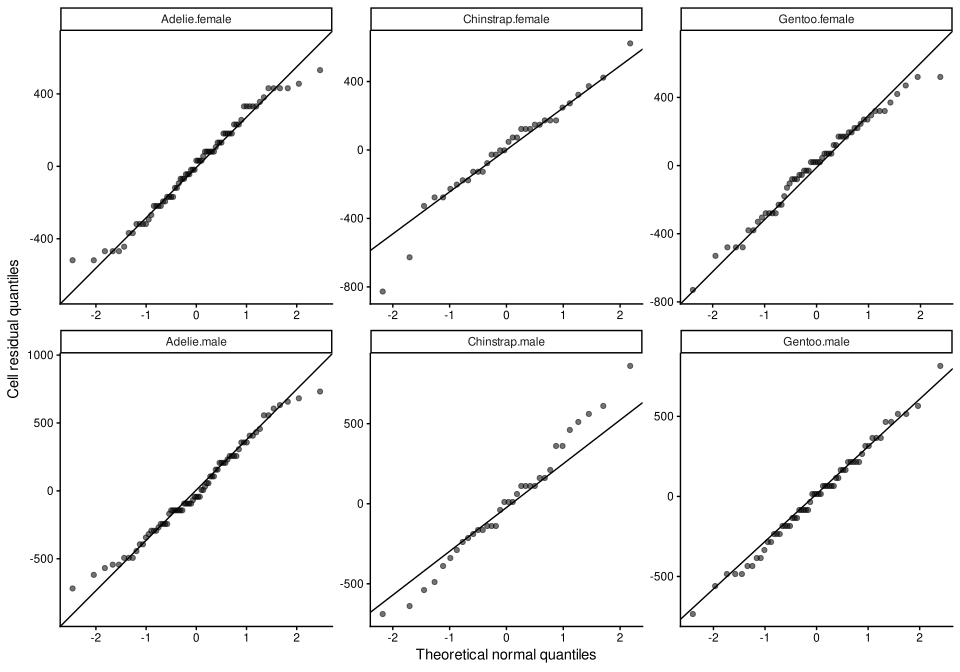
Cada painel tem a sua escala para facilitar a comparação da forma. Para comparar dispersões, usaríamos uma escala comum. Nas células pequenas, a leitura das caudas fica limitada pelos poucos pontos disponíveis.
Esta centragem corresponde às previsões do modelo que ajustámos. Se retirarmos interacções ou acrescentarmos covariáveis, voltamos a calcular os resíduos a partir das novas previsões. Centrá-los outra vez por célula apagaria parte da estrutura que estamos a tentar diagnosticar.
O diagnóstico interessa porque queremos confiar numa conclusão e porque os padrões podem ensinar-nos alguma coisa. Um funil pode alterar sobretudo a incerteza de um declive agregado. Pode também acompanhar relações diferentes que merecem ser estudadas. Uma sequência temporal pode mostrar que contámos informação repetida como nova. Um caso influente pode levar-nos de volta ao caderno de campo, onde uma unidade de medida ficou por converter.
O percurso começa antes de abrir os gráficos. Definimos a pergunta, a unidade, a população ou processo, os contrastes de interesse e a estrutura de dependência esperada. Depois podemos trabalhar sobre cada sinal:
Voltemos ao exemplo dos declives por sexo. Se a pergunta já era saber se a relação muda com o sexo, a interacção traduz directamente essa pergunta. O funil dá-nos informação adicional sobre o que acontece ao impor um só declive. Se a ideia surgiu apenas depois de observar o gráfico, podemos explorá-la, estimar a diferença e aprender com o ajuste.
Nos dois casos interessa examinar se o padrão já ocorreu noutros dados, se era esperado pelo mecanismo e se os dois grupos cobrem a região do preditor onde estamos a comparar declives. Uma interacção ajustada aos mesmos dados que sugeriram a hipótese não é uma confirmação independente da explicação. Precisamos de distinguir a evidência de inadequação do modelo inicial da evidência que favorece uma causa específica.
Uma previsão bem definida pode ser avaliada em dados novos ou numa parte reservada que não tenha sido usada para escolher o modelo. Podemos pré-especificar o contraste entre declives, a região do preditor, as medições e a regra de avaliação. Se a amostra for pequena demais para a dividir, apresentamos a hipótese como exploratória e planeamos a recolha seguinte. Descobrir uma pergunta que vale a pena testar já é trabalho científico útil.
Métodos robustos ajudam a avaliar uma conclusão com menor dependência de condições frágeis. Se a relação agregada é o alvo e a média continua adequada, HC3 permite tratar variâncias diferentes no cálculo da incerteza. Se poucos casos dominam o ajuste, um estimador robusto pode mostrar quanto o declive depende dessa influência. A dependência temporal exige uma estratégia que represente as covariâncias relevantes.
Compreender a origem do padrão pode levar-nos mais longe. Uma interacção permite estudar heterogeneidade da relação; representar persistência pode melhorar previsão; recuperar o registo original pode corrigir um erro de medição. A alternativa estatística e a investigação substantiva podem acompanhar-se, porque respondem a partes diferentes do problema.
Ao regressar à tabela de resultados, queremos conseguir explicar que restrição comparámos, o que estimam os coeficientes e por que acreditamos na incerteza apresentada. O tutorial de Pressupostos e Diagnóstico ajuda a investigar os sinais no R. Estatística Robusta permite aprofundar as mudanças no estimador, na incerteza e na reamostragem.
A distribuição das diferenças é a relevante para a normalidade do teste exacto. A análise incorpora a dependência entre as duas medições do mesmo par. Precisamos de justificar independência entre pares; animais no mesmo tanque ou pessoas do mesmo agregado podem exigir uma estrutura adicional.
Aprendemos que permitir declives diferentes representa parte da estrutura que o modelo anterior deixava nos resíduos. Podemos examinar a magnitude e a incerteza da diferença entre declives. Se a hipótese surgiu ao olhar para estes dados, a melhoria do ajuste é evidência exploratória. Precisamos de verificar medição, cobertura dos preditores e explicações rivais, e testar a previsão em dados novos ou efectivamente reservados antes de a tratar como confirmada. A associação também não estabelece, por si só, causalidade.
HC3 permite heterocedasticidade no cálculo da incerteza sem alterar os coeficientes OLS. A regressão robusta altera a contribuição das observações para a estimação. A divergência convida a investigar quais os casos e padrões que influenciam o declive e se as análises continuam a representar o mesmo alvo. Não escolhemos o resultado pelo intervalo que mais nos convém.