Limpeza de Bases de Dados
0 Limpar É Decidir
Dados reais raramente chegam prontos para análise. Podemos receber linhas acrescentadas pelo programa de exportação ou uma folha com espaços vazios no fim. Antes de retirar qualquer coisa, precisamos de perceber o que representa cada linha e por que razão deve ficar ou sair.
Nas aulas práticas, a base de dados costuma chegar arranjadinha. Fora delas, alguém teve de a arranjar primeiro — e esse alguém podemos ser nós. Se hoje passarmos mais tempo a preparar os dados do que a analisá-los, não estamos necessariamente a fazer alguma coisa mal.
Vamos trabalhar com dois ficheiros: uma base de demonstração de psicologia e uma tabela com medidas de briozoários. Em cada exemplo, começamos por ler e explorar os dados, escolhemos uma transformação e guardamos o resultado num ficheiro separado. No fim de cada caso, juntamos os passos num script curto que podemos voltar a executar.
Use a consola para experimentar e olhar para os resultados. Depois de confirmar uma transformação, conserve-a no script, com um comentário que explique a decisão. As consultas que fez para explorar não precisam de acompanhar todas as execuções. Se mudar o ficheiro ou o critério, volte a inspeccionar o resultado.
Da Consola ao Script
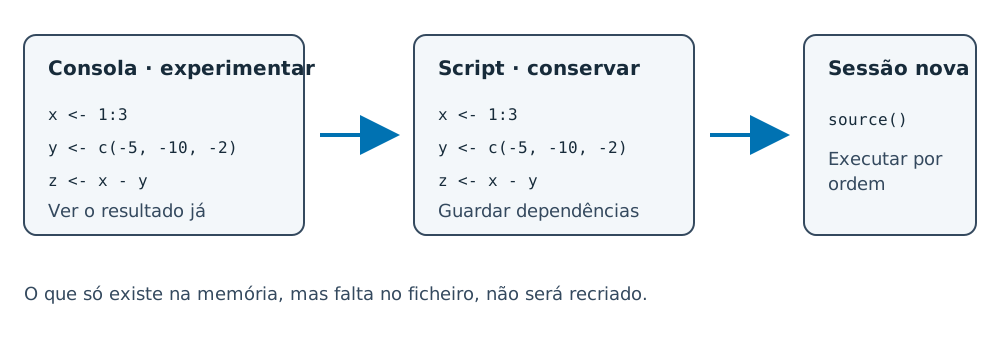
Podemos experimentar os passos na consola e ver logo o resultado:
Se copiarmos apenas x, z e print(z) para um script, y fica de fora. Na consola, o cálculo continua a funcionar enquanto y existir na sessão; o script falha numa sessão nova, porque nunca criou esse objecto. O ficheiro tem de registar as dependências na ordem em que são usadas:
x <- 1:3
z <- x - y
print(z)
Numa sessão sem um objecto y, a segunda linha dá erro.
No RStudio, o painel Environment mostra os objectos da sessão e deixa-nos removê-los com o ícone da vassoura. Isso ajuda a testar se um script depende de objectos que criámos à mão, mas não apaga todo o estado do R nem verifica por si só a execução por ordem. Antes de dar o trabalho por terminado, reinicie o R sem restaurar a sessão ou carregar .RData e execute o script completo. Veja a documentação oficial dos painéis e do Environment.
Preparar os Ficheiros
Precisamos das operações apresentadas nos tutoriais de data.frames e de importação. Se ainda hesita na leitura de uma linha de código, execute-a separadamente e veja o resultado antes de continuar.
Descarregue demo_ds.csv e bryozoan_raw.csv para a pasta data do seu projecto. Os exemplos supõem que trabalhamos a partir de uma pasta programming, ao lado de data, como na preparação do tutorial de importação. Assim, ../data/demo_ds.csv significa: subir uma pasta (..), entrar em data e abrir demo_ds.csv. Se a sua organização for outra, ajuste os caminhos de leitura e de escrita.
Vamos usar dplyr e, na selecção de casos completos, tidyr. Se necessário, instale-os uma vez na consola, fora do script, como explicado na referência de pacotes. Carregamos os pacotes no início; não é preciso voltar a instalá-los sempre que começamos uma análise.
1 Psicologia: Consentimento e Idade
O ficheiro demo_ds.csv contém 120 linhas, uma por participante, com idade, consentimento e outras variáveis. Para este exercício, vamos imaginar um protocolo que inclui apenas pessoas que consentiram e têm pelo menos 18 anos. É um critério ilustrativo, não uma descrição do protocolo original desta base nem uma regra para todos os estudos. Num estudo real, teríamos de consultar o respectivo protocolo.
Começamos por carregar o pacote e ler o ficheiro:
Na consola, escrever ds imprime a tabela; head(ds) mostra apenas as primeiras linhas. Para tabelas grandes, usamos head(ds) como pré-visualização. nrow() conta as linhas:
head(ds)| pp_number | consents | age | gender | cond | mood | rts | phase1 | phase2 | lab |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Yes | 19 | female | high | 31 | 2106 | 18 | 80 | B |
| 2 | Yes | 23 | female | high | 25 | 2249 | 27 | 83 | A |
| 3 | Yes | 41 | female | high | 28 | 3248 | 23 | 95 | B |
| 4 | Yes | 26 | female | high | 29 | 1931 | 30 | 81 | A |
| 5 | Yes | 26 | female | high | 39 | 2410 | 28 | 88 | B |
| 6 | Yes | 42 | female | high | 27 | 3451 | 18 | 89 | A |
nrow(ds)[1] 120A tabela permite reconhecer os nomes das colunas e os valores usados. consents contém "Yes" e "No"; age contém a idade. A contagem devolve 120.
Aplicamos agora o critério escolhido:
# Illustrative protocol: include consenting adults only.
ds <- filter(ds, consents == "Yes", age >= 18)
filter() conserva linhas. O primeiro argumento, ds, é a tabela a filtrar. consents == "Yes" procura exactamente esse texto, e age >= 18 exige uma idade maior ou igual a 18. As duas condições, separadas por vírgulas, têm de ser satisfeitas. O resultado é atribuído a ds, que passa a conter apenas as linhas seleccionadas. Isto muda o objecto no R; não altera o CSV que lemos.
Voltamos à consola para ver o que ficou:
head(ds)| pp_number | consents | age | gender | cond | mood | rts | phase1 | phase2 | lab |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Yes | 19 | female | high | 31 | 2106 | 18 | 80 | B |
| 2 | Yes | 23 | female | high | 25 | 2249 | 27 | 83 | A |
| 3 | Yes | 41 | female | high | 28 | 3248 | 23 | 95 | B |
| 4 | Yes | 26 | female | high | 29 | 1931 | 30 | 81 | A |
| 5 | Yes | 26 | female | high | 39 | 2410 | 28 | 88 | B |
| 6 | Yes | 42 | female | high | 27 | 3451 | 18 | 89 | A |
nrow(ds)[1] 118Ficaram 118 participantes. Saíram dois, ambos com "No" em consents. Neste ficheiro, todas as idades são pelo menos 18, pelo que o critério de idade não retira ninguém. Ter escrito uma condição não significa que ela tenha necessariamente de excluir casos.
filter() mantém apenas condições com resultado TRUE. Se faltasse a idade ou o consentimento, não conseguiríamos confirmar a inclusão e a linha também ficaria de fora com este filtro. Isso faz parte do critério deste exemplo; não é uma indicação para apagar todos os valores em falta de uma base de dados.
Guardar o Resultado
Vamos guardar a versão limpa em ../data/demo_clean.csv, com um nome diferente do ficheiro recebido. Execute a escrita quando tiver confirmado o resultado. Os blocos de escrita e os scripts completos não são executados automaticamente nesta página.
write.csv(ds, "../data/demo_clean.csv", row.names = FALSE)write.csv() recebe a tabela e o caminho do ficheiro de destino. row.names = FALSE evita escrever uma coluna extra com os números das linhas do R. O identificador pp_number, que já pertence aos dados, continua a ser guardado.
A escrita não imprime habitualmente uma tabela nem uma mensagem de sucesso. Procure o ficheiro na pasta indicada. Para o voltar a ler, podemos experimentar na consola:
read.csv("../data/demo_clean.csv")Se voltar a executar write.csv() com o mesmo caminho, o ficheiro de destino é substituído, não recebe as novas linhas no fim. Confirme o nome antes de escrever. Aqui, demo_ds.csv é apenas lido e demo_clean.csv é a saída: o original fica preservado.
Os exemplos usam a pasta data, que já existe. Se preferir uma pasta results, crie-a uma vez, pelo gestor de ficheiros ou com dir.create("../results") na consola. Depois use, por exemplo, "../results/demo_clean.csv" na escrita. write.csv() cria o ficheiro, mas não cria a pasta onde o queremos guardar.
O Script Completo
Depois da exploração, guardamos estes passos em clean_demo.R. Este script é autónomo: lê o ficheiro recebido, aplica o critério e escreve a saída. Execute-o de cima para baixo a partir da pasta programming, com o pacote já instalado.
Não copiámos todas as consultas da consola. Ficaram os passos que queremos repetir e a explicação do critério. Para recomeçar a limpeza, voltamos a ler o original, em vez de continuar a filtrar uma versão já reduzida.
2 Biologia: Linhas Vazias no Fim
O ficheiro bryozoan_raw.csv contém medidas de estádio, corrida (RUN), massa e taxa metabólica em log10 para Bugula e Watersipora. As duas espécies estão em blocos de colunas lado a lado, mas têm números diferentes de registos. Uma linha da folha original não deve ser interpretada como um par de organismos das duas espécies. Vamos preparar apenas o bloco de Watersipora.
Começamos novamente pelo ficheiro recebido:
ds <- read.csv("../data/bryozoan_raw.csv")Na consola, vemos os nomes das colunas, algumas linhas finais e o número de linhas:
names(ds)[1] "BUGULA.STAGE" "BUGULA.RUN" "BUGULA.LOG10MASS"
[4] "BUGULA.LOG10MR" "WATERSIPORA.STAGE" "WATERSIPORA.RUN"
[7] "WATERSIPORA.LOG10MASS" "WATERSIPORA.LOG10MR" tail(ds)| BUGULA.STAGE | BUGULA.RUN | BUGULA.LOG10MASS | BUGULA.LOG10MR | WATERSIPORA.STAGE | WATERSIPORA.RUN | WATERSIPORA.LOG10MASS | WATERSIPORA.LOG10MR | |
|---|---|---|---|---|---|---|---|---|
| 530 | LATE | 12 | -0.9563585 | -0.3968164 | NA | NA | NA | |
| 531 | LATE | 12 | -0.8670110 | -0.3029143 | NA | NA | NA | |
| 532 | LATE | 12 | -0.8027612 | -0.4486721 | NA | NA | NA | |
| 533 | LATE | 12 | -0.8188841 | -0.3085966 | NA | NA | NA | |
| 534 | LATE | 12 | -0.8499565 | -0.2873348 | NA | NA | NA | |
| 535 | LATE | 12 | -0.6472585 | -0.3400670 | NA | NA | NA |
nrow(ds)[1] 535Há 535 linhas. No fim, as colunas de Bugula ainda têm valores, mas as quatro de Watersipora estão vazias. Ao importar, read.csv() trocou os espaços dos nomes por pontos: por exemplo, WATERSIPORA STAGE passou a WATERSIPORA.STAGE.
Vamos seleccionar as quatro colunas que nos interessam e dar-lhes nomes mais curtos:
ds <- select(
  ds,
  stage = WATERSIPORA.STAGE,
  run = WATERSIPORA.RUN,
  log10mass = WATERSIPORA.LOG10MASS,
  log10mr = WATERSIPORA.LOG10MR
)
select() escolhe colunas, enquanto filter() escolhe linhas. Em stage = WATERSIPORA.STAGE, o nome à esquerda é o novo nome e o da direita é o que existe na tabela. Não estamos a transformar as medidas: massa e taxa metabólica continuam em log10.
Na consola, olhamos para o início, para a passagem aos espaços vazios e para o fim:
head(ds)| stage | run | log10mass | log10mr |
|---|---|---|---|
| LARVAE | 1 | 1.255952 | -0.0615924 |
| LARVAE | 1 | 1.289612 | -0.0926305 |
| LARVAE | 1 | 1.403698 | -0.1224853 |
| LARVAE | 1 | 1.313851 | -0.2449149 |
| LARVAE | 1 | 1.289418 | 0.0110419 |
| LARVAE | 1 | 1.200366 | -0.2453349 |
ds[286:290, ]| stage | run | log10mass | log10mr | |
|---|---|---|---|---|
| 286 | LATE | 4 | 0.9647995 | -0.0611179 |
| 287 | LATE | 4 | 1.2417616 | 0.0861945 |
| 288 | LATE | 4 | 1.3260743 | 0.0842882 |
| 289 | NA | NA | NA | |
| 290 | NA | NA | NA |
tail(ds)| stage | run | log10mass | log10mr | |
|---|---|---|---|---|
| 530 | NA | NA | NA | |
| 531 | NA | NA | NA | |
| 532 | NA | NA | NA | |
| 533 | NA | NA | NA | |
| 534 | NA | NA | NA | |
| 535 | NA | NA | NA |
nrow(ds)[1] 535Em ds[286:290, ], 286:290 indica as linhas de 286 a 290 e o espaço depois da vírgula mantém todas as colunas. A linha 288 ainda contém um registo de Watersipora. Da linha 289 até à 535, as quatro colunas deste bloco estão vazias no CSV. Na coluna de texto stage, a célula vazia entrou como "", uma cadeia sem caracteres. Nas três colunas numéricas, entrou como NA.
Aqui, os espaços finais servem para acomodar o bloco mais comprido de Bugula. Não representam organismos de Watersipora com medições em falta. Depois de separar as espécies, podemos retirar esse espaço excedente. Neste ficheiro, stage != "" identifica os registos que queremos conservar:
# In this file, an empty stage marks trailing blanks in all four columns.
ds <- filter(ds, stage != "")
!= significa «diferente de». Na consola, verificamos o resultado:
tail(ds)| stage | run | log10mass | log10mr | |
|---|---|---|---|---|
| 283 | LATE | 4 | 1.1168236 | -0.3075448 |
| 284 | LATE | 4 | 1.2673961 | 0.0561269 |
| 285 | LATE | 4 | 1.1136121 | -0.0939138 |
| 286 | LATE | 4 | 0.9647995 | -0.0611179 |
| 287 | LATE | 4 | 1.2417616 | 0.0861945 |
| 288 | LATE | 4 | 1.3260743 | 0.0842882 |
nrow(ds)[1] 288Ficaram 288 registos e saíram 247 linhas de preenchimento. O último registo tem stage igual a "LATE" e run igual a 4. Não excluímos observações biológicas por terem valores extremos ou por prejudicarem uma análise.
Este filtro depende da estrutura que acabámos de inspeccionar. Uma linha com organismo identificado e uma medição em falta continua a representar uma observação. Não a devemos confundir com estas linhas inteiramente vazias do bloco de Watersipora. Noutro ficheiro, um estádio em falta pode coexistir com medidas válidas; nessa situação, filtrar apenas por stage não seria uma forma adequada de reconhecer linhas vazias. Consulte o registo da recolha antes de decidir.
O Script Completo
Guardamos os passos em clean_watersipora.R. Tal como no primeiro caso, o destino é separado do original. A pasta e os caminhos são os mesmos que preparámos no início.
library(dplyr)

ds <- read.csv("../data/bryozoan_raw.csv")
ds <- select(
  ds,
  stage = WATERSIPORA.STAGE,
  run = WATERSIPORA.RUN,
  log10mass = WATERSIPORA.LOG10MASS,
  log10mr = WATERSIPORA.LOG10MR
)

# In this file, an empty stage marks trailing blanks in all four columns.
ds <- filter(ds, stage != "")

write.csv(ds, "../data/watersipora_clean.csv", row.names = FALSE)
O ficheiro watersipora_clean.csv terá 288 linhas de dados e quatro colunas. Se o voltar a guardar com o mesmo nome, substitui essa saída; bryozoan_raw.csv continua intacto.
3 Valores Completos
Podemos precisar de linhas com valores em todas as variáveis de uma análise, sem exigir que a base inteira esteja completa. drop_na(), do pacote tidyr carregado no início, permite indicar essas colunas directamente. Vejamos uma pequena tabela inventada, com uma linha por espécime:
ds <- data.frame(
  specimen_id = 1:4,
  length_mm = c(12, NA, 15, 18),
  mass_g = c(8, 9, NA, 12)
)
ds| specimen_id | length_mm | mass_g |
|---|---|---|
| 1 | 12 | 8 |
| 2 | NA | 9 |
| 3 | 15 | NA |
| 4 | 18 | 12 |
Para trabalhar com comprimento e massa, seleccionamos os casos com ambas as medições. Guardamos este subconjunto em voi (values of interest), sem alterar a tabela principal ds:
voi <- drop_na(ds, length_mm, mass_g)
voi| specimen_id | length_mm | mass_g |
|---|---|---|
| 1 | 12 | 8 |
| 4 | 18 | 12 |
Ficam os espécimes 1 e 4. A função conserva todas as colunas, incluindo o identificador; os nomes que indicámos servem para escolher linhas, não para escolher colunas.
Se apenas o comprimento entrar na análise, basta exigir essa medição:
voi <- drop_na(ds, length_mm)
voi| specimen_id | length_mm | mass_g |
|---|---|---|
| 1 | 12 | 8 |
| 3 | 15 | NA |
| 4 | 18 | 12 |
Agora fica também o espécime 3, embora não tenha massa registada. Não precisamos de excluir alguém por faltar uma variável que não vamos usar.
Podemos também escolher primeiro as colunas e depois retirar os casos incompletos nessa selecção:
Sem nomes de colunas, drop_na() verifica todas as colunas da tabela que recebe. Aqui recebe apenas comprimento e massa, por isso voltam a ficar duas linhas, agora sem a coluna do identificador. Use select() apenas se quiser mesmo retirar as outras colunas.
Estes comandos não explicam por que faltam valores nem tornam a exclusão inofensiva. Antes de os incluir no script, investigue os omissos e registe que variáveis e quantos casos determinaram a selecção. Além disso, drop_na() retira NA, não texto vazio como "": as linhas de preenchimento do exemplo anterior exigiram reconhecer a estrutura do ficheiro.
4 Outros Ficheiros Recebidos
Os dois ficheiros exigiram decisões diferentes. No primeiro, aplicámos um critério de inclusão de participantes. No segundo, retirámos espaço vazio da estrutura de uma folha. A justificação deve acompanhar o código, mesmo quando a operação ocupa apenas uma linha.
O ficheiro raw_qualtrics.csv tem outro problema de estrutura: duas linhas de metadados depois dos nomes das colunas. Contêm descrições das perguntas e identificadores de importação, não respostas de participantes. Se forem lidas como dados, o texto impede que várias colunas sejam interpretadas como números.
Com dplyr já carregado, lemos o ficheiro. Na consola, vemos as primeiras linhas e os tipos das colunas:
| consents | pp_age |
|---|---|
| Click to write the question text | Indique, por favor, a sua idade (utilize apenas números na resposta) |
| {“ImportId”:“QID1”} | {“ImportId”:“QID6_TEXT”} |
| Yes | 26 |
| Yes | 17 |
| No | |
| Yes | 19 |
str(qualtrics$pp_age) chr [1:6] "Indique, por favor, a sua idade (utilize apenas números na resposta)" ...nrow(qualtrics)[1] 6Entraram seis linhas: duas de metadados e quatro respostas. Depois de reconhecer os cabeçalhos extra, retiramo-los e convertemos a idade em números:
# The first two rows contain export metadata, not participant responses.
qualtrics <- qualtrics[-c(1, 2), ]
qualtrics$pp_age <- as.numeric(qualtrics$pp_age)
O sinal - retira as linhas indicadas; o espaço depois da vírgula mantém todas as colunas. as.numeric() converte a idade. Na consola, inspeccionamos os valores antes de escolher um filtro:
Vemos 26, 17, NA e 19, e a contagem é agora quatro. A célula vazia da idade passou a NA. Uma conversão pode também produzir NA se encontrar texto que não consegue interpretar como número: se houver um aviso ou valores inesperados, volte ao ficheiro recebido e descubra a causa antes de continuar. Retirar os metadados não converte automaticamente as colunas que já tinham sido lidas como texto.
Só depois aplicaríamos os critérios do estudo e guardaríamos a versão limpa num destino próprio, como nos dois exemplos anteriores. Um limiar de progresso do questionário, por exemplo, precisa de uma justificação do estudo; não é uma etapa obrigatória da limpeza.
Folhas de Cálculo Já Limpas
Podemos receber uma folha de cálculo já limpa manualmente. Pode ser o único formato recebido dum colaborador ou conter trabalho legítimo já realizado. Preserve o ficheiro tal como o recebeu e trabalhe numa cópia. Pergunte que linhas ou valores foram alterados e que regras foram usadas, documentando o que conseguir reconstruir.
Para trabalho novo ou repetido, um script permite voltar a executar as transformações e recuperar os critérios escolhidos. Ao conferir os resultados, podemos descobrir que escrevemos > quando queríamos >= ou que escolhemos a coluna errada. Guardar os passos e verificar o que produzem fazem parte da análise.
Se depois da limpeza precisar de reorganizar a tabela, continue com a (re)formatação de dados. Se a forma já servir a sua pergunta, pode passar às descritivas.
5 Exercícios
- Volte a ler
demo_ds.csv. Na consola, conte as linhas, aplique apenas o critérioage >= 18e conte outra vez. Explique por que razão a contagem não mudou. Depois acrescente o consentimento e confirme quantas pessoas ficam.
Solução 1 — Contagens e Consentimento
A contagem passa de 120 para 120 quando aplicamos apenas o critério de idade. Depois de incluir o consentimento, ficam 118 pessoas. A idade não exclui ninguém neste conjunto, enquanto o consentimento exclui duas observações.
- No exemplo de psicologia, o que mudaria se escrevêssemos
age > 18? Antes de executar o filtro, procure na tabela as pessoas com 18 anos. Explique qual dos filtros corresponde ao protocolo ilustrativo.
Solução 2 — Incluir os 18 Anos
O operador > retira também quem tem exactamente 18 anos. O protocolo ilustrativo usa >=, incluindo essas pessoas. Podemos confirmar quantas têm 18 anos com filter(ds, age == 18), depois de voltar a ler o ficheiro original.
- Reconstitua
clean_watersipora.Rsem copiar o bloco completo. Inspeccione o resultado na consola e guarde-o numa pasta de resultados. Explique por que razão as 247 linhas retiradas não são 247 organismos excluídos.
Solução 3 — Linhas Vazias de Watersipora
Esperamos 288 linhas e quatro colunas. As 247 linhas retiradas eram espaços vazios nas quatro colunas de Watersipora, numa folha cujo bloco de Bugula se prolongava até à linha 535. Não representam 247 organismos que foram excluídos do estudo.
- Uma tabela tem um organismo identificado, massa registada e taxa metabólica em falta. Devemos retirar a linha pelo mesmo motivo que as linhas finais de Watersipora? Que informação procuraria antes de decidir?
Solução 4 — Uma Medição em Falta
A linha representa uma observação identificada com uma medição em falta. Precisamos de saber por que falta a taxa metabólica e o que prevê o protocolo para a análise em causa. Não é equivalente a uma linha totalmente vazia no fim da folha. A decisão também depende de que variáveis vão entrar na análise.
- Execute um dos scripts a partir do ficheiro recebido. Abra o CSV de saída e confirme os nomes e o número de colunas. Explique para que serve
row.names = FALSEe o que acontece se executar a mesma escrita duas vezes.
Solução 5 — Verificar o Ficheiro Exportado
A saída de psicologia tem dez colunas e a de biologia quatro. row.names = FALSE evita uma coluna adicional com os números das linhas. Escrever uma segunda vez para o mesmo destino substitui o ficheiro de saída; não duplica as observações nem altera o original, desde que o destino seja diferente da entrada.
- Na tabela inventada de espécimes, compare
drop_na(ds, length_mm)comdrop_na(ds, length_mm, mass_g). Que espécimes ficam em cada caso? Qual das selecções permite estudar apenas o comprimento sem exigir massa?
Solução 6 — Escolher as Colunas Necessárias
Com apenas length_mm, ficam os espécimes 1, 3 e 4. Com comprimento e massa, ficam 1 e 4. Para uma análise só do comprimento, a primeira selecção não exige a medição de massa. Nenhuma das chamadas retira colunas da tabela; para isso usaríamos select().