[1] 500[1] 0Desenho Experimental e Análise Avançada de Dados Ecológicos
Como são estas observações?
N · valores em falta
Uma linha é um registo. Antes de resumir, confirmemos que observações representa e se há grupos ou medidas repetidas.
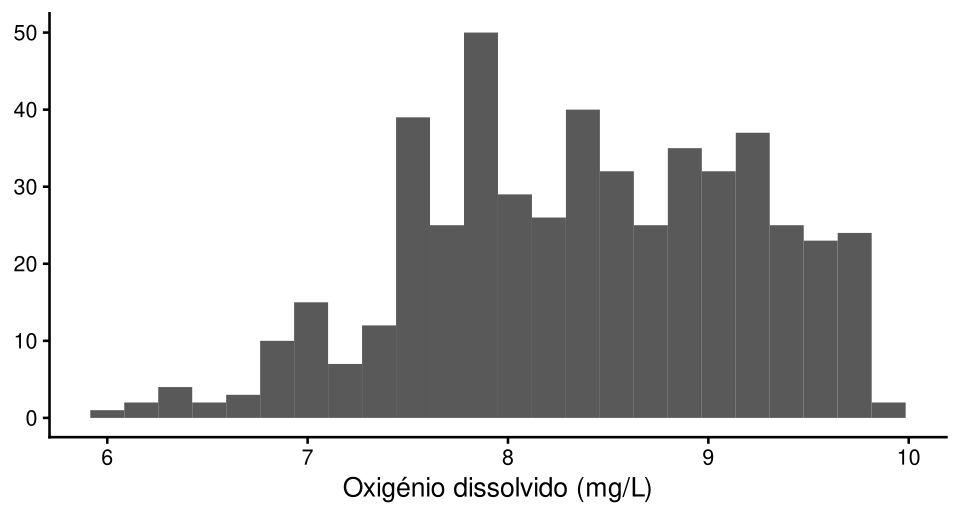
O gráfico mostra a distribuição dos valores observados. Ainda não é um modelo de probabilidades nem um teste.
média · mediana
5 · 5 · 6 · 6 · 18
Onde fica o centro?
\[ \bar{x}=\frac{1}{n}\sum_{i=1}^{n}x_i \]
somar todos os valores → dividir por \(n\)
Para 5 · 5 · 6 · 6 · 18:
\[ \bar{x}=\frac{5+5+6+6+18}{5}=8 \]
Todos os valores contribuem; um valor extremo pode deslocar a média.
Ordenar primeiro; depois encontrar a posição central.
Se \(n\) é ímpar:
\[ \tilde{x}=x_{((n+1)/2)} \]
Para 5 · 5 · 6 · 6 · 18, a mediana é 6.
Para 5 · 5 · 6 · 18 há dois valores centrais:
\[ \tilde{x}=\frac{x_{(n/2)}+x_{(n/2+1)}}{2} =\frac{5+6}{2}=5.5 \]
A mediana depende sobretudo das posições centrais.
5 · 5 · 6 · 6 · 100
O que acontece à média? E à mediana?
Q1 · mediana · Q3
\[ Q_1=Q_{.25}\qquad Q_2=Q_{.50}\qquad Q_3=Q_{.75} \]
Quantis são posições na distribuição ordenada; programas podem usar convenções de interpolação diferentes.
amplitude · IQR · variância · desvio-padrão
\[ R=x_{\max}-x_{\min} \]
Usa apenas os dois extremos.
\[ IQR=Q_3-Q_1 \]
Largura dos 50% centrais; menos sensível aos extremos do que a amplitude total.
Para cada observação:
\[ d_i=x_i-\bar{x} \]
Mas:
\[ \sum_{i=1}^{n}(x_i-\bar{x})=0 \]
Os desvios positivos e negativos anulam-se.
Elevamos os desvios ao quadrado:
\[ s^2=\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1} \]
desvio → quadrado → somar → dividir por \(n-1\)
O quadrado dá mais peso aos desvios grandes.
Voltamos às unidades originais:
\[ s=\sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}} \]
O SD resume a dispersão em torno da média e dá maior peso a observações mais afastadas.
assimetria · caudas · grupos · extremos
Numa distribuição unimodal com cauda à direita, é frequente:
moda < mediana < média
Cauda à esquerda → a ordem tende a inverter-se.
A média acompanha mais a cauda; a mediana depende das posições; a moda acompanha o pico.
bimodal / multimodal → várias modas possíveis
A regra média–mediana–moda deixa de descrever bem a forma. Olhem para a distribuição.
O coeficiente clássico usa o terceiro momento padronizado:
\[ g_1=\frac{m_3}{m_2^{3/2}}, \qquad m_r=\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^r \]
negativa ← 0 → positiva
O cubo conserva o sinal e dá muito peso aos valores afastados.
A kurtose clássica usa a quarta potência:
\[ b_2=\frac{m_4}{m_2^2} \]
normal: \(b_2=3\) · excesso de kurtose: \(g_2=b_2-3\)
É especialmente sensível às caudas e aos extremos; não é simplesmente «altura do pico».
mesma média ≠ mesmos dados
mesmo SD ≠ mesmos dados
mesma correlação ≠ mesma relação
mesma assimetria/kurtose ≠ mesma forma
Os números quantificam aspectos da distribuição. O gráfico mostra a sua estrutura.
Em 1973, Francis Anscombe construiu quatro conjuntos com praticamente os mesmos sumários numéricos.
O que esperariam ver se desenhássemos os quatro?
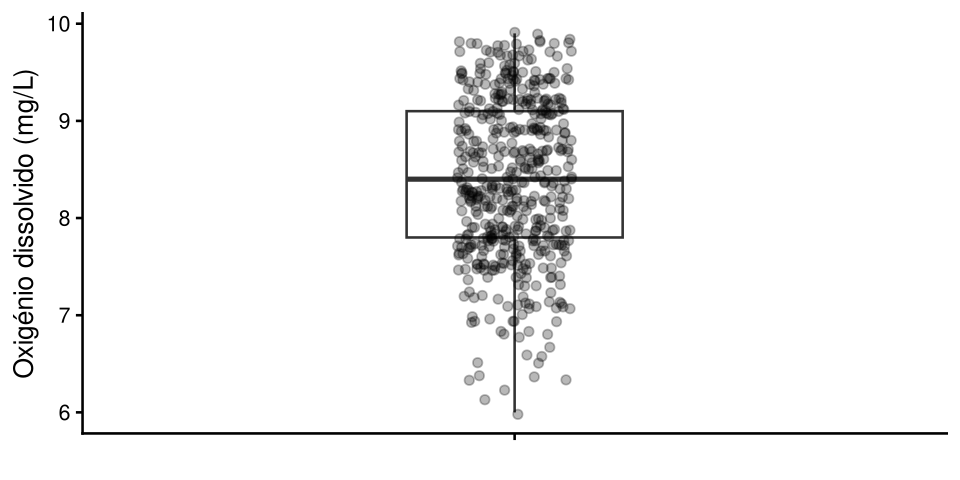
Dados: datasets::anscombe; Anscombe (1973), The American Statistician, 27(1), 17–21.
Matejka & Fitzmaurice (2017), CHI 2017, 1290–1294. Abrir a página original.
Anscombe (1973) → quatro conjuntos, mesmos sumários, gráficos diferentes
Matejka & Fitzmaurice (2017) → muitos conjuntos visualmente distintos, mantendo praticamente constantes média, SD e correlação
O gráfico mostra a estrutura; os sumários permitem quantificá-la.
Um gráfico pode revelar ao mesmo tempo:
forma · grupos · lacunas · extremos · relações · erros
O ganho está no tempo de interpretação: muitas características ficam visíveis ao mesmo tempo.
Antes, desenhar muitos gráficos dava trabalho.
Hoje podemos gerar histograma + pontos + caixa + relações entre variáveis no mesmo fluxo em segundos.
Vemos primeiro a estrutura global e escolhemos depois o que vale a pena quantificar.
gráfico → estrutura global rapidamente
números → quantificar aspectos específicos
No mesmo fluxo de trabalho podemos gerar e interpretar ambos.
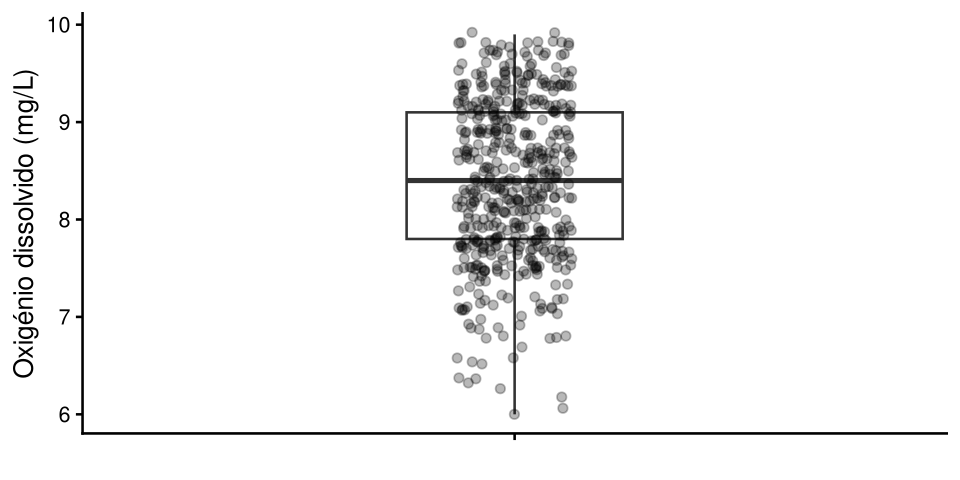
Randall Munroe, xkcd 1798: Box Plot, CC BY-NC 2.5.
erro? · organismo raro? · condição extrema?
O gráfico não decide.
observações → como os valores se distribuem
modelo de probabilidade → que resultados o processo admite
relação → como duas variáveis covariam
Uma distribuição observada descreve estes dados; uma distribuição de probabilidade descreve resultados possíveis sob um modelo.
forma da distribuição ≠ nome automático da análise
Primeiro: pergunta, delineamento e o que a resposta representa.
Os exercícios usam colunas de um data.frame.
linha → registo · coluna → variável
Um registo pode representar uma unidade ou uma medição repetida da mesma unidade. Confirmem o que cada linha representa.
Se
dados$variavel,dados[linhas, colunas]ou a selecção de colunas não forem familiares, usem esta página como referência durante o exercício.
Preparação e dados em falta: usem o início da página.
Pacotes no início do script, uma só vez. Instalação, se necessária, na consola.
# A tibble: 3 × 4
  species       N N_massa media
  <fct>     <int>   <int> <dbl>
1 Adelie      152     151 3701.
2 Chinstrap    68      68 3733.
3 Gentoo 124 123 5076.N: registos · N_massa: massas observadas · média em g
Para separar também por sexo:
group_by(species, sex).
25 minutos · grupos de 3 ou 5
Façam 1, 2 e 3.
Não façam o exercício 4 hoje.
Anscombe e o Datasaurus mostraram o problema. Agora procurem-no nos vossos dados.
15 minutos · grupos de 3 ou 5
Façam 1 com ds. Do 3, façam hoje só os dados individuais, sem intervalo:
A estimativa com intervalo fica para depois da introdução à inferência.
10 minutos · grupos de 3 ou 5
Escolham uma variável e escrevam:
Partilhem uma resposta. A turma decide que gráfico ajudaria a resolver a última dúvida.
Usem a secção que responde à dúvida.
ver ↔︎ contar ↔︎ resumir ↔︎ representar
Ainda não estamos a testar nada.
A descrição organiza aquilo que observámos.
A inferência parte dessas estatísticas para estudar incerteza e generalização.
Primeiro compreendemos o que o número resume; depois estudamos como pode variar para além desta amostra.