tank treatment growth
1 1 Control 7.381509
2 1 Control 7.935572
3 1 Control 7.820514
4 1 Control 7.434780
5 1 Control 8.759421
6 2 Control 12.446396
Desenho Experimental e Análise Avançada de Dados Ecológicos
peixe → tanque → tratamento
As linhas nunca foram automaticamente independentes.
agrupamento · intercepto aleatório · medidas repetidas
Declives aleatórios ficam como extensão.
Exemplo simulado
6 controlo · 6 aquecidos · 5 peixes/tanque
CSV simulado: uma linha por peixe, crescimento em unidades arbitrárias.
A codificação dos factores não resolve a dependência.
Agregar ao nível da unidade independente.
5 peixes → 1 média do tanque
Perdemos informação dentro do tanque.
Uma linha = um peixe · tratamento entre tanques · crescimento em unidades arbitrárias neste exemplo simulado.
Mixed Model Anova Table (Type 3 tests, S-method)
Model: growth ~ treatment + (1 | tank)
Data: ds
Effect df F p.value
1 treatment 1, 10.00 7.74 * .019
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
treatment emmean SE df lower.CL upper.CL
Control 9.08 0.616 10 7.71 10.5
Heated 11.50 0.616 10 10.13 12.9
Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
contrast estimate SE df lower.CL upper.CL t.ratio p.value
Control - Heated -2.42 0.871 10 -4.37 -0.483 -2.782 0.0194
Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
Descarreguem o CSV simulado e adaptem o caminho em read.csv() à vossa pasta de trabalho.
library(afex)
library(dplyr)
library(emmeans)
library(ggplot2)
options(contrasts = c("contr.sum", "contr.poly"))
ds <- read.csv("../../data/tank_growth_demo.csv") |>
mutate(tank = factor(tank))
m <- mixed(growth ~ treatment + (1 | tank), data = ds, method = "S")
treatment_means <- emmeans(m, ~ treatment)
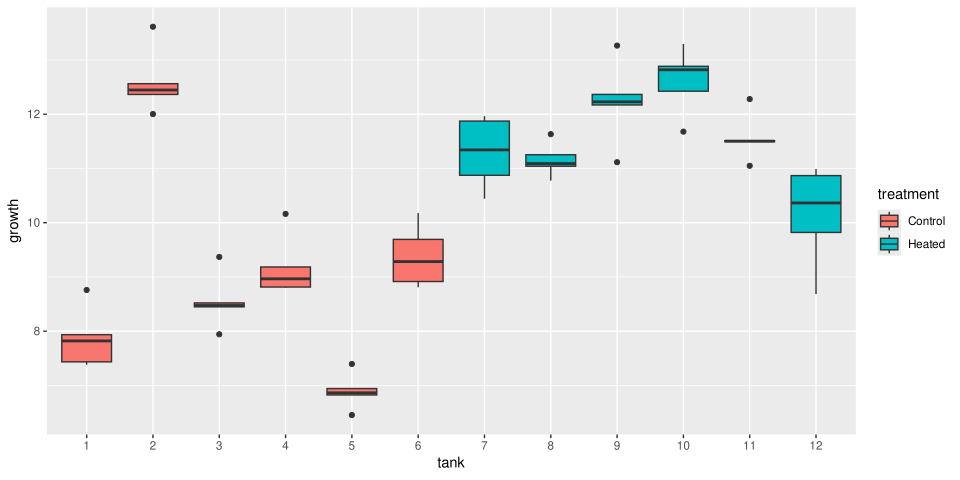
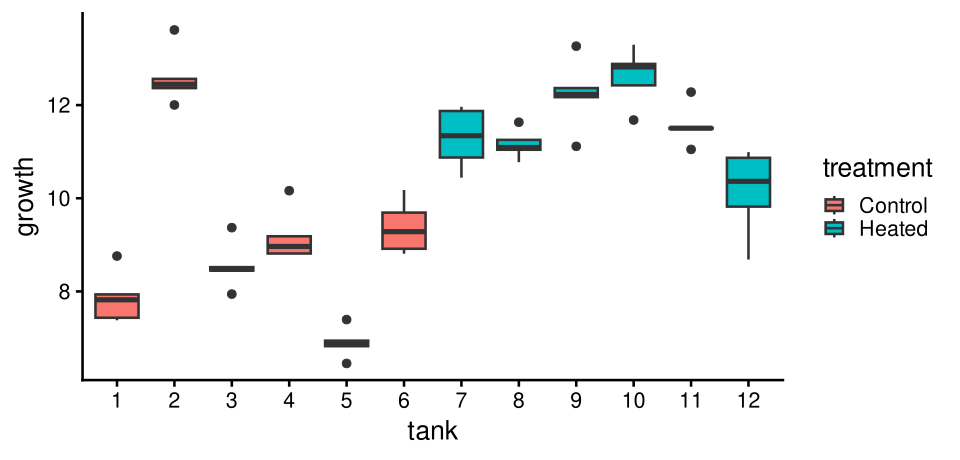
g <- ggplot(ds, aes(tank, growth, fill = treatment)) + geom_boxplot()
# Print results and plot
print(m)
print(treatment_means)
pairs(treatment_means) |> summary(infer = TRUE) |> print()
print(g)Mixed Model Anova Table (Type 3 tests, S-method)
Model: growth ~ treatment + (1 | tank)
Data: ds
Effect df F p.value
1 treatment 1, 10.00 7.74 * .019
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
treatment emmean SE df lower.CL upper.CL
Control 9.08 0.616 10 7.71 10.5
Heated 11.50 0.616 10 10.13 12.9
Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
contrast estimate SE df lower.CL upper.CL t.ratio p.value
Control - Heated -2.42 0.871 10 -4.37 -0.483 -2.782 0.0194
Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
O crescimento estimado foi menor no controlo do que no aquecimento: Control − Heated = −2.42 unidades, 95% CI [−4.37, −0.48], t10 = −2.78, P = .019. São dados simulados: há seis tanques por tratamento, não 30 réplicas. Os cinco peixes por tanque são subamostras. O modelo supõe tanques independentes e resíduos independentes dentro de cada tanque depois de considerar o seu intercepto; não representa um eventual circuito de água partilhado.
Com contrastes soma-zero, o coeficiente de tratamento é metade da diferença entre médias; pairs() devolve a diferença inteira, Control − Heated.
intercepto do tanque
Cada tanque pode ter um nível basal diferente.
\[ \beta_{0j}=\beta_0+b_{0j} \]
intercepto global + desvio do grupo
\[ \beta_{1j}=\beta_1+b_{1j} \]
declive global + desvio da unidade
Sintaxe esquemática: exige temperatura variável dentro de cada colónia; não se aplica ao CSV dos tanques.
O delineamento tem de fornecer informação para estimar essa variação.
A mesma unidade aparece em mais de uma linha.
mesma unidade · IDs diferentes
Identificação falhada pode esconder a repetição.
| Species | Id | Stage | Unit |
|---|---|---|---|
| Burgula | ID372 | EARLY | Burgula.ID372 |
| Burgula | ID372 | LATE | Burgula.ID372 |
| Watersipora | ID173 | EARLY | Watersipora.ID173 |
| Watersipora | ID173 | LATE | Watersipora.ID173 |
Unit: chave construída ≠ identidade biológica verificada
Why Does Offspring Size Affect Performance? Integrating Metabolic Scaling With Life-History Theory
15 minutos · grupos de 3 ou 5
Procurem nos Métodos como foram acompanhados os organismos.
Species → inter-unidades
Stage → intra-unidades
muitas Unit na mesma Species → normal
a mesma Unit em vários Stage → dependência
O rótulo do grupo pode repetir-se. A unidade é que não pode fingir ser nova.
A mudança entre estádios difere entre espécies?
Anova Table (Type 3 tests)
Response: Log10MR
Effect df MSE F ges p.value
1 Species 1, 253 0.03 288.52 *** .414 <.001
2 Stage 1, 253 0.02 757.70 *** .533 <.001
3 Species:Stage 1, 253 0.02 16.84 *** .025 <.001
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
Species = Burgula:
Stage emmean SE df lower.CL upper.CL
EARLY -0.7906 0.0125 253 -0.815 -0.766
LATE -0.4443 0.0102 253 -0.464 -0.424
Species = Watersipora:
Stage emmean SE df lower.CL upper.CL
EARLY -0.5315 0.0231 253 -0.577 -0.486
LATE -0.0639 0.0187 253 -0.101 -0.027
Confidence level used: 0.95
Species = Burgula:
contrast estimate SE df lower.CL upper.CL t.ratio p.value
EARLY - LATE -0.346 0.0141 253 -0.374 -0.318 -24.557 <0.0001
Species = Watersipora:
contrast estimate SE df lower.CL upper.CL t.ratio p.value
EARLY - LATE -0.468 0.0260 253 -0.519 -0.416 -17.993 <0.0001
Confidence level used: 0.95
contrast estimate SE df
(EARLY - LATE Burgula) - (EARLY - LATE Watersipora) 0.121 0.0296 253
lower.CL upper.CL t.ratio p.value
0.0631 0.18 4.103 <0.0001
Confidence level used: 0.95
Descarreguem o CSV e adaptem o caminho em read.csv() à vossa pasta de trabalho. A chave junta linhas; os Métodos é que confirmam a identidade.
library(afex)
library(dplyr)
library(emmeans)
library(ggplot2)
options(contrasts = c("contr.sum", "contr.poly"))
ds <- read.csv("../../data/bryozoan_wrangled.csv") |>
filter(Stage %in% c("EARLY", "LATE")) |>
mutate(Unit = interaction(Species, Id, drop = TRUE))
m_rm <- aov_4(Log10MR ~ Species * Stage + (Stage | Unit), data = ds)
stage_means <- emmeans(m_rm, ~ Stage | Species)
stage_changes <- pairs(stage_means)
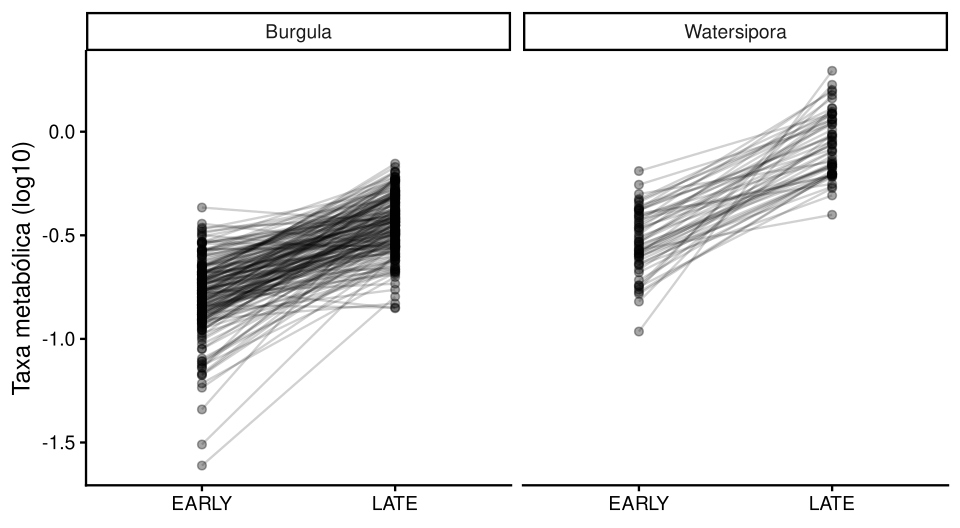
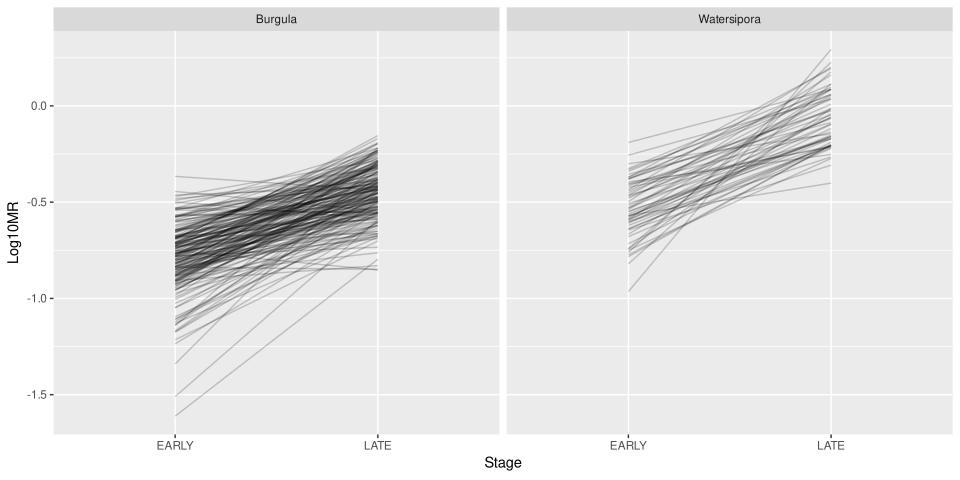
g <- ggplot(ds, aes(Stage, Log10MR, group = Unit)) +
geom_line(alpha = .2) + facet_wrap(~ Species)
# Print results and plot
print(m_rm)
print(stage_means)
summary(stage_changes, infer = TRUE) |> print()
pairs(stage_changes, by = NULL) |> summary(infer = TRUE) |> print()
print(g)Anova Table (Type 3 tests)
Response: Log10MR
Effect df MSE F ges p.value
1 Species 1, 253 0.03 288.52 *** .414 <.001
2 Stage 1, 253 0.02 757.70 *** .533 <.001
3 Species:Stage 1, 253 0.02 16.84 *** .025 <.001
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
Species = Burgula:
Stage emmean SE df lower.CL upper.CL
EARLY -0.7906 0.0125 253 -0.815 -0.766
LATE -0.4443 0.0102 253 -0.464 -0.424
Species = Watersipora:
Stage emmean SE df lower.CL upper.CL
EARLY -0.5315 0.0231 253 -0.577 -0.486
LATE -0.0639 0.0187 253 -0.101 -0.027
Confidence level used: 0.95
Species = Burgula:
contrast estimate SE df lower.CL upper.CL t.ratio p.value
EARLY - LATE -0.346 0.0141 253 -0.374 -0.318 -24.557 <0.0001
Species = Watersipora:
contrast estimate SE df lower.CL upper.CL t.ratio p.value
EARLY - LATE -0.468 0.0260 253 -0.519 -0.416 -17.993 <0.0001
Confidence level used: 0.95
contrast estimate SE df
(EARLY - LATE Burgula) - (EARLY - LATE Watersipora) 0.121 0.0296 253
lower.CL upper.CL t.ratio p.value
0.0631 0.18 4.103 <0.0001
Confidence level used: 0.95
Anova Table (Type 3 tests)
Response: Log10MR
Effect df MSE F ges p.value
1 Species 1, 253 0.03 288.52 *** .414 <.001
2 Stage 1, 253 0.02 757.70 *** .533 <.001
3 Species:Stage 1, 253 0.02 16.84 *** .025 <.001
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
Species:Stage: a mudança EARLY → LATE é igual nas duas espécies? A tabela respeita a repetição dentro de Unit; não é a ANOVA de 510 unidades independentes.
A diferença EARLY − LATE na taxa metabólica log10 foi -0.346 em Burgula, 95% CI [-0.374, -0.318], e -0.468 em Watersipora, 95% CI [-0.519, -0.416]. A diferença entre estas mudanças foi 0.121 unidades log10, 95% CI [0.063, 0.180]; a interacção na ANOVA de medidas repetidas foi F1, 253 = 16.84, P < .001. As medições pertencem a 255 unidades; a generalização depende da amostragem e da confirmação da identidade nos registos do estudo.
Nenhum modelo inventa réplicas que não foram recolhidas.
15 minutos · grupos de 3 ou 5
Medidas Repetidas no R — Exercícios
Façam exercícios 5, 6 e 7.
20 minutos · grupos de 3 ou 5
Medidas Repetidas no R — Exercícios
Façam exercícios 3 e 4.
10 minutos · grupos de 3 ou 5
Escolham tanques ou briozoários e expliquem, sem usar a palavra «aleatório»:
Agora conseguimos manter as observações no nível mais fino sem fingir que todas as linhas são independentes.