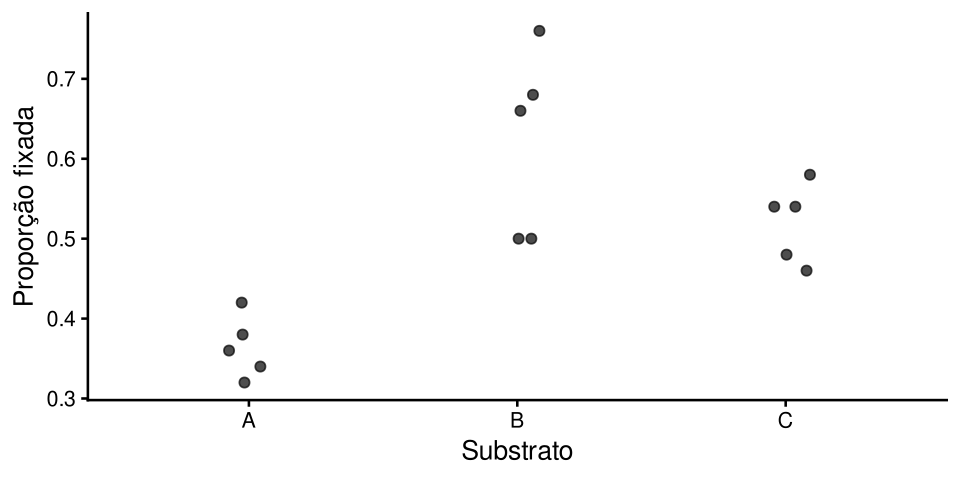
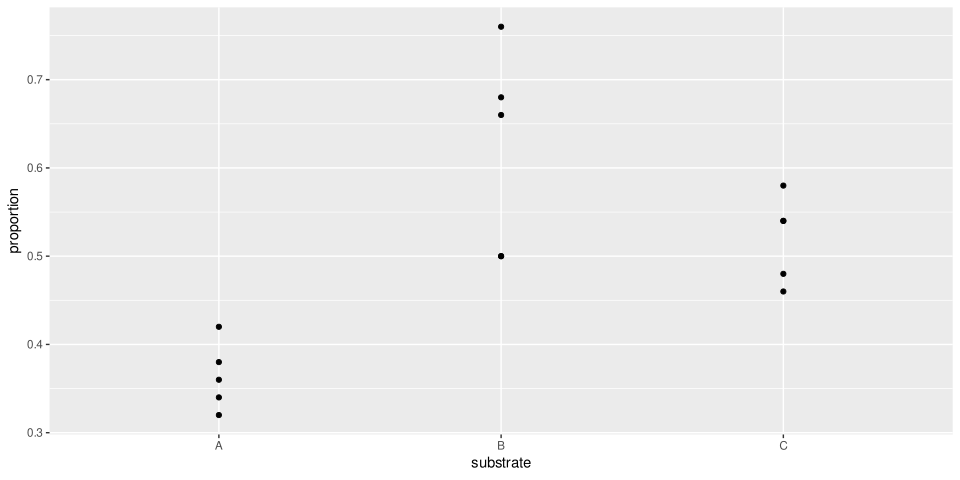
settlement_means <-emmeans(m_prop, ~ substrate)summary(settlement_means, type ="response")
 substrate  prob     SE  df asymp.LCL asymp.UCL
 A         0.364 0.0304 Inf     0.307     0.425
 B         0.620 0.0307 Inf     0.558     0.678
 C         0.520 0.0316 Inf     0.458     0.581

Confidence level used: 0.95
Intervals are back-transformed from the logit scale
summary(pairs(settlement_means), type ="response", infer =TRUE)
 contrast odds.ratio     SE  df asymp.LCL asymp.UCL null z.ratio p.value
 A / B         0.351 0.0649 Inf     0.227     0.541    1  -5.660 <0.0001
 A / C         0.528 0.0964 Inf     0.344     0.810    1  -3.496  0.0014
 B / C         1.506 0.2740 Inf     0.984     2.305    1   2.254  0.0625

Confidence level used: 0.95
Conf-level adjustment: tukey method for comparing a family of 3 estimates
Intervals are back-transformed from the log odds ratio scale
P value adjustment: tukey method for comparing a family of 3 estimates
Tests are performed on the log odds ratio scale
probabilidades e IC 95% · contrastes: razões de odds
weights = total conserva o número de larvas por placa; não ignoramos o denominador.
Testes no log odds, com ajuste de Tukey para as 3 comparações.
Mesma Arquitectura, Outra Família
Exemplo simulado · transectos
Quantos organismos vimos?
Poisson
ds <-read.csv("../../data/transect_counts_demo.csv")m_count <-glm(n ~ habitat, data = ds, family =poisson())
effort tem de ser positivo; log_effort é o seu logaritmo. O offset fixa o seu coeficiente em 1: à mesma taxa, triplicar o tempo triplica a contagem esperada. Não estimamos um declive para o esforço.
Escala Logarítmica
\[
\log E(Y|X)=X\beta
\]
Exponenciar uma diferença de log-médias produz uma razão de médias.
Família Também É Variância
A escolha não serve apenas para impedir previsões impossíveis.
Extensão: Sobredispersão
mais variação do que o Poisson espera
Perguntem porquê antes de mudar de família.
Pode Ser
heterogeneidade · agrupamento · zeros · média mal especificada
GLM ≠ Modelo Misto
Mudar a família não resolve dependência entre linhas.
Demonstrar a Comparação Global
Voltamos aos dados de fixação de larvas. Demonstração: escrever a probabilidade comum à parte mostra a hipótese que a linha substrate testa.
ds <-read.csv("../../data/larval_settlement_demo.csv")ds$proportion <- ds$settled / ds$totalm0 <-glm(proportion ~1, weights = total, data = ds, family =binomial())anova(m0, m_prop, test ="Chisq")
substrate settled failed
        A      91    159
        B     155     95
        C     130    120
xtabs() soma as contagens por substrato, sem criar uma linha por larva. Agregar não cria independência: precisamos de a justificar para larvas e placas.
Pearson \(X^2\) ≠ razão de verosimilhanças \(G^2\). Testam a mesma hipótese e têm a mesma referência \(\chi^2_2\) assintótica; as estatísticas e os valores-p não são exactamente iguais em amostras finitas.
Script Binomial
Descarreguem o CSV simulado e adaptem o caminho em read.csv() à vossa pasta de trabalho. Um modelo:Anova() dá o teste global; model_parameters() descreve os coeficientes e emmeans() dá estimativas na escala biológica.
 substrate  prob     SE  df asymp.LCL asymp.UCL
 A         0.364 0.0304 Inf     0.307     0.425
 B         0.620 0.0307 Inf     0.558     0.678
 C         0.520 0.0316 Inf     0.458     0.581

Confidence level used: 0.95
Intervals are back-transformed from the logit scale
 contrast odds.ratio     SE  df asymp.LCL asymp.UCL null z.ratio p.value
 A / B         0.351 0.0649 Inf     0.227     0.541    1  -5.660 <0.0001
 A / C         0.528 0.0964 Inf     0.344     0.810    1  -3.496  0.0014
 B / C         1.506 0.2740 Inf     0.984     2.305    1   2.254  0.0625

Confidence level used: 0.95
Conf-level adjustment: tukey method for comparing a family of 3 estimates
Intervals are back-transformed from the log odds ratio scale
P value adjustment: tukey method for comparing a family of 3 estimates
Tests are performed on the log odds ratio scale
substrate: as três probabilidades de fixação são iguais?LR pede o teste de razão de verosimilhanças: é o da demonstração anterior. Não é necessário voltar a ajustar um modelo de probabilidade comum.
Coeficientes na escala logit, não probabilidades nem diferenças de probabilidade. Os testes z dizem respeito a esses coeficientes.
Ler na Escala Biológica
settlement_means <-emmeans(m_prop, ~ substrate)summary(settlement_means, type ="response")
 substrate  prob     SE  df asymp.LCL asymp.UCL
 A         0.364 0.0304 Inf     0.307     0.425
 B         0.620 0.0307 Inf     0.558     0.678
 C         0.520 0.0316 Inf     0.458     0.581

Confidence level used: 0.95
Intervals are back-transformed from the logit scale
summary(pairs(settlement_means), type ="response", infer =TRUE)
 contrast odds.ratio     SE  df asymp.LCL asymp.UCL null z.ratio p.value
 A / B         0.351 0.0649 Inf     0.227     0.541    1  -5.660 <0.0001
 A / C         0.528 0.0964 Inf     0.344     0.810    1  -3.496  0.0014
 B / C         1.506 0.2740 Inf     0.984     2.305    1   2.254  0.0625

Confidence level used: 0.95
Conf-level adjustment: tukey method for comparing a family of 3 estimates
Intervals are back-transformed from the log odds ratio scale
P value adjustment: tukey method for comparing a family of 3 estimates
Tests are performed on the log odds ratio scale
Primeiro: probabilidades previstas por substrato
Depois: razões de odds, não diferenças de probabilidade
Tukey: ajuste para as três comparações entre substratos
Relatar a Fixação
A probabilidade estimada de fixação foi .364 em A, 95% CI [.307, .425], .620 em B, 95% CI [.558, .678], e .520 em C, 95% CI [.458, .581]. As odds em A foram 0.351 vezes as de B, 95% CI [0.227, 0.541], com ajuste de Tukey. O teste global de razão de verosimilhanças comparou uma probabilidade comum com três probabilidades: \(\chi^2_2\) = 33.67, P < .001. Os testes z do resumo são de Wald, não este teste global. O exemplo é simulado; a inferência depende da independência assumida entre larvas e placas.
Script de Taxas
Descarreguem o CSV simulado e adaptem o caminho em read.csv() à vossa pasta de trabalho.
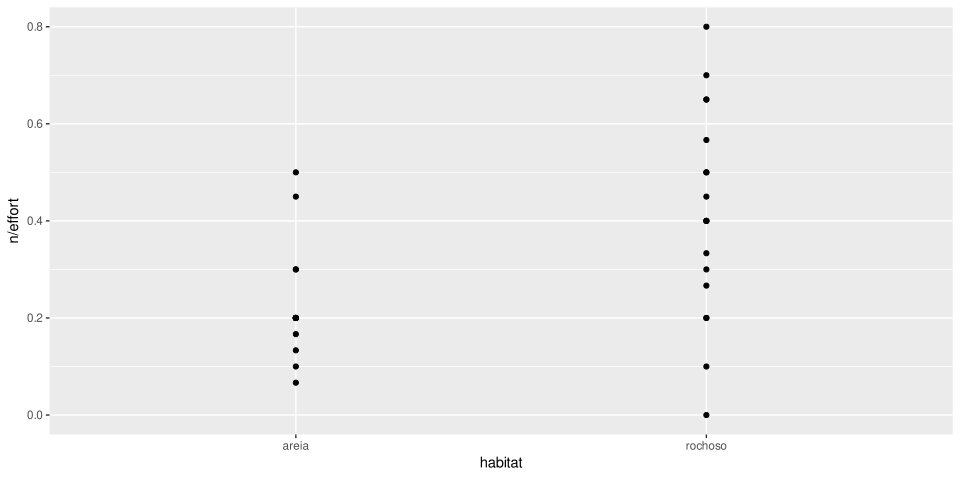
library(dplyr)library(emmeans)library(ggplot2)library(parameters)options(contrasts =c("contr.sum", "contr.poly"))ds <-read.csv("../../data/transect_counts_demo.csv") |>mutate(log_effort =log(effort))m <-glm(n ~ habitat +offset(log_effort), data = ds, family =poisson())rate_means <-emmeans(m, ~ habitat, offset =0)g <-ggplot(ds, aes(habitat, n / effort)) +geom_point()# Print results and plotmodel_parameters(m) |>print()summary(rate_means, type ="response") |>print()pairs(rate_means) |>summary(type ="response", infer =TRUE) |>print()print(g)
Resultados das Taxas
Parameter   | Log-Mean |   SE |         95% CI |      z |      p
----------------------------------------------------------------
(Intercept) |    -1.21 | 0.07 | [-1.36, -1.07] | -16.35 | < .001
habitat [1] |    -0.34 | 0.07 | [-0.48, -0.19] |  -4.54 | < .001
 habitat  rate     SE  df asymp.LCL asymp.UCL
 areia   0.212 0.0254 Inf     0.168     0.268
 rochoso 0.416 0.0366 Inf     0.350     0.495

Confidence level used: 0.95
Intervals are back-transformed from the log scale
 contrast        ratio     SE  df asymp.LCL asymp.UCL null z.ratio p.value
 areia / rochoso  0.51 0.0757 Inf     0.381     0.682    1  -4.539 <0.0001

Confidence level used: 0.95
Intervals are back-transformed from the log scale
Tests are performed on the log scale
offset = 0 em emmeans() pede previsões para uma unidade de esforço.
Ler Contagens Como Taxas
model_parameters(m_rate)
Parameter   | Log-Mean |   SE |         95% CI |      z |      p
----------------------------------------------------------------
(Intercept) |    -1.21 | 0.07 | [-1.36, -1.07] | -16.35 | < .001
habitat [1] |    -0.34 | 0.07 | [-0.48, -0.19] |  -4.54 | < .001
rate_means <-emmeans(m_rate, ~ habitat, offset =0)summary(rate_means, type ="response")
 habitat  rate     SE  df asymp.LCL asymp.UCL
 areia   0.212 0.0254 Inf     0.168     0.268
 rochoso 0.416 0.0366 Inf     0.350     0.495

Confidence level used: 0.95
Intervals are back-transformed from the log scale
summary(pairs(rate_means), type ="response", infer =TRUE)
 contrast        ratio     SE  df asymp.LCL asymp.UCL null z.ratio p.value
 areia / rochoso  0.51 0.0757 Inf     0.381     0.682    1  -4.539 <0.0001

Confidence level used: 0.95
Intervals are back-transformed from the log scale
Tests are performed on the log scale
A resposta ajustada continua a ser a contagem. As previsões para um minuto são taxas em organismos/minuto; o contraste é uma razão de taxas.
Relatar as Taxas
Neste exemplo simulado, as taxas estimadas foram 0.212 organismos/minuto em areia, 95% CI [0.168, 0.268], e 0.416 em habitat rochoso, 95% CI [0.350, 0.495]. A razão areia/rochoso foi 0.510, 95% CI [0.381, 0.682], teste de Wald z = -4.54, P < .001. O GLM de Poisson incluiu o logaritmo da duração como offset.
Antes de generalizar: verificar sobredispersão, agrupamento e a suposição de contagem proporcional ao esforço. O offset não confirma essas condições.