| crab_id | displacement_cm |
|---|---|
| 1 | -1.93 |
| 2 | -0.93 |
| 3 | 0.07 |
| 4 | 0.07 |
| 5 | 1.07 |
| 6 | 1.07 |
Comparar Modelos
Desenho Experimental e Análise Avançada de Dados Ecológicos
Mar ou Rochas?
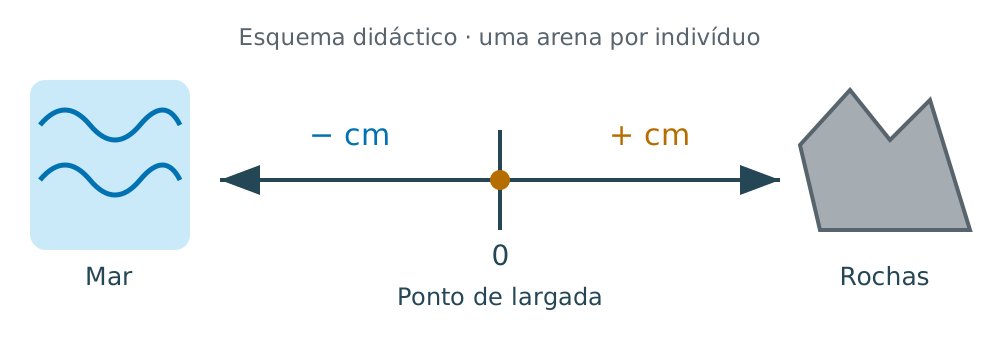
Há um deslocamento médio para um dos lados?
Conhecer os Dados
24 indivíduos · uma medição por indivíduo · dados fictícios
Ver Antes de Modelar
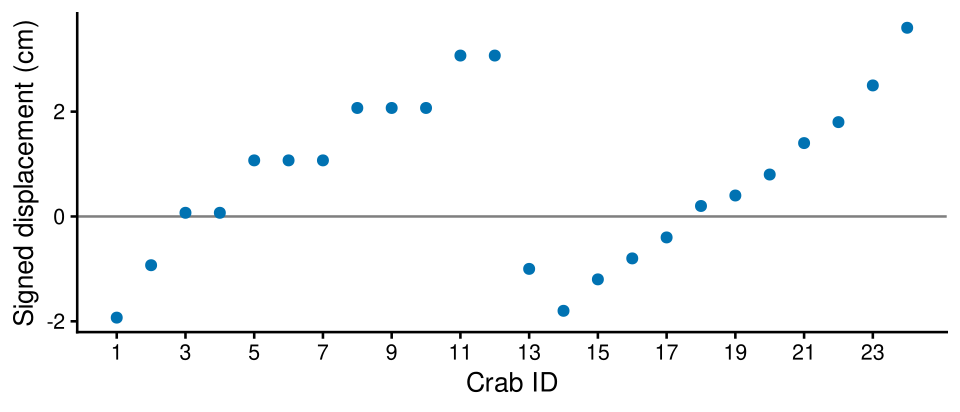
O que prevemos para um novo indivíduo deste processo?
Dados, Modelo e Erro
\[y_i=\widehat y_i+e_i\]
Observado = previsto + resíduo
\[e_i=y_i-\widehat y_i\]
Para Perceber o Teste
Demonstração: dois modelos para mostrar a hipótese testada e a origem da estatística.
Análise: ajustar o modelo de interesse e interpretar a saída.
As comparações explícitas com anova() nestas aulas abrem as contas dos testes. Não são passos extra a acrescentar ao script de análise.
Duas Previsões
| Modelo | Previsão | Coeficientes Estimados |
|---|---|---|
| Compacto, \(m_0\) | Zero | 0 |
| Aumentado, \(m_1\) | Média amostral | 1 |
O aumentado estima um parâmetro: o intercepto.
Escrever em R
lm() ajusta um modelo linear.
resposta ~ modelo lê-se «resposta em função de…».
Ler a Fórmula
| Sintaxe | O Que Pedimos |
|---|---|
displacement_cm |
Resposta a prever |
~ 0 |
Sem intercepto nem preditores: previsão zero |
~ 1 |
Apenas um intercepto: média comum estimada |
data = ds |
Procurar as colunas nesta tabela |
Prever Zero
\[m_0:\quad\widehat y_i=0\]
O resíduo coincide com o deslocamento observado.
As Mesmas Linhas
| crab_id | displacement_cm | prediction_m0 | error_m0 |
|---|---|---|---|
| 1 | -1.93 | 0 | -1.93 |
| 2 | -0.93 | 0 | -0.93 |
| 3 | 0.07 | 0 | 0.07 |
| 4 | 0.07 | 0 | 0.07 |
| 5 | 1.07 | 0 | 1.07 |
| 6 | 1.07 | 0 | 1.07 |
| 7 | 1.07 | 0 | 1.07 |
| 8 | 2.07 | 0 | 2.07 |
| 9 | 2.07 | 0 | 2.07 |
| 10 | 2.07 | 0 | 2.07 |
| 11 | 3.07 | 0 | 3.07 |
| 12 | 3.07 | 0 | 3.07 |
| 13 | -1.00 | 0 | -1.00 |
| 14 | -1.80 | 0 | -1.80 |
| 15 | -1.20 | 0 | -1.20 |
| 16 | -0.80 | 0 | -0.80 |
| 17 | -0.40 | 0 | -0.40 |
| 18 | 0.20 | 0 | 0.20 |
| 19 | 0.40 | 0 | 0.40 |
| 20 | 0.80 | 0 | 0.80 |
| 21 | 1.40 | 0 | 1.40 |
| 22 | 1.80 | 0 | 1.80 |
| 23 | 2.50 | 0 | 2.50 |
| 24 | 3.60 | 0 | 3.60 |
Uma coluna de previsões; outra de distâncias à previsão.
Estimar a Média
(Intercept)
0.76417 \[m_1:\quad\widehat y_i=\widehat\beta_0=\bar y=0.76\text{ cm}\]
Outra Previsão, Outros Resíduos
| crab_id | displacement_cm | prediction_m0 | error_m0 | prediction_m1 | error_m1 |
|---|---|---|---|---|---|
| 1 | -1.93 | 0 | -1.93 | 0.76417 | -2.69417 |
| 2 | -0.93 | 0 | -0.93 | 0.76417 | -1.69417 |
| 3 | 0.07 | 0 | 0.07 | 0.76417 | -0.69417 |
| 4 | 0.07 | 0 | 0.07 | 0.76417 | -0.69417 |
| 5 | 1.07 | 0 | 1.07 | 0.76417 | 0.30583 |
| 6 | 1.07 | 0 | 1.07 | 0.76417 | 0.30583 |
| 7 | 1.07 | 0 | 1.07 | 0.76417 | 0.30583 |
| 8 | 2.07 | 0 | 2.07 | 0.76417 | 1.30583 |
| 9 | 2.07 | 0 | 2.07 | 0.76417 | 1.30583 |
| 10 | 2.07 | 0 | 2.07 | 0.76417 | 1.30583 |
| 11 | 3.07 | 0 | 3.07 | 0.76417 | 2.30583 |
| 12 | 3.07 | 0 | 3.07 | 0.76417 | 2.30583 |
| 13 | -1.00 | 0 | -1.00 | 0.76417 | -1.76417 |
| 14 | -1.80 | 0 | -1.80 | 0.76417 | -2.56417 |
| 15 | -1.20 | 0 | -1.20 | 0.76417 | -1.96417 |
| 16 | -0.80 | 0 | -0.80 | 0.76417 | -1.56417 |
| 17 | -0.40 | 0 | -0.40 | 0.76417 | -1.16417 |
| 18 | 0.20 | 0 | 0.20 | 0.76417 | -0.56417 |
| 19 | 0.40 | 0 | 0.40 | 0.76417 | -0.36417 |
| 20 | 0.80 | 0 | 0.80 | 0.76417 | 0.03583 |
| 21 | 1.40 | 0 | 1.40 | 0.76417 | 0.63583 |
| 22 | 1.80 | 0 | 1.80 | 0.76417 | 1.03583 |
| 23 | 2.50 | 0 | 2.50 | 0.76417 | 1.73583 |
| 24 | 3.60 | 0 | 3.60 | 0.76417 | 2.83583 |
Algumas distâncias aumentaram; outras diminuíram.
Ver as Distâncias
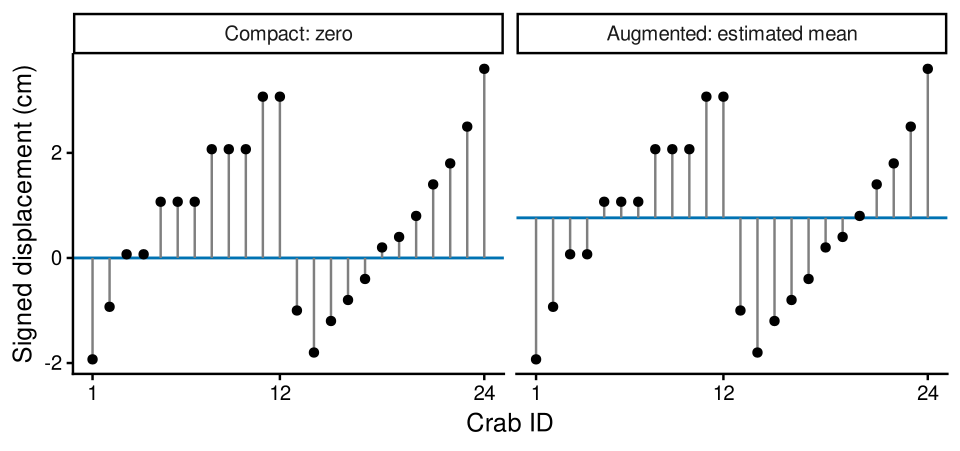
Mesmos dados · duas linhas · dois conjuntos de resíduos
Como Somar o Erro?
\[-2+2=0\]
Mas nenhum destes resíduos é zero.
\[(-2)^2+2^2=8\]
Os quadrados impedem que os sinais se anulem.
Uma Coluna de Cada Vez
| crab_id | squared_error_m0 | squared_error_m1 |
|---|---|---|
| 1 | 3.7249 | 7.25853 |
| 2 | 0.8649 | 2.87020 |
| 3 | 0.0049 | 0.48187 |
| 4 | 0.0049 | 0.48187 |
| 5 | 1.1449 | 0.09353 |
| 6 | 1.1449 | 0.09353 |
| 7 | 1.1449 | 0.09353 |
| 8 | 4.2849 | 1.70520 |
| 9 | 4.2849 | 1.70520 |
| 10 | 4.2849 | 1.70520 |
| 11 | 9.4249 | 5.31687 |
| 12 | 9.4249 | 5.31687 |
| 13 | 1.0000 | 3.11228 |
| 14 | 3.2400 | 6.57495 |
| 15 | 1.4400 | 3.85795 |
| 16 | 0.6400 | 2.44662 |
| 17 | 0.1600 | 1.35528 |
| 18 | 0.0400 | 0.31828 |
| 19 | 0.1600 | 0.13262 |
| 20 | 0.6400 | 0.00128 |
| 21 | 1.9600 | 0.40428 |
| 22 | 3.2400 | 1.07295 |
| 23 | 6.2500 | 3.01312 |
| 24 | 12.9600 | 8.04195 |
Somar os Quadrados
\[\mathrm{SSE}_0=71.4688\text{ cm}^2\]
\[\mathrm{SSE}_1=57.454\text{ cm}^2\]
SSE: sum of squared errors.
Quanto Ganhámos?
\[\mathrm{SSE}_0-\mathrm{SSE}_1=14.0148\text{ cm}^2\]
Menos erro, mas mais um parâmetro.
A melhoria justifica a complexidade acrescentada?
O Custo do Parâmetro
| Compacto | Aumentado | |
|---|---|---|
| Coeficientes estimados | 0 | 1 |
| Graus de liberdade residuais | 24 | 23 |
Um parâmetro acrescentado; 23 graus de liberdade para o erro.
Da Melhoria ao F
\[F=\frac{\dfrac{\mathrm{SSE}_0-\mathrm{SSE}_1}{df_0-df_1}}{\dfrac{\mathrm{SSE}_1}{df_1}}=\frac{\dfrac{\mathrm{SSE}_0-\mathrm{SSE}_1}{1}}{\dfrac{\mathrm{SSE}_1}{23}}\]
\(df_0\) e \(df_1\): graus de liberdade residuais dos modelos compacto e aumentado.
Numerador: melhoria por parâmetro acrescentado.
Denominador: erro restante por grau de liberdade.
Fazer a Conta
\[F=\frac{\dfrac{14.0148}{1}}{\dfrac{57.454}{23}}\approx 5.61\]
A melhoria é cerca de 5.6 vezes a escala residual.
Comparar em R
Demonstração: esta comparação mostra o teste de média zero que reencontraremos no resumo do modelo.
Ler a Tabela
| Coluna | A Nossa Conta |
|---|---|
| RSS | SSE residual de cada modelo |
| Df | Um coeficiente acrescentado |
| Sum of Sq | Redução da SSE |
| F | Melhoria relativa ao erro restante |
| Pr(>F) | Área à direita do F observado, sob \(H_0\) |
Uma Melhoria Invulgar?
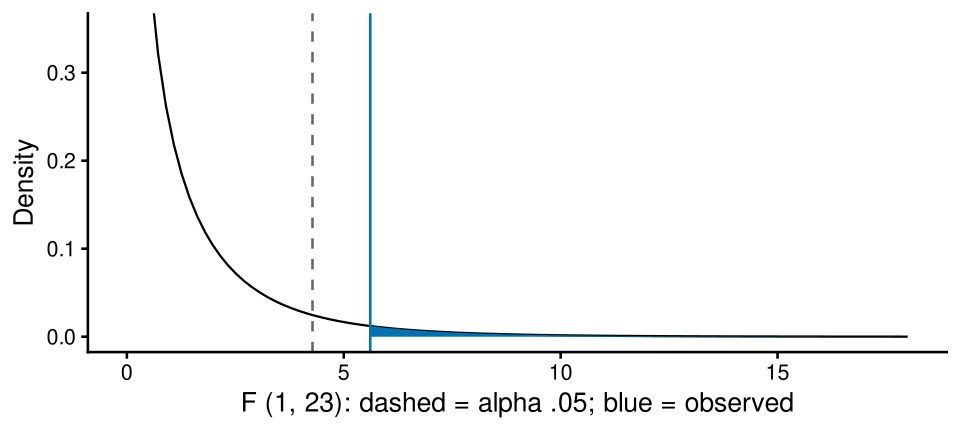
\(P\approx .027\) · \(\alpha=.05\) se escolhido antes dos dados
Script Completo
Descarreguem o CSV e adaptem o caminho em read.csv() à vossa pasta de trabalho. Análise: ajustar um modelo e ler estimativa, incerteza e teste. Os dois modelos e anova(m0, m1) serviram para explicar esse teste; não os repetimos neste script.
library(ggplot2)
library(parameters)

ds <- read.csv("../../data/intertidal_displacement_demo.csv")
m <- lm(displacement_cm ~ 1, data = ds)
g <- ggplot(ds, aes(crab_id, displacement_cm)) +
  geom_point() + geom_hline(yintercept = 0)

# Print results and plot
summary(m) |> print()
model_parameters(m) |> print()
print(g)
Resultados do Deslocamento
Call:
lm(formula = displacement_cm ~ 1, data = ds)

Residuals:
   Min     1Q Median     3Q    Max
-2.694 -1.264  0.171  1.306  2.836

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    0.764      0.323    2.37    0.027 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.58 on 23 degrees of freedom
Parameter | Coefficient | SE | 95% CI | t(23) | p
---------------------------------------------------------------
(Intercept) | 0.76 | 0.32 | [0.10, 1.43] | 2.37 | 0.027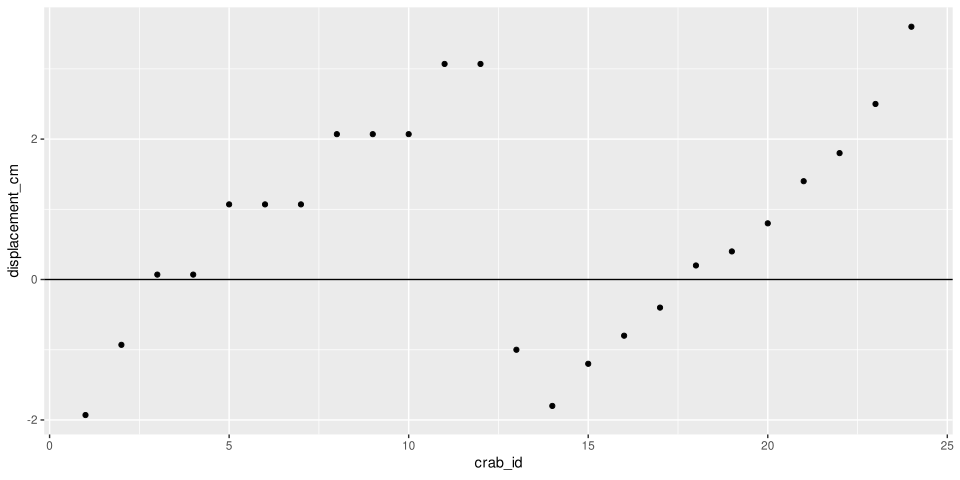
Ler o Resumo
Call:
lm(formula = displacement_cm ~ 1, data = ds)

Residuals:
   Min     1Q Median     3Q    Max
-2.694 -1.264  0.171  1.306  2.836

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    0.764      0.323    2.37    0.027 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.58 on 23 degrees of freedomEstimate: deslocamento médio, em cm. Std. Error: incerteza da média. t value e Pr(>|t|): teste de média zero, não um teste de imobilidade.
O Mesmo Teste
Demonstração de equivalência, não mais um teste a juntar ao script.
    One Sample t-test

data:  ds$displacement_cm
t = 2.37, df = 23, p-value = 0.027
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
 0.096778 1.431556
sample estimates:
mean of x
  0.76417
\[F=t^2\]
O mesmo teste-t bilateral de uma amostra, na linguagem dos modelos.
Tanta Volta?
Para testar uma média contra zero, o teste-t chegava. Aqui, t e F não são duas provas independentes: testam a mesma hipótese.
A comparação de modelos parece trabalho a mais porque começámos pelo caso mais simples. Serve para perceber o teste, não para alongar o script.
Mais à frente: testar vários coeficientes em conjunto. O F continua a servir; um único t da tabela de coeficientes já não chega.
Relatar o Que Aprendemos
O deslocamento médio estimado foi de 0.76 cm em direcção às rochas, 95% CI [0.10, 1.43] cm. O teste comparou a média com zero, t(23) = 2.37, P = .027. Os dados são fictícios; a inferência supõe indivíduos independentes no processo hipotético.
E Outra Referência?
Oxigénio médio: difere de 8 mg/L?
Outra demonstração: mudar a referência muda a hipótese testada.
Centrar a resposta transforma 8 na referência zero.
Da Média ao Preditor
Fica para a próxima aula: a previsão passa a depender de outra variável.
| Fórmula | Previsão |
|---|---|
Oxygen ~ 1 |
Uma média comum |
Oxygen ~ Temp |
A média varia com a temperatura |
\[\widehat y_i=\widehat\beta_0+\widehat\beta_1\,\mathrm{Temp}_i\]
Acrescentamos um declive. A lógica da comparação mantém-se.
O Que Deve Ficar
Previsões → resíduos → SSE → melhoria → complexidade → F.
Cada teste pergunta o que acontece ao impor uma restrição ao modelo.
Na demonstração, tornámo-la explícita com dois modelos encaixados nos mesmos dados. Na análise, lemos o teste na saída do modelo ajustado.
Para Praticar
Relato: estimativa + IC + referência + unidade.
Próximo Passo
A previsão deixa de ser igual para todos.