Do Ficheiro à Memória
Desenho Experimental e Análise Avançada de Dados Ecológicos
Do Campo ao R
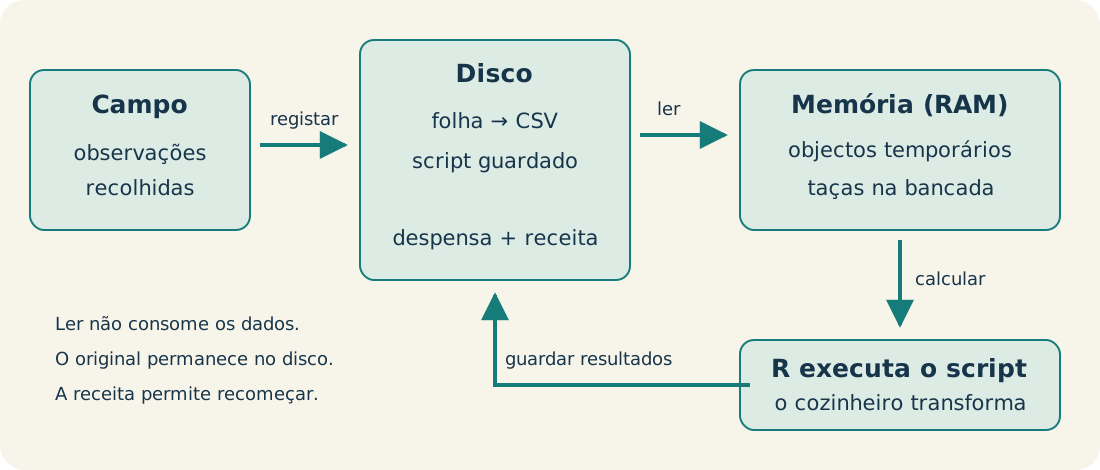
Antes de analisar, garantam que o R está a ler o mesmo que vocês vêem.
A Cozinha do R
ficheiro no disco = despensa · objectos na memória = taças na bancada
script = receita · R = cozinheiro
consola = instruções dadas na hora · sessão = bancada de trabalho
Os objectos na memória são temporários. Os ficheiros no disco permanecem.
Repetir a Receita
Ler um ficheiro não consome os dados: podemos importá-lo quantas vezes precisarmos.
Nestes exemplos, executar o script é rápido. Com os dados originais e uma boa receita, recriamos as tabelas, os gráficos e os modelos.
Guardamos os resultados finais quando precisamos de os comunicar; não dependemos de uma sessão antiga para continuar.
O original não se altera. Trabalhamos numa cópia e documentamos as alterações.
Onde Está o Ficheiro?
getwd()mostra a pasta de trabalho. Descarregar um ficheiro não o coloca na pasta do repositório.
Ler Um CSV
Descarreguem manatees.csv e o ficheiro tabulado. Substituam os caminhos de exemplo pelos caminhos dos ficheiros que escolheram, como em Organizar Dados em Tabelas.
vírgula · cabeçalho · uma linha por registo
Antes de Confiar
Olhem para as primeiras linhas em bruto. Os separadores não se veem bem no ecrã.
Separador ≠ Vírgula
\t · ; · vírgula decimal
Se todas as colunas aparecerem coladas, o problema é quase sempre o separador.
Um Ficheiro Tabulado
Os nomes mudaram.
Pounds(M)passou aPounds.M.. Isso é o R a tornar os nomes válidos.
Nomes ao Importar
espaços · parênteses · barras → pontos
Anotem a transformação. Quem escreve o código depois precisa dela.
Ficheiro Não Encontrado
caminho errado · pasta errada · maiúsculas e minúsculas
Se
file.exists()devolverFALSE, não mudem nomes ao acaso. Confirmem o caminho.
Guardar Uma Cópia
Escolham outro nome para a cópia.
row.names = FALSEevita uma coluna extra com números de linha.
Verificar a Exportação
Comparem as dimensões, os nomes e algumas linhas do original e da cópia reimportada.
Exercício Um
15 minutos · pares
Usem lobsters-2016.tsv:
- leiam o ficheiro com
read.delim(); - confirmem o número de linhas e de colunas com
dim(); - identifiquem a coluna de anos e a coluna de toneladas;
- escrevam que nomes mudaram ao importar.
Se algum número parecer estranho, voltem às primeiras linhas em bruto.
Exercício Dois
20 minutos · pares
Usem bryozoan_raw.csv, com dados de duas espécies de briozoários, estádios, corridas e colunas logarítmicas:
- leiam o ficheiro com
read.csv(); - usem
str()etable()para ver os estádios das duas espécies; - confirmem que as colunas logarítmicas são numéricas;
- escrevam a frase: o que é uma linha deste ficheiro?
Uma linha é um indivíduo, uma corrida ou uma medição repetida? A resposta muda o que podem contar.
Antes de Exportar
- O original continua intacto?
- As transformações estão escritas no script?
- O novo ficheiro tem outro nome e outra pasta?
Próximo Passo
campo → ficheiro → memória → análise → resultado recriável